过去两年里,AI 辅助编程工具已经从早期尝鲜者的玩具,演进为现代软件工程工具链的基础设施。无论是在编辑器内置的代码补全、侧边栏对话,还是能够跨文件执行变更的自主编程代理(Coding Agents),几乎每个开发者都在日常工作中高频使用它们。
然而,团队内部的实际体感往往呈现出两极分化:一部分开发者感觉如虎添翼,日常原型搭建和样板代码交付提速数倍;另一部分开发者却常常陷入沮丧——“AI 写的代码第一眼看上去很美,一跑全是暗坑;让它修复一个 Bug,它顺手改崩另外三个地方;对话进行到第十轮,项目已经变成了谁也读不懂的混乱泥潭。”
产生这种差距的核心根源,往往不是大模型底层推理能力的微小波动,而是人类开发者在使用 AI 时的工程范式与协作习惯。很多时候,人们试图用对待通用搜索引擎或聊天机器人的方式去操作 AI 编程工具,忽视了软件系统天生的高内聚、低耦合、强类型约束与确定性交付原则。
本文从一线高强度工程交付实践中提炼出 7 条真正能显著提升 AI 编程产出质量的核心习惯,并配套提供结构化对比表、实战提示词模板与上线自检清单,帮助你建立一套可复制、高可靠的现代化 AI 协同开发工作流。
协作范式全景:从盲目生成到确定性交付
要用好 AI 编程工具,首先需要完成一次角色认知的彻底重构:不要把 AI 视作无所不知的软件架构师,而应当把它当成一位执行速度极快、精通各种编程语言语法、但严重缺乏全局上下文与架构自律性的高级初级工程师(Junior Developer)。
作为人类工程师,你的核心职责并不是逐行敲击样板语法,而是扮演首席系统架构师、规格制定者与终审代码把关人。你负责提供干净的上下文环境、定义清晰的接口契约、划定最小任务边界,并在最后一道关口对生成的代码实施确定性测试与严格的代码审查。
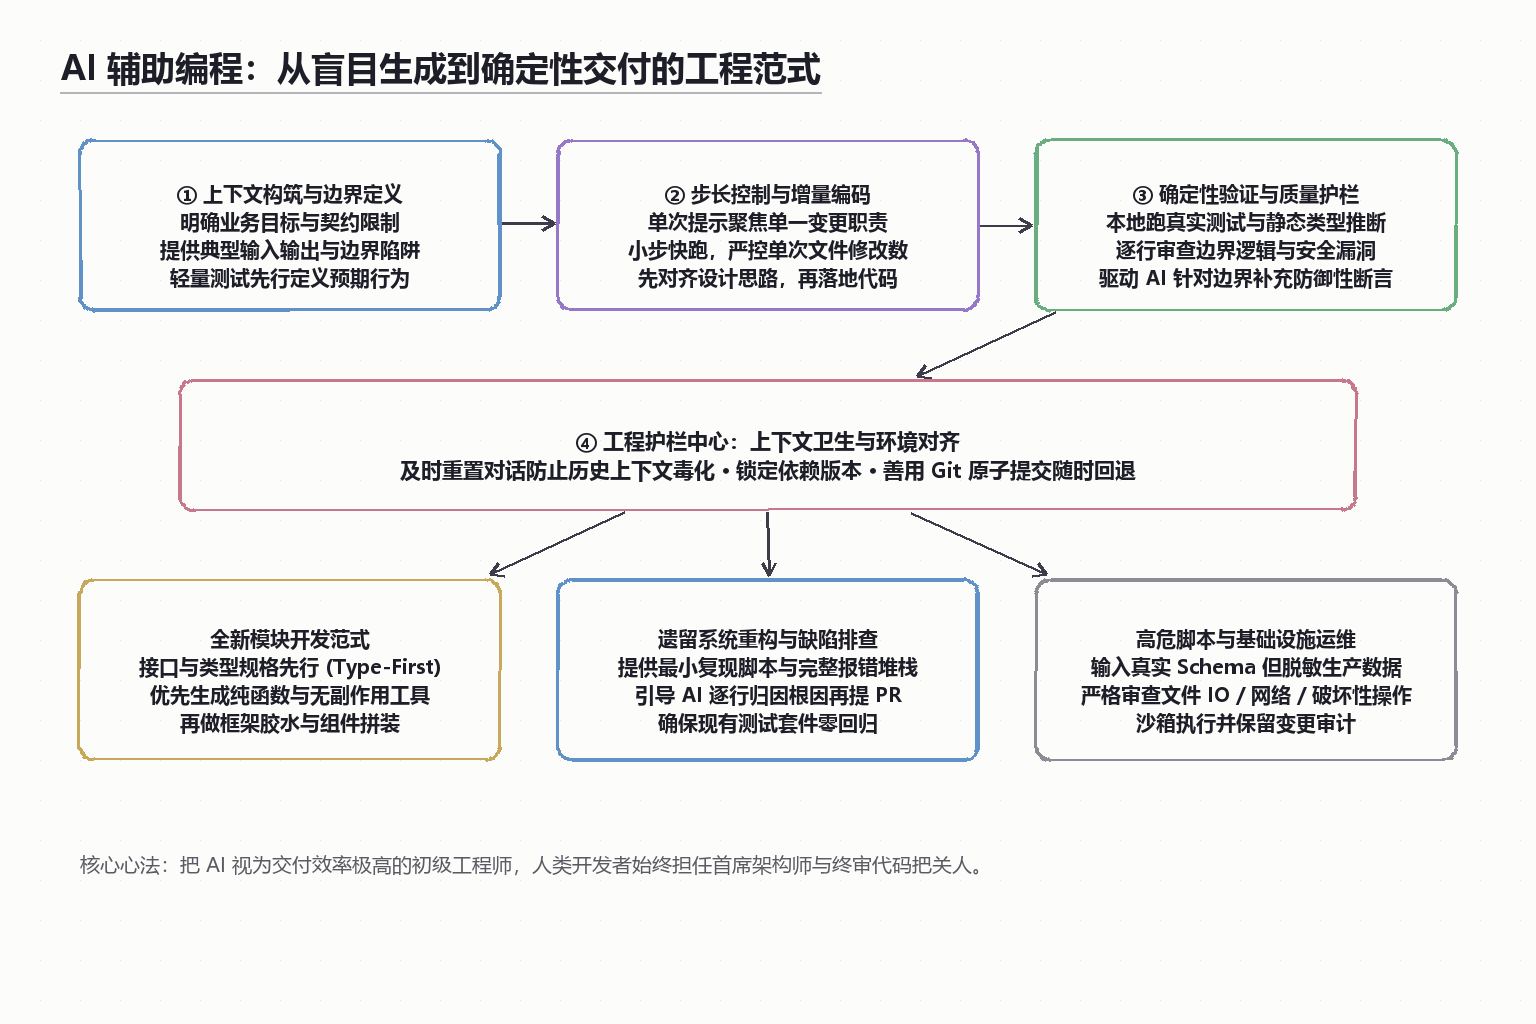
为了更直观地理解工程化协同与盲目生成的本质区别,我们先通过下表对三种典型的研发姿态进行全面横向对比:
| 评估维度 | 传统纯手工编程 | 盲目 AI 编程(高翻车率) | 工程化 AI 编程(推荐范式) |
|---|---|---|---|
| 心智焦点 | 语法细节、API 拼写、样板代码 | 催促模型、肉眼排查幻觉、焦躁改错 | 契约设计、架构边界、测试验证 |
| 任务颗粒度 | 函数/类级别逐步编写 | 一句话要求实现一整个庞大功能模块 | 单一职责拆解,严格控制单次文件变动 |
| 上下文供给 | 存放在人类大脑工作记忆中 | 随意粘贴海量代码,任由对话历史无限累加 | 精准注入核心定义,定期重置上下文保持干净 |
| 类型与契约 | 边写实现边补全类型 | 允许 AI 随意猜测松散数据结构 | Type-First,类型与规格先行确立 |
| 验证手段 | 编写单元测试或手动断言 | 肉眼扫一遍代码,直接复制到生产环境 | 自动化测试、静态类型推断与编译双重约束 |
| 变更掌控力 | 完全掌控每一行改动 | 不清楚改动了哪些文件,盲目接收 Diff | 每次提交严格原子化,利用 Git Diff 逐行审阅 |
| 外部依赖 | 谨慎引入经过社区检验的包 | 接受 AI 随手编造或过期的冷门依赖 | 严格锁定技术栈选型,对新包实施零信任核查 |
| 长期维护成本 | 架构一致,但前期开发速度慢 | 技术债务急剧堆积,后期无人敢动 | 兼具高速交付与清晰架构,可维护性强 |
习惯一:契约与类型先行(Type-First & Schema First)
在软件工程中,数据结构决定了逻辑流转的方式。很多开发者在使用 AI 时常犯的第一个错误,是直接向模型下达大段模糊的自然语言业务诉求,例如:
❌ 反面示范:“帮我写一个订单结算服务,计算商品折扣、运费,判断用户是不是 VIP,然后生成扣款记录并更新库存。”
面对这种需求,大模型为了在概率分布上迅速给出回应,不得不自主臆测输入参数的命名、金额的数据类型(浮点数还是整型分为单位)、商品项的字段结构以及异常返回的格式。结果往往是代码逻辑看似通顺,但与你现有系统的已有模型格格不入。
落地方法论:用类型固化业务契约
最有效的提示词不是堆砌形容词,而是给出精确的类型定义。 在要求 AI 实现具体算法或控制器之前,先明确声明输入、输出与中间状态的接口契约。例如在 TypeScript 或 Python 中:
// ✅ 步骤 1:先让 AI 或自己确立核心契约类型,不涉及任何实现细节
export interface CartItem {
  readonly skuId: string;
  readonly unitPriceCents: number; // 严格以分为单位,杜绝浮点精度陷阱
  readonly quantity: number;
}

export interface UserContext {
  readonly userId: string;
  readonly isVip: boolean;
  readonly availableCouponIds: readonly string[];
}

export interface SettlementResult {
  readonly subtotalCents: number;
  readonly discountCents: number;
  readonly shippingFeeCents: number;
  readonly payableTotalCents: number;
  readonly appliedCouponId: string | null;
}

export type SettlementError =
  | { code: 'EMPTY_CART'; message: string }
  | { code: 'INVALID_QUANTITY'; skuId: string }
  | { code: 'COUPON_EXPIRED'; couponId: string };
当你把这段类型定义直接作为上下文喂给 AI,并附带指令:
“请基于上述接口契约,编写计算结算结果的纯函数
calculateSettlement(items: CartItem[], user: UserContext): Result<SettlementResult, SettlementError>。要求:纯函数实现,无网络或数据库副作用,严格处理边界溢出与非法数量。”
AI 输出的代码准确度会瞬间跃升一个数量级。因为严格的类型系统收敛了概率发散的空间,给模型设定了坚不可摧的“语义轨道”。
习惯二:小步快跑与严格的原子步长(Single Responsibility Prompting)
软件设计领域著名的单一职责原则(SRP),在 AI 协同编程时代同样是黄金法则。
许多初学者容易产生一种过度乐观的“一揽子委托”心态,试图在一个 Prompt 中完成:数据库表设计、ORM 映射、Service 业务逻辑、Controller 路由、参数校验中间件以及前端页面交互。这种跨越多个抽象层次的大步长任务,极易引发致命连锁反应:
- Token 限制与截断:由于模型单次最大输出长度有限,代码经常在关键逻辑处戛然而止;
- 上下文注意力分散:模型顾及了前端界面的 CSS 细节,就会遗漏后端事务的异常回滚;
- Debug 噩梦:一旦最终联调失败,你面对的是 8 个文件同时出现的 500 行全新代码,根本无从排查到底哪一步出了偏差。
落地方法论:将大任务拆解为 4 阶原子步长
高效的做法是将复杂需求拆分成具备明确输入输出依赖的原子子任务,分批驱动 AI 交付:
[步骤 A:数据结构与领域契约设计]
       ↓ (人类审阅通过并冻结)
[步骤 B:核心业务计算与纯逻辑单元]
       ↓ (跑通本地单元测试)
[步骤 C:持久化存储与外部 API 适配器]
       ↓ (完成 Mock 集成验证)
[步骤 D:控制器路由编排与端到端异常转换]
每一个步骤执行完成后,立即在本地环境中执行静态语法检查和格式化。如果步骤 B 出现了逻辑偏差,你在当前步就能立刻发现并就地纠正,绝不把上游的认知噪音传递给下游组件。
习惯三:测试驱动与断言先行(TDD 的 AI 时代文艺复兴)
传统的测试驱动开发(TDD)在过去常被部分工程师抱怨“心智负担重、前期写测试耗时太长”。然而在 AI 时代,TDD 迎来了它的黄金时代,变成了性价比最高的开发加速器。
大模型最擅长根据清晰的输入输出用例编写通过代码;反过来,它也极擅长根据你的业务规则枚举出周密的测试矩阵。
落地方法论:“规格-测试-实现-绿灯”四步闭环
与其在聊天框里反复用口头语言向 AI 解释“第 35 行代码在遇到空数组时报错了”,不如直接向其提供包含确定断言的测试用例:
# 先提供包含正常值、边界值与防御性异常的测试套件
import pytest
from payment_calc import calculate_tier_discount

def test_standard_tier_zero_discount():
    assert calculate_tier_discount(amount=100_00, user_level=1) == 0

def test_gold_tier_percentage_discount():
    assert calculate_tier_discount(amount=200_00, user_level=3) == 20_00

def test_negative_amount_raises_value_error():
    with pytest.raises(ValueError, match="Amount must be positive"):
        calculate_tier_discount(amount=-1, user_level=1)

def test_boundary_zero_amount():
    assert calculate_tier_discount(amount=0, user_level=2) == 0
提示词只需极为简短的一句话:
“请编写
calculate_tier_discount函数的完整实现,确保能够全部通过上述测试用例。禁止修改既有测试文件中的断言规则。”
这带来两个无与伦比的优势:
- 客观的裁判标准:是否完成任务,不再依赖人类的肉眼主观扫描,而是由本地运行的测试测试套件(如
pytest或jest)客观判定。 - 自动迭代修正:若本地测试报错,直接将真实的 CLI stderr 复制喂回给 AI,AI 能够根据堆栈追踪实现近乎 100% 命中的一次性修正。
习惯四:保持上下文卫生(Context Hygiene)
许多开发者都有过类似经历:当与编程助手连续在一个会话里交互了十几轮之后,AI 突然开始“退化”——它开始重复之前已经被推翻的错误方案、遗忘一开始强调的核心架构规范、或者无缘无故地在生成的代码里引入莫名其妙的旧变量名。
这是由于大模型的注意力机制受到长上下文污染(Context Pollution)所致。对话历史中堆积了大量已经废弃的中间报错、废弃的代码片段、以及无意义的调试日志。这些信息充斥在提示词的前置记忆中,严重干扰了模型的自注意力权重分配。
落地方法论:上下文管理的“三不原则”与基石文件
不恋战:出现两次以上思路偏离立刻重置
如果在某个具体实现上你连续纠正了 AI 两次,它依然未能给出正确答案,请坚决点击“新建对话(New Chat)”。把当前代码中最精华的部分和最新提炼的问题重新整理成一段紧凑的初始 Prompt。带着包袱继续纠缠只会加速走向混乱。不滥投:按需喂入最小相关上下文
不要把无关的数百行工具函数或整个项目代码打包贴入对话框。每次提问前,只提供当前函数依赖的直接接口定义和类型签名。保持 Prompt 的信噪比在 80% 以上。固化项目基石规范(Rules for AI)
在项目根目录维护专门供 AI 编程助手读取的工程规范文件(如.cursorrules、CLAUDE.md或AGENTS.md)。在其中明确固化以下不可动摇的底线规则:- 使用的技术栈版本与推荐库(例如:必须使用 Node 20 原生 fetch,禁止引入 axios);
- 代码风格与错误处理范式(例如:禁止使用
try-catch默默吞并异常,必须返回显式 Result 对象); - 依赖安装权限(例如:未经明确允许,禁止在
package.json中添加任何未经许可的外部三方依赖)。
习惯五:倒逼 AI 先阐述设计思路(Think Before Code)
面对一个非平凡(Non-Trivial)的工程问题时,很多人的本能指令是:“直接给我全部完整的实现代码”。
这种做法直接跳过了大模型的链式思考(Chain of Thought)过程。让模型在极短的推理步长内直接预测最终代码字符,其容错率极低。一旦初始方向稍微发生偏移,后续数百行代码就全成了废品。
落地方法论:强制执行“方案评审与对齐”工序
在要求生成实际变更代码之前,强制 AI 执行方案推导阶段。你可以使用如下结构化提问模板:
高效提示词模板:
“我们准备在当前模块中引入限流器机制(Rate Limiter)。
在输出任何具体代码之前,请先回答以下三点:
- 列出你推荐的 2 种不同算法实现(如令牌桶 vs 滑动窗口),并用表格对比它们的内存开销与抗突发流量特性;
- 阐述该变动需要改动当前项目的哪些现有文件,新增哪些文件,各自职责是什么;
- 列出可能存在的 3 个潜在并发竞态问题,以及你打算如何进行防御。”
通过这一步,你能够在数秒钟之内快速审阅 AI 的系统设计方案:
- 如果它的方案选型存在硬伤(例如在分布式环境下误选了本地单机内存结构),你可以在方案阶段只用一句话将其纠偏;
- 如果方案完全符合你的架构预期,再输入简短的“方案批准,请按照第二种方案开始编写代码”。
在草稿纸上修改设计的成本,永远只有在完整代码里返工的百分之一。
习惯六:对第三方依赖与安全边界保持零信任(Zero Trust Audit)
AI 编程助手生成的代码具有极高的欺骗性:它们语法工整、缩进完美、注释详尽,甚至连变量命名都挑不出毛病。但正因如此,人类开发者最容易在审查时丧失戒心。
实际生产中,AI 自动生成的代码潜藏着三大致命的安全盲区:
1. “包名幻觉”(Package Hallucination)
大模型在遇到特定小众功能时,可能会凭借语义联想随机“捏造”一个看似合乎规范的依赖包名(例如 react-smart-virtual-scroller-v2)。如果开发者未经审查直接执行 npm install 或 pip install,可能遭遇黑客预先抢注同名恶意包所发起的依赖混淆或供应链投毒攻击。
2. 隐蔽的逻辑缺陷与并发漏洞
AI 往往倾向于编写“理想快乐路径(Happy Path)”代码。它生成的并发代码经常缺少互斥锁(Mutex)、缺少数据库行级锁或乐观锁校验、或者在异步回调中引发未处理的内存泄漏。
3. 过时的安全规范与敏感凭证泄露
如果底层模型的训练语料包含较多老旧项目代码,它可能会给出早已被弃用的加密算法(如 MD5 存储密码)、直接在代码中拼接 SQL 字符串、或者下意识地给出一个模拟的真实环境变量前缀。
落地方法论:AI 交付代码 5 项零信任审查表
每次将 AI 产出的代码合并到主干或提交 PR 之前,对照下表进行机械化自检:
| 审查项 | 风险场景 | 验证动作与阻断标准 |
|---|---|---|
| 外部依赖真伪 | AI 虚构或推荐冷门三方包 | 必须在官方包管理器(npm/PyPI/Go Module)核验周下载量、维护者背景及开源协议。 |
| SQL 与命令构造 | 字符串格式化拼接引发注入漏洞 | 严禁拼接变量,必须使用参数化查询(Parameterized Queries)或类型安全的 Query Builder。 |
| 异常捕获完整性 | 滥用无差别 catch(e) {} 掩盖真因 |
检查所有错误捕获块,确保有结构化日志输出或合规的异常向上传播。 |
| 并发与事务控制 | 跨多表变更时缺少事务包裹 | 涉及资金、库存、状态机变更的场景,必须显式包裹在 DB Transaction 并在失败时自动回滚。 |
| 硬编码与凭证 | 本地测试临时硬编码 Token/Key | 全局搜索 Bearer、SECRET、127.0.0.1,确保所有敏感配置严格由环境变量或保密中心注入。 |
习惯七:Git 充当防翻车的版本控制安全垫
在与具备多文件编辑能力的 AI 代理协同工作时,最恐怖的灾难莫过于:你原本的工作区里有若干未提交的改动,AI 经过一番搜索与编辑后,直接修改了 14 个文件,其中不仅包含了你需要的功能,还自作聪明地修改了你的代码格式、重构了旧公共函数,导致整个项目彻底无法编译。
此时由于你原有的改动与 AI 的改动混合在一起,执行 git reset 会丢掉自己的工作,不回滚又根本无法理清头绪。
落地方法论:原子化 Git AI 协同三部曲
与 AI 展开任何非平凡代码交互时,严格遵守以下操作纪律:
① 确认干净工作区
   git status  --> 必须无未暂存的脏代码;必要时先 git stash 或新建 feature 分支

② 驱动 AI 实施原子变更
   AI 完成单点任务 --> 立即在终端执行 git diff 逐行审阅

③ 验证并固化快照
   跑通测试与构建 --> git add -A && git commit -m "feat: 由 AI 生成的结算核心逻辑"
这套纪律赋予你无所畏惧的“试错撤销权”:
- 只要 AI 的修改方向跑偏,你可以毫无心理负担地执行一行
git checkout -f瞬间还原现场; - 每次 commit 都是一次清晰的里程碑。如果后续需要微调,版本历史清晰可查,Code Review 也变得极其高效。
常见研发场景:高命中率提示词模板库
为了让上述方法论能够直接无缝融入你的日常工作,以下整理了四类最高频开发场景的即插即用提示词模板:
场景 A:新功能模块创建(绿地开发)
角色:高级系统工程师
任务:为当前系统实现一个【邮件发送重试调度器】。

约束条件:
1. 语言与运行时:TypeScript / Node 20 原生环境。
2. 依赖限制:仅可使用系统内置模块,禁止引入未经批准的三方重试库。
3. 契约要求:
   - 先行声明调度器配置项接口 `RetryOptions`(包含最大尝试次数、退避基数与抖动参数)。
   - 编写纯逻辑退避计算函数 `calculateBackoff(attempt: number, options: RetryOptions): number`。
4. 交付顺序:
   第 1 步:仅输出接口定义与核心类型,等待我的确认。
   第 2 步:待确认后,输出该模块的完整单元测试套件。
   第 3 步:最后输出满足测试的具体实现代码。
场景 B:疑难 Bug 排查与根因分析
背景:我们在生产环境中遇到偶发性空指针异常,报错堆栈如下:
【此处粘贴真实的报错日志与关键调用栈信息】

相关源码上下文:
【此处仅粘贴堆栈所涉及的 1-2 个关键类/函数】

请按以下格式回答:
1. 根因推导:该异常在什么特定的并发条件或边界入参下会被触发?
2. 最小复现用例:请编写一个能够稳定重现该 Bug 的最小测试用例。
3. 修复方案比较:提出至少 2 种修复思路,并说明哪种方案对既有代码的入侵性最小。
4. 在我明确批准前,请不要输出完整的重写代码。
场景 C:遗留代码重构与性能调优
任务:重构以下现有数据清洗函数,目标是降低其时间复杂度与内存占用。

现有代码:
【此处粘贴待重构的旧代码段】

重构硬性规则:
1. 外部接口与返回值必须保持 100% 向后兼容,禁止修改函数签名。
2. 保证无副作用,所有中间状态使用局部不可变变量。
3. 提供重构前后的复杂度理论对比(Big-O 表述)。
4. 先提供能够覆盖现有业务逻辑的基准回归测试用例,再给出重构后的实现。
终局自检:AI 协同研发效能 12 项检查清单
在结束日常开发并将代码合并进团队仓库之前,请花 2 分钟对照这份检查清单自测:
- 契约先行:所有涉及跨模块调用的接口,是否都具备显式、严格的类型或数据结构定义?
- 单一职责:本次修改的范围是否严格聚焦在当前单一任务内?(单次变更文件数通常不超过 3 个)
- 断言覆盖:是否针对本次新增的核心逻辑在本地运行并通过了自动化单元测试?
- 边界防护:对于空入参、非法入参、网络超时与空数组等边界情况,是否有明确防御断言?
- 上下文清晰:当前会话是否保持干净?是否在重大逻辑切换时及时重置了对话?
- 设计审阅:在生成大段代码前,是否由人类确认并对齐了架构思路?
- 依赖零信任:代码中引用的所有外部依赖是否都是成熟、知名且在官方源上可查的有效包?
- 安全审计:代码中是否存在任何 SQL 拼接、未转义的 HTML 渲染、硬编码凭证或被吞掉的异常?
- 事务完整:对于涉及持久化状态流转的操作,是否包裹在一致性事务之中?
- 可读性保全:生成的代码是否遵循了项目整体的命名与分层规范,而不是突兀的模型风格?
- 原子化提交:本次提交在 Git 历史中是否可以独立编译并通过全部测试?
- 掌控力确认:作为提交者,你能否合上电脑后向队友清晰解释本次变动的每一行代码逻辑?
结语:让工具归位,让人类升维
AI 编程助手从来不是“免死金牌”,更不能替代工程师自身的底层计算机科学素养。相反,它像一面极其灵敏的放大镜——如果你缺乏清晰的工程规范与架构思维,AI 只会以光速帮你堆砌出不可维护的数字废墟;而一旦你掌握了规范的上下文管理、契约设计与确定性验证习惯,AI 就会化为你最强大的技术杠杆,将你的思考密度直接转化为坚固、优雅的生产力成果。
从今天开始,不妨从下一次打开编辑器做起:先写类型,小步快跑,让测试作为裁判,把稳 Git 的方向盘。你会发现,代码质量与交付速度这对长久以来的矛盾体,终于在科学的工程范式下达成了默契的统一。
如果你在团队中推行 AI 辅助开发规范、架构落地或代码质量治理过程中遇到了具体的挑战,欢迎前往 联系与交流 页面,与我们探讨更多关于现代研发效能与工程工程实践的深度话题。