在软件工程中,任何一项新技术的采纳,几乎都会经历一段“从野蛮生长到工程收敛”的必经之路。
当团队第一次接触大语言模型(LLM)时,开发者通常会在十几分钟内写出一个 Python 脚本,调用几行官方 SDK,将一段提示词送入模型,并惊叹于其生成的代码或分析结果。在这个阶段,大家谈论的是模型的“神奇表现”与“原型速度”。
然而,一旦这套逻辑被要求接入真实的生产业务——例如电商后台的客服辅助、代码审查机器人的 CI 流水线、或者是面向企业客户的智能分析报表系统时,整个技术团队就会迅速遭遇残酷的工程现实:
- 稳定性挑战:第三方大模型服务偶发 429 速率限制(Rate Limit)或 500/503 内部故障,导致主干业务线程卡死、级联超时乃至服务雪崩;
- 厂商锁定与迁移困难:代码各处分散调用了不同厂商独有的 SDK,当新一代高性价比模型发布或特定供应商网络抖动时,团队根本无法无缝切换;
- 成本失控与算力黑盒:财务收到数万元的 API 账单,却查不出究竟是哪个微服务、哪个业务线、因为什么死循环调用消耗了大量 Token;
- 安全性与数据合规:API Key 散落在各个项目的配置文件甚至环境变量中,内部敏感代码和客户个人信息(PII)在未经任何脱敏的情况下被直接送入了公网接口;
- 输出不可控:模型偶尔吐出截断的 JSON、包含多余解释性 Markdown 的文本,直接导致下游解析服务抛出异常。
软件架构的核心目标永远是管理复杂度与解耦变化。AI 能力作为一种具备“长耗时、高并发限制、非确定性输出、按 Token 计费”特征的特殊外部依赖,绝不能随意塞进业务代码中。
本文将系统梳理当前业界将 AI 工具与大模型集成到现代技术栈中的四种主流演进模式:从最轻量的脚本直接调用,到微服务层面的封装适配,再到跨团队的统一 AI 网关,最终迈向企业级智能体平台化接入。我们将深入解析每种模式的核心架构、适用边界、代码实践与避坑要点,为你的团队提供一份可落地的演化决策指南。
全景对比:四种集成模式的核心特征与选型雷达
在深入每种模式的实现细节前,我们先建立一个全局技术雷达。软件架构没有“最好”,只有“当前约束下的最匹配”。
| 评估维度 | 模式一:脚本与点状直调 (Direct Scripting) | 模式二:服务层内部封装 (Service Wrapper) | 模式三:集中式 AI 智能网关 (Unified AI Gateway) | 模式四:平台化与智能体运行时 (Enterprise AI Hub) |
|---|---|---|---|---|
| 架构拓扑 | 业务代码直接依赖厂商 SDK,点对点分散直连 | 内部微服务/模块封装统一 Client 适配器 | 独立中间代理集群(反向代理/API 网关) | 统一模型中心 + 知识库 + 工具 Hub + 调度引擎 |
| 接入成本与周期 | 极低(数分钟至数小时) | 较低(1-3 天) | 中等(1-2 周部署配置) | 高(数周至数月系统工程) |
| 厂商解耦程度 | 强绑定,更换模型需全量修改代码 | 代码级解耦,通过适配器模式实现替换 | 协议级解耦,全链路统一 OpenAI 规范 | 平台级解耦,支持模型、工具、提示词完全解耦 |
| 高可用与容灾 | 无,遇 429/500 直接向上传播报错 | 具备代码级重试、超时与 Fallback 降级 | 具备跨供应商自动故障转移与权重负载均衡 | 全链路健康检查、弹性切流与人机在环兜底 |
| 成本管控粒度 | 完全失控,无法按业务细分统计 | 局部日志打印,需手动汇总分析 | 租户级 Quota 限额、Token 级财务账单分摊 | 精准到应用、用户、对话的细粒度成本全景归因 |
| 性能加速能力 | 无,每次必须走公网全量模型推理 | 本地简单内存/Redis 基础缓存 | 全局分布式语义缓存(降低相似请求开销) | 多级语义缓存 + 上下文精简 + 批处理调度优化 |
| 安全与权限隔离 | 高危,Key 分散各处,无内容审查 | 环境变量统一管理 Key,业务层局部脱敏 | 统一 Key 托管脱敏,前置注入检测与限流 | 统一鉴权(ABAC/RBAC)、PII 实时脱敏、护栏合规 |
| 典型适用场景 | 敏捷原型 PoC、黑客松、离线批处理脚本 | 单一主干系统规范化集成 AI 功能 | 中大型团队、多微服务共享算力、高并发业务 | 全企业级 AI 战略落地、复杂 Agent 工作流编排 |
下图清晰地展示了从单点点状直调逐步演化为企业级 AI 平台的架构跃迁路径与核心技术底座:
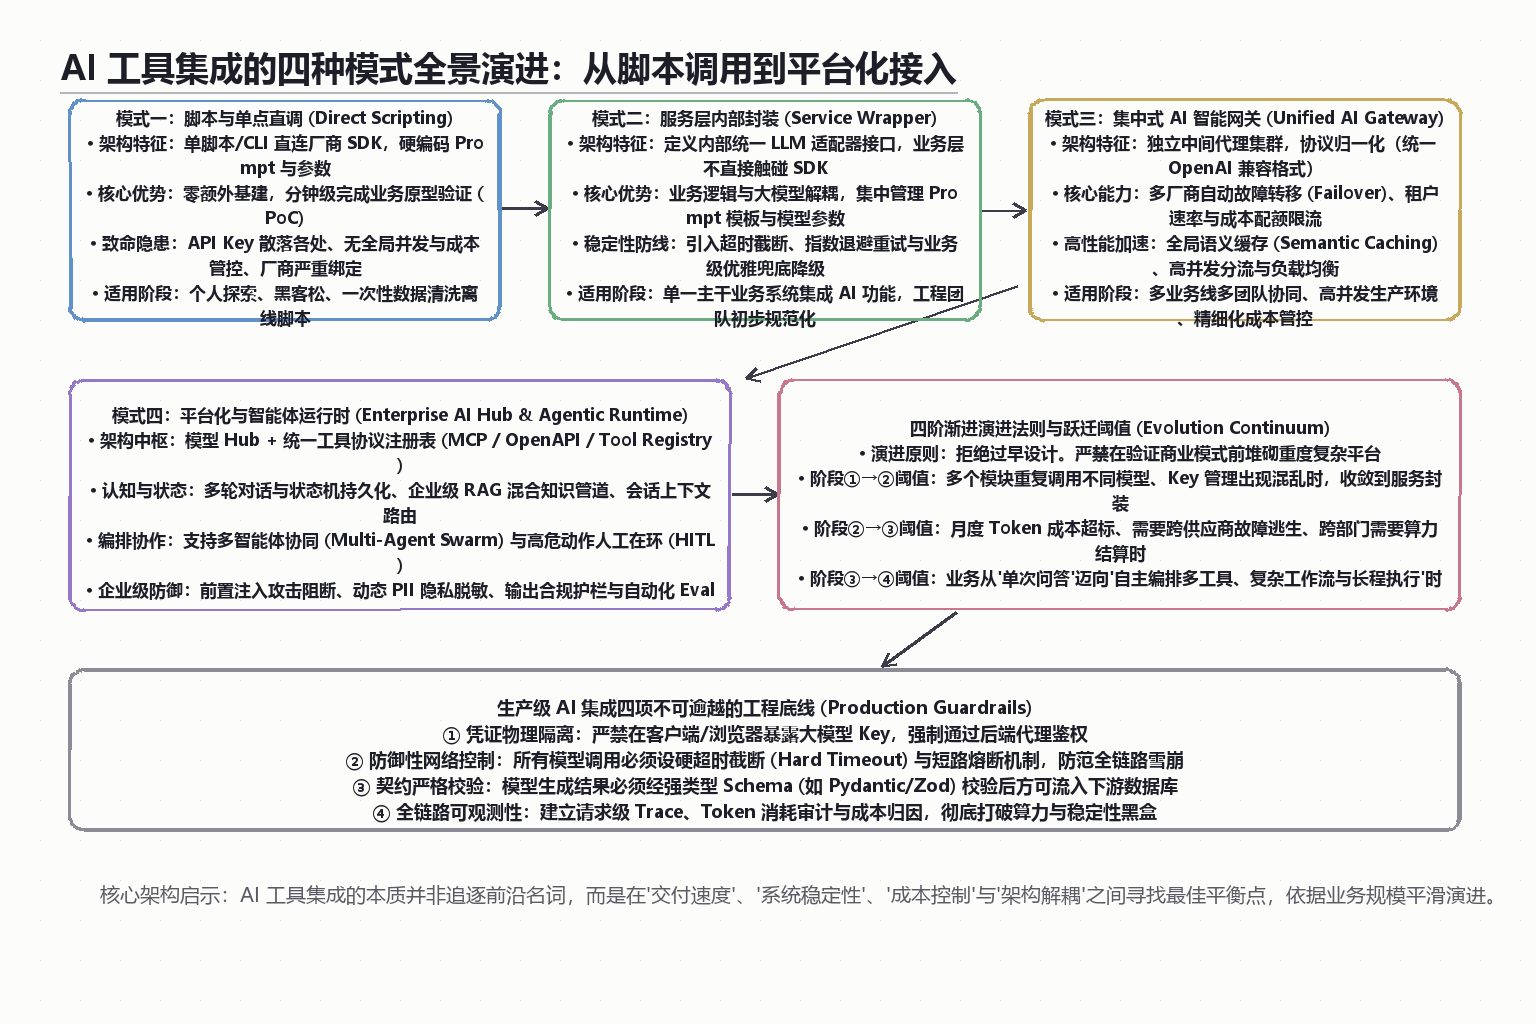
接下来,我们依次拆解这四种模式的实现细节、架构原理与生产实战代码。
模式一:脚本与点状直调(Direct Scripting)
1. 架构本质与实现形式
模式一是最直接、也是绝大多数工程师迈入 AI 领域的起点。其核心逻辑可以概括为:“需要什么,就在当前代码文件里直接引入 SDK 并调用”。
在 Python 脚本、CLI 命令行工具、或是某个一次性的数据迁移脚本中,开发者直接安装厂商提供的官方包(如 openai、anthropic 或 google-genai),在代码头部读取环境变量或硬编码 API Key,直接构造 Client 并发起请求:
# 模式一典型代码示例:点状脚本直接调用
import os
from openai import OpenAI

client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))

def extract_summary(raw_text: str) -> str:
    response = client.chat.completions.create(
        model="gpt-4o",
        messages=[
            {"role": "system", "content": "你是一个专业摘要助手。"},
            {"role": "user", "content": f"请为以下内容提取三句核心摘要:\n{raw_text}"}
        ],
        temperature=0.3
    )
    return response.choices[0].message.content
2. 为什么不要全盘否定模式一?
在技术讨论中,很多架构师容易陷入“唯完美架构论”,认为任何不经过中间件封装的代码都是“技术垃圾”。然而在实际工程生命周期中,模式一有其不可替代的核心价值:
- 极速验证产品假设(PoC):在产品方向尚未被市场验证之前,花费两周时间搭建 AI 网关和配置中心纯属资源浪费。脚本直调能让团队在半天内跑通最小可行性原型(MVP)。
- 离线与一次性工程任务:例如需要对历史积累的 5000 条遗留客户工单进行一次性打标清洗,写一个断点续传的单文件 Python 脚本直接并发调用大模型,跑完任务即可归档,没有必要强加复杂分层。
- 本地开发者小工具:例如研发内部用于快速根据 Git Diff 生成 Commit Message 的终端脚本,简单自足的单点调用效率最高。
3. 迈入生产环境的五大致命缺陷
然而,一旦模式一的代码被原封不动地带入主干生产代码库,它很快就会演变为系统的“定时炸弹”:
- 凭证泄露与密钥治理失控:不同开发者在各自的代码模块中声明 Client,随着代码演进,API Key 极易被不小心硬编码进提交历史,甚至暴露在面向公网的前端页面或移动端代码中。
- 缺乏防雪崩机制:云端大模型并非 100% 可用。当遇到网络抖动、模型服务过载(429 Too Many Requests)或偶发服务器错误(500/502/503)时,脚本直接抛出未捕获异常,导致主业务线程崩溃;若外部存在简单的死循环重试,又会在短时间内打满配额,引发剧烈的雪崩效应。
- 严重的厂商与模型强绑定:各家大模型的 SDK 接口定义、输入结构、输出对象各不相同。如果把
response.choices[0].message.content散落在几十个业务文件中,一旦需要切换到 Claude、DeepSeek 或自建开源模型,全量修改代码的代价和回归测试成本高得难以承受。 - 财务成本与配额黑盒:当月底大模型 API 账单暴涨时,运维和财务完全无法从后台数据中定位是哪个微服务、哪位工程师的代码在无节制消耗 Token。
- 模型输出非确定性引发的系统崩溃:大模型的输出具有概率性,即使在 Prompt 中严格要求“只输出 JSON,不要任何 Markdown 标记”,模型在特定上下文下仍可能输出带有
```json甚至自然语言前缀的内容。裸露的脚本如果没有严苛的结构化提取和兜底校验,下游业务反序列化时将必然报错。
4. 迁移信号:什么时候必须告别模式一?
当你的系统出现以下三个信号之一时,说明模式一已无法承载业务,必须进行架构跃迁:
- 出现两个以上的模块或服务需要调用大模型,且 Prompt 和参数各写各的;
- 系统发生过因大模型接口超时导致核心接口阻塞超过 30 秒的线上告警;
- 团队开始需要考虑更换模型或引入更低成本的模型进行场景分流。
模式二:服务层内部封装(Service Wrapper Pattern)
1. 架构本质与核心思想
模式二的核心思想是:“将大模型视为一种标准的不可靠外部第三方微服务,通过适配器模式(Adapter)和门面模式(Facade)在业务层下方建立防腐层(Anticorruption Layer)”。
在这一模式下,普通业务代码严禁直接引入任何具体大模型厂商的 SDK。所有的模型调用必须经过团队内部统一定义的抽象服务接口(如 LLMService 或 ModelOrchestrator)。
+-----------------------------------------------------------+
|                      业务逻辑层 (Business Layer)            |
|       (用户对话服务 / 自动打标服务 / 智能搜索路由服务)         |
+-----------------------------------------------------------+
                              |
                              v  (强类型契约,如 Pydantic/Zod)
+-----------------------------------------------------------+
|                   内部服务封装层 (LLM Wrapper Layer)        |
|  - 统一配置与密钥管理       - Prompt 模板集中治理          |
|  - 指数退避重试 (Backoff)   - 业务级优雅降级 (Fallback)    |
|  - 硬超时截断 (Timeout)     - 强类型 Schema 解析与自愈      |
+-----------------------------------------------------------+
         |                                    |
         v                                    v
+-----------------------+            +----------------------+
| 厂商适配器 A (OpenAI) |            | 厂商适配器 B (Claude)|
+-----------------------+            +----------------------+
2. 生产级封装的三大支柱
一个合格的服务级封装必须具备以下三道防线:
- 支柱一:协议抽象与模型无关性(Model Agnostic):定义标准化的输入对象(如
LLMRequest)与输出对象(如LLMResponse)。无论底层调用的是哪个供应商,向业务层吐出的都是统一的结构体,抹平各家 SDK 的命名差异。 - 支柱二:容错与防御性重试(Defensive Resilience):网络请求必须设置绝对硬超时(Hard Timeout),对瞬时网络抖动和 429 实施带有随机抖动的指数退避重试(Exponential Backoff with Jitter),当主模型在重试阈值内仍无法响应时,自动触发业务级降级逻辑(例如切换备用轻量模型,或返回预设的安全兜底文案)。
- 支柱三:输出结构强校验与自愈(Schema Self-Healing):利用 Pydantic 等强类型工具对模型返回进行即时校验。如果解析失败,在封装层内部提供轻量级的就地修补或快速反问修正,杜绝脏数据流入业务层持久化存储。
3. 生产级代码实战:可复用的 Python 适配器层
下面是一套经过工业级实践检验的模式二核心骨架。它实现了统一的调用契约、超时保护、退避重试以及备选模型平滑降级(Fallback):
import os
import time
import logging
from abc import ABC, abstractmethod
from typing import List, Dict, Any, Optional
from pydantic import BaseModel, Field

logging.basicConfig(level=logging.INFO)
logger = logging.getLogger("LLMWrapper")

# 1. 统一定义输入与输出契约
class Message(BaseModel):
    role: str
    content: str

class LLMRequest(BaseModel):
    messages: List[Message]
    temperature: float = 0.2
    max_tokens: int = 1500
    timeout_seconds: float = 15.0

class LLMResponse(BaseModel):
    content: str
    prompt_tokens: int
    completion_tokens: int
    total_tokens: int
    model_name: str
    latency_ms: float

# 2. 供应商抽象接口
class BaseLLMProvider(ABC):
    @abstractmethod
    def generate(self, request: LLMRequest) -> LLMResponse:
        pass

# 3. 具体供应商实现 (以 OpenAI 协议为例)
class OpenAICompatibleProvider(BaseLLMProvider):
    def __init__(self, api_key: str, base_url: Optional[str] = None, model: str = "gpt-4o"):
        from openai import OpenAI
        self.model = model
        self.client = OpenAI(api_key=api_key, base_url=base_url)

    def generate(self, request: LLMRequest) -> LLMResponse:
        start_time = time.time()
        # 严格执行请求硬超时
        response = self.client.chat.completions.create(
            model=self.model,
            messages=[m.model_dump() for m in request.messages],
            temperature=request.temperature,
            max_tokens=request.max_tokens,
            timeout=request.timeout_seconds
        )
        latency = (time.time() - start_time) * 1000.0

        usage = response.usage
        return LLMResponse(
            content=response.choices[0].message.content or "",
            prompt_tokens=usage.prompt_tokens if usage else 0,
            completion_tokens=usage.completion_tokens if usage else 0,
            total_tokens=usage.total_tokens if usage else 0,
            model_name=self.model,
            latency_ms=latency
        )

# 4. 带有容灾重试与备用降级的高可用服务包装器
class ResilientLLMService:
    def __init__(self, primary: BaseLLMProvider, fallback: Optional[BaseLLMProvider] = None, max_retries: int = 2):
        self.primary = primary
        self.fallback = fallback
        self.max_retries = max_retries

    def complete(self, request: LLMRequest) -> LLMResponse:
        last_error = None

        # 主模型指数退避重试
        for attempt in range(self.max_retries + 1):
            try:
                return self.primary.generate(request)
            except Exception as e:
                last_error = e
                wait_time = (2 ** attempt) * 0.5
                logger.warning(f"主模型请求失败 (尝试 {attempt+1}/{self.max_retries+1}): {str(e)},{wait_time:.1f}秒后重试")
                if attempt < self.max_retries:
                    time.sleep(wait_time)

        # 主模型全量重试失败,进入备用模型降级
        if self.fallback:
            logger.error(f"主模型完全不可用,触发备用模型降级链路...")
            try:
                return self.fallback.generate(request)
            except Exception as fb_err:
                logger.critical(f"备用降级链路同样调用失败: {str(fb_err)}")
                raise RuntimeError(f"所有可用 LLM 供应商均无法响应: 主模型异常[{last_error}], 备用异常[{fb_err}]")

        raise RuntimeError(f"LLM 服务调用失败且无配置备用模型: {last_error}")
4. 模式二的收益与演进瓶颈
通过模式二的改造,业务逻辑代码与大模型具体供应商彻底解耦,系统不再会因为单次网络抖动而直接把白屏抛给用户,而且代码库中拥有了统一的调用点,便于快速打点记录耗时。
然而,随着系统发展到多个独立微服务共同使用 AI 能力,模式二就会面临新的天花板:
- 微服务语言异构:如果公司的核心系统既有 Java、Go,又有 Python 和 Node.js,每一个服务都要用各自的语言重新实现一套具备“重试、降级、Token 统计、脱敏”的 SDK 代码,维护成本极高;
- 缺乏全局配额与速率控制:每个微服务各自并发调用,各微服务之间无法感知彼此的用量,极容易造成同一账号的总并发直接冲垮供应商分配的 RPM/TPM 上限;
- 无法实现跨微服务的全局语义缓存:不同微服务如果向模型提出了相似或重复的问题,无法共享缓存成果,造成大量重复算力支出。
这驱动着架构走向第三阶段:将 AI 治理能力从代码库中剥离出来,下沉为基础设施层独立的集中式 AI 网关。
模式三:集中式 AI 智能网关(Unified AI Gateway Pattern)
1. 架构本质与部署形态
集中式 AI 网关模式借鉴了现代微服务体系中的 API Gateway(如 Kong, Envoy, Traefik)理念,在大模型基础设施与内部所有业务服务之间,搭建一层专为 LLM 交互设计的独立反向代理集群。
在模式三下,所有的内部微服务只需遵循业界事实标准(如标准 OpenAI API 格式),将 base_url 指向内部的统一 AI 网关,请求头携带内部业务 Token 即可。目前开源界非常成熟的方案包括 LiteLLM Proxy、Portkey、Kong AI Gateway、Cloudflare AI Gateway 等,很多企业也会基于 FastAPI/Envoy 自研符合自身风控审计规范的轻量网关。
+-------------------+   +--------------------+   +-------------------+
|  Python 推荐服务   |   |   Java 交易服务    |   |   Go 消息中枢服务  |
+-------------------+   +--------------------+   +-------------------+
          \                       |                       /
           \                      |                      /
            v                     v                     v
     [ 标准 OpenAI 格式: POST http://ai-gateway.internal/v1/chat/completions ]
                                  |
+-----------------------------------------------------------------------------+
|                        统一企业 AI 网关集群 (AI Gateway)                     |
|                                                                             |
|  [ 1. 统一鉴权与配额 ] -> [ 2. 全局语义缓存 ] -> [ 3. 动态智能路由/负载均衡 ]    |
|   - 租户 API Key 校验       - Redis/Qdrant 向量匹配     - 跨云/跨厂商故障转移      |
|   - TPM/RPM/预算拦截        - 命中直接高吞吐返回        - 延迟/成本感知调度        |
|                                                                             |
|  [ 4. 统一密钥脱敏 ]   -> [ 5. 格式协议归一化 ] -> [ 6. 全链路可观测性打点 ]     |
|   - 内部凭据屏蔽公网        - 统一转成对应厂商报文      - Prometheus/OpenTelemetry  |
+-----------------------------------------------------------------------------+
               /                  |                   \
              v                   v                    v
      +---------------+   +---------------+    +---------------+
      | 供应商 A (云端) |   | 供应商 B (云端) |    | 本地私有化模型 |
      +---------------+   +---------------+    +---------------+
2. 集中式 AI 网关的核心能力矩阵
集中式网关绝非简单的 HTTP 转发,它承担了四个关乎系统生死存亡的基础设施级职责:
① 协议归一化与模型虚拟化(Universal Protocol Routing)
各业务系统在发起请求时,不需要关心底层是 OpenAI、Anthropic、DeepSeek 还是本地通过 vLLM 部署的开源模型。网关向内提供完全标准的 /v1/chat/completions 与 /v1/embeddings 接口,向外负责协议转换。
业务方请求的模型名称可以是一个“虚拟别名(Virtual Alias)”,如 fast-model 或 smart-model。运维团队可以在网关后台随时将 smart-model 映射的具体模型从厂商 A 切换为厂商 B,整个公司所有业务系统零改动、零发布、秒级生效。
② 跨厂商故障转移与动态逃生(Cross-Provider Failover)
网关层维护了一个动态健康检查与熔断状态机。当某厂商亚太节点突发网络拥塞或返回 5xx 错误时,网关可以在毫秒级将正在处理的请求透明切换至备用厂商的模型,上游业务完全感知不到底层的动荡,真正做到“多活高可用”。
③ 全局语义缓存(Global Semantic Caching)
在客服、问答、代码辅助等场景中,大量用户的提问语义高度接近。传统 HTTP 缓存基于 URL 和请求体哈希匹配,但在自然语言场景中,即使同一个意思,多一个标点符号或换一个近义词就会导致哈希失效。
AI 网关利用轻量级向量检索模型对输入进行快速编码,若与缓存池中历史请求的语义相似度高于设定阈值(如 Cosine 相似度 > 0.95),则直接从 Redis/向量数据库返回历史输出。这不仅将请求延迟从几秒压缩至几十毫秒,还能直接节约 30% 到 60% 的 Token 采购开支。
④ 统一财务归因与租户级治理(Quota & Observability)
网关拦截了全量请求,因此能够极其精确地捕获:每个团队每小时消耗了多少 Input/Output Tokens、平均首字延迟(TTFT - Time To First Token)、请求报错率。管理员可以为不同的部门或业务线签发内部专用 Key,并设定每月或每日的 Token 配额预算,一旦超支直接返回标准的 429 提示,彻底终结“月底收到账单全员抓瞎”的局面。
3. 实战代码剖析:轻量级 AI 路由中间件核心实现
为了理解网关内部的工作机理,以下演示了一个基于 FastAPI 构建的高性能多模型透明代理核心逻辑,涵盖了虚拟模型别名映射、故障转移与用量打点:
import time
import httpx
from fastapi import FastAPI, Request, HTTPException, status
from fastapi.responses import JSONResponse

app = FastAPI(title="Minimal Enterprise AI Gateway")

# 内部虚拟模型路由表映射配置(解耦业务层与实际供应商)
ROUTING_TABLE = {
    "corp-fast-model": [
        {"provider": "deepseek", "upstream_url": "https://api.deepseek.com/v1/chat/completions", "real_model": "deepseek-chat", "api_key": "sk-real-key-1"},
        {"provider": "openai", "upstream_url": "https://api.openai.com/v1/chat/completions", "real_model": "gpt-4o-mini", "api_key": "sk-real-key-2"}
    ],
    "corp-smart-model": [
        {"provider": "openai", "upstream_url": "https://api.openai.com/v1/chat/completions", "real_model": "gpt-4o", "api_key": "sk-real-key-2"},
        {"provider": "anthropic_proxy", "upstream_url": "https://api.openai-compatible.com/v1/chat/completions", "real_model": "claude-3-5-sonnet", "api_key": "sk-real-key-3"}
    ]
}

# 内部客户端租户额度池(简化演示)
TENANT_QUOTAS = {
    "tenant-search-team": {"balance_tokens": 1000000, "rate_limit_rpm": 600},
    "tenant-crm-team": {"balance_tokens": 500000, "rate_limit_rpm": 300}
}

@app.post("/v1/chat/completions")
async def chat_completions_proxy(request: Request):
    # 1. 租户鉴权与配额检查
    auth_header = request.headers.get("Authorization", "")
    token = auth_header.replace("Bearer ", "").strip()
    if token not in TENANT_QUOTAS:
        raise HTTPException(status_code=status.HTTP_401_UNAUTHORIZED, detail="无效的企业内部 AI 访问凭证")

    body = await request.json()
    requested_model = body.get("model")

    # 2. 路由目标解析
    candidates = ROUTING_TABLE.get(requested_model)
    if not candidates:
        raise HTTPException(status_code=status.HTTP_400_BAD_REQUEST, detail=f"未识别的虚拟模型标识: {requested_model}")

    # 3. 动态故障转移执行循环 (Failover Loop)
    last_exception = None
    async with httpx.AsyncClient(timeout=20.0) as client:
        for route in candidates:
            # 替换为真实的供应商模型名与密钥
            payload = dict(body)
            payload["model"] = route["real_model"]
            headers = {
                "Authorization": f"Bearer {route['api_key']}",
                "Content-Type": "application/json"
            }

            start_ts = time.time()
            try:
                upstream_res = await client.post(route["upstream_url"], json=payload, headers=headers)

                # 如果遇到 429 速率限制或 5xx 服务端错误,触发快速故障逃生
                if upstream_res.status_code >= 500 or upstream_res.status_code == 429:
                    print(f"上游通道 [{route['provider']}] 返回异常码 {upstream_res.status_code},切换下一个备用路由")
                    continue

                # 正常响应:记录审计日志并返回
                duration_ms = (time.time() - start_ts) * 1000
                res_data = upstream_res.json()
                usage = res_data.get("usage", {})
                print(f"[审计成功] 租户:{token} | 虚拟模型:{requested_model} -> 实际厂商:{route['provider']} | 耗时:{duration_ms:.1f}ms | 消耗Token:{usage.get('total_tokens', 0)}")

                # 扣减内存配额(实际生产中通过 Redis 扣减)
                TENANT_QUOTAS[token]["balance_tokens"] -= usage.get("total_tokens", 0)

                return JSONResponse(content=res_data, status_code=upstream_res.status_code)

            except (httpx.TimeoutException, httpx.NetworkError) as net_err:
                print(f"上游通道 [{route['provider']}] 网络连接故障: {str(net_err)},正在启动故障转移...")
                last_exception = net_err
                continue

    # 所有候选供应商均告警
    raise HTTPException(status_code=status.HTTP_502_BAD_GATEWAY, detail=f"全路由候选通道均调用失败,系统拒绝服务: {str(last_exception)}")
模式四:平台化与智能体运行时(Enterprise AI Hub & Agentic Runtime)
1. 架构本质:从单一调用迈向长程协同
如果说模式三解决了“把模型作为高可用管道接入”的问题,那么模式四则是为了应对当下最前沿、也最复杂的工程诉求:当 AI 不再仅仅是输出一段文字,而是要像员工一样自主调用几十种内部系统 API、检索私有知识库、维护长程业务状态并自主完成任务时,系统该如何架构?
这就是平台化与智能体运行时模式(Agentic Runtime)。
在这一阶段,系统不再只是一个被动应答的 HTTP 代理,而是由多个专业子系统构成的企业级 AI 操作系统(Enterprise AI Operating System):
+---------------------------------------------------------------------------------+
|                       企业级业务场景接入层 (Client Applications)                   |
|     (智能客服工作台 / 研发自动化研发助手 / 自动化投研分析系统 / 跨系统审批智能体)     |
+---------------------------------------------------------------------------------+
                                      |
                                      v
+---------------------------------------------------------------------------------+
|               企业级 AI 平台与智能体运行时 (Enterprise AI Platform Hub)          |
|                                                                                 |
|  +---------------------------------------------------------------------------+  |
|  | ① 智能体编排与状态持久化 (Agentic Orchestrator & State Persistence)        |  |
|  |   - 对话上下文窗口滑动管理与长期记忆 (Long-term Memory)                     |  |
|  |   - 多智能体协作流 (Multi-Agent Swarm / Plan-and-Solve)                   |  |
|  |   - 人机协同在环审批中枢 (Human-in-the-Loop Gateway for High-risk Tools)  |  |
|  +---------------------------------------------------------------------------+  |
|                                     |                                           |
|  +----------------------------------+----------------------------------------+  |
|  |                                  |                                        |  |
|  v                                  v                                        v  |
| +--------------------+    +--------------------+    +---------------------+     |
| | ② 工具注册中心     |    | ③ 知识增强管道     |    | ④ 安全与合规护栏    |     |
| | (Tool Registry)    |    | (Enterprise RAG)   |    | (AI Guardrails)     |     |
| | - 基于 MCP 协议规范|    | - 跨源向量/全文检索|    | - 提示词注入检测    |     |
| | - OpenAPI 自动解析 |    | - 重排器 (Rerank)  |    | - PII 实时动态掩码  |     |
| | - 最小权限沙箱执行 |    | - 敏感空间权限隔离 |    | - 输出合规审计拦截  |     |
| +--------------------+    +--------------------+    +---------------------+     |
|                                     |                                           |
|  +---------------------------------------------------------------------------+  |
|  | ⑤ 基础 AI 网关与模型服务中枢 (Underlying AI Gateway & Model Hub - 模式三) |  |
|  |   - 统一 OpenAI 规范路由 / 故障多活 / 语义缓存 / 动态限流 / 财务计费       |  |
|  +---------------------------------------------------------------------------+  |
+---------------------------------------------------------------------------------+
2. 平台化接入的核心能力五支柱
① 统一工具注册协议(Model Context Protocol / Tool Hub)
传统方式下,每当希望模型调用数据库、ERP 或发送飞书消息时,开发者都需要手写一段 JSON Schema 传给大模型。当系统中有上百个微服务工具时,模型上下文会被无意义的工具描述挤爆。
模式四建立了动态工具注册中心。目前业界主流采用 Anthropic 开源的 MCP(Model Context Protocol) 或统一 OpenAPI 规范。工具服务独立注册、独立鉴权、统一暴露能力规范。智能体在运行时根据用户意图,通过语义检索动态挂载所需的最小工具集,实现工具能力的即插即用。
② 会话与状态持久化引擎(State & Memory Engine)
在大模型多轮交互和复杂推理(如规划-执行循环)中,上下文往往非常庞大。平台层负责抽象会话管理:
- 短期会话状态:利用持久化状态机(如 LangGraph, Temporal 或自研工作流引擎)保存每一步中间产物,保证任务在遭遇网络中断或容器重启时能够断点续跑;
- 长期记忆索引:定期将历史会话压缩总结,写入向量库与图数据库,实现跨会话的记忆召回。
③ 统一知识编排管道(Universal Context & RAG Hub)
企业数据散落在 Confluence、GitLab、Notion、数据库与本地 PDF 中。平台模式将文档解析、语义切片、向量存储与重排(Rerank)封装为标准化的上下文增强管道,向所有上层应用提供“一键知识挂载”,避免每个业务团队重复采购和搭建向量数据库。
④ 安全与合规护栏(Enterprise Guardrails)
在模型输入前与输出后建立两道物理防线:
- 输入防线:拦截越狱指令(Jailbreak Detection)、过滤提示词注入(Prompt Injection)、自动将手机号/身份证等敏感数据打马赛克(PII Masking);
- 输出防线:对输出的自然语言进行违规内容与敏感词审计,对输出的 SQL/代码进行静态安全语法检查,高危写操作(如数据库 DROP 表、生产环境服务下线)自动触发 Human-in-the-Loop(人工在环) 审批流,必须人类审批人通过后方可执行。
⑤ 自动化评测与回流飞轮(Continuous Evaluation Flywheel)
系统在生产环境中自动收集用户点赞、点踩、会话重置等隐式反馈信号。高频失败样例(Bad Cases)自动脱敏进入基准测试集(Eval Benchmark)。当平台升级大模型或调整系统提示词时,CI/CD 流水线自动跑通评测套件,通过确定性分数对比保证迭代稳定性。
架构演进与落地决策框架:如何选择最适合你的模式?
许多研发团队在落地 AI 时容易走入两个极端:要么一直停留在模式一,放任散乱脚本在生产系统中“裸奔”,最终酿成生产故障;要么在业务刚起步、只有几个用户时,就盲目照搬大厂方案,强行搭建重度平台,最终导致工程团队疲于奔命、交付停滞。
为了帮助架构师和技术负责人理性选型,我们总结了一套“四问决策法”与渐进式演进路线图。
1. 选型四问决策法
[ 是否需要跨多系统自主调度工具/长程复杂业务编排? ]
                /              \
              是                否
              /                  \
  [ 采用模式四: 平台化接入 ]   [ 公司内部是否有超过 2 个团队/微服务调用 AI? ]
                                         /                  \
                                       是                    否
                                       /                      \
                           [ 采用模式三: 集中式 AI 网关 ]  [ 是否直接接入正式核心生产业务? ]
                                                                   /              \
                                                                 是                否
                                                                 /                  \
[ 采用模式二: 服务层封装 ] [ 采用模式一: 脚本直调 ]- 第一问:调用场景是“单点功能增强”还是“复杂自主工作流”?
- 如果只需要对一段文本提取关键词、生成单次摘要,绝无必要上模式四;
- 如果业务需要自主查询财务数据库、比对合同、发现异常并自动发审批流,必须采用模式四的智能体状态持久化与工具安全调度。
- 第二问:是否存在多团队、多微服务共享并发与成本?
- 如果全公司只有一个业务系统在使用 AI,优先使用模式二,在业务系统内部写好封装层即可;
- 如果有三四个不同微服务各自向公网请求大模型,立即架设模式三(统一网关),将密钥回收、协议归一,防范跨团队并发挤兑。
- 第三问:对服务可用性与故障恢复的容忍度是多少?
- 核心商业链路(如支付流程、客服系统)要求 99.9% 以上 SLA,必须至少拥有模式二的超时重试降级或模式三的多供应商自动切换;
- 内部运营周报整理、离线数据打标等边缘任务,模式一或轻量封装即可满足。
- 第四问:当前的研发资源与预算约束如何?
- 不要为“未来可能存在的规模”提前买单。先以模式二快速交付业务,当业务产生的 Token 支出和并发开始产生痛感时,再平滑将底层连接切换到模式三网关。
2. 平滑迁移路径:架构演进的三大步骤
如果你的团队目前正受困于大量散落的脚本调用,建议按照以下阶段平滑演进:
- 第一步(规范收敛,用时约 1-3 天):在现有代码中引入统一的
LLMClient适配类(模式二),强制所有模块通过该类调用大模型,配置统一的 15 秒硬超时与指数退避重试,收敛散落各处的 API Key 至统一环境变量中。 - 第二步(基础设施下沉,用时约 1-2 周):部署轻量级开源网关(如 LiteLLM Proxy 或自研简单网关),将代码中的
base_url统一指向网关内网域名,开启全局跨供应商容灾切换与 Prometheus 监控打点,开启 Token 审计。 - 第三步(场景智能化深水区,按需建设):针对特定复杂业务线,逐步接入 MCP 工具协议与 RAG 知识编排引擎,建立人机在环的高危操作防护网。
生产环境 5 大反模式深度避坑指南
无论你选择哪种集成模式,只要代码最终要面对真实用户,就必须坚决规避以下五大高危反模式:
反模式 1:前端或移动端直接直连公网大模型
- 现象:在 React、Vue 网页代码或小程序、iOS/Android App 中直接写入
const openai = new OpenAI({ apiKey: "sk-..." })发起请求。 - 后果:任何用户打开浏览器 F12 开发者工具或抓包工具,都能在 3 秒钟内提取出你的完整 API Key。黑客会迅速利用你的 Key 调用最昂贵的高性能模型进行高并发滥用,几小时内就能刷爆你的信用卡或账户余额。
- 正解:客户端严禁存放任何大模型长期私钥。所有调用必须先打到业务服务端,由服务端完成身份鉴权与频次控制后,再发起模型调用或通过 SSE(Server-Sent Events)向客户端转发流式输出。
反模式 2:缺少硬超时截断,将模型调用当成普通同步数据库查询
- 现象:在后端同步接口中直接发起一个耗时无法预估的模型推理请求,未设置
timeout参数。 - 后果:大模型服务一旦发生上游拥塞或生成长文本,一个请求可能挂起 60 秒甚至数分钟。当并发流量稍微上涨,Web 容器(如 Gunicorn、Tomcat、Go HTTP Server)的工作线程池会被迅速耗尽,导致非 AI 的普通系统接口(如用户登录、商品详情)也被拖死,引发全站级故障。
- 正解:任何外部模型请求必须设置明确的硬超时阈值(业务对话建议 10-15 秒,批处理任务建议 30-60 秒)。超过阈值立即断流释放连接,并返回优雅的降级文案。
反模式 3:直接信任模型生成的未校验结构,直接执行或入库
- 现象:告诉模型“请生成执行 SQL”或“请生成 JSON”,然后直接用
eval()、db.execute(sql)或未经字段检验就直接存入关系型数据库。 - 后果:大模型可能遭遇提示词注入攻击,或者在极低概率下产生幻觉,捏造出具有破坏性的指令(如注入
DROP TABLE)或丢失必填字段,导致下游数据流污染或发生毁灭性数据损失。 - 正解:模型生成结果属于“不可信输入”。必须经过白名单校验、强类型 Pydantic Schema 校验、SQL 语法树只读检测后,方可流入后续业务逻辑;涉及系统写操作的动作必须物理隔离或人工审批。
反模式 4:缺乏分级治理,全量业务无差别调用最昂贵的大模型
- 现象:无论是简单的“判断句子情感是正面还是负面”,还是复杂的“多步逻辑推理架构推演”,全部统一调用最顶级的超大规模旗舰模型。
- 后果:算力开销成倍放大,而简单场景下的响应延迟居高不下。
- 正解:建立大小模型阶梯路由策略。80% 的简单分类、实体抽取、短文本改写交给成本极低、延迟极小的小参数量模型(如 8B-14B 参数模型或云端 mini 模型);只有剩余 20% 的长上下文推理、复杂代码编写才动态路由给顶级旗舰模型。
反模式 5:零可观测性运维,缺失全链路 Token 与请求追踪
- 现象:系统上线后,除了系统日志里偶尔报出的几条
Error,运维和研发对每次请求的模型耗时分布、首字延迟(TTFT)、Prompt 膨胀率、缓存命中率一无所知。 - 后果:无法发现低效的提示词浪费,无法定位偶发卡顿瓶颈,对系统容量规划完全失控。
- 正解:通过网关层或 OpenTelemetry 标准统一捕获每个请求的 Trace ID,把每次调用的模型名、输入 Token、输出 Token、耗时结构统一打入监控仪表盘,建立清晰的系统健康度大盘。
生产环境上线前 15 项集成自检清单
在将任何带有大模型或 AI 工具调用的系统推向生产之前,请对照以下 15 项检查清单逐一复核:
一、架构与协议规范
- 1. 凭证物理隔离:确认代码库中全局搜索不到任何明文
sk-开头的私钥,公网前端/App 无直接连接; - 2. 协议解耦:业务代码层未直接硬编码某一家供应商专有的数据结构,具备替换模型的能力;
- 3. 参数外部化:Temperature、Top_P、Max_Tokens 及核心 Prompt 模板已从代码中剥离,支持配置化热更新。
二、稳定性与容灾防护
- 4. 硬超时保护:所有底层网络请求均已显式配置硬超时截断(建议交互场景 ≤ 15 秒);
- 5. 防御性重试机制:已配置带有随机抖动(Jitter)的指数退避重试,最大重试次数不超过 2-3 次,防范雪崩;
- 6. 优雅兜底降级方案:主通道完全瘫痪时,系统具备备用模型切换或友好降级提示(避免前端直接报 500 错误码);
- 7. 速率限制与限流:各业务租户已设置上游 RPM/TPM 限流拦截,防止单个业务突发流量挤死全局配额。
三、性能与成本控制
- 8. 缓存层就绪:高频相似问题已接入基础缓存或语义缓存,避免重复结算计算开销;
- 9. 流式传输机制:面向终端用户的长文本交互已全面支持 SSE 流式返回,确保首字展示延迟(TTFT)维持在可接受范围;
- 10. 结构化输出最小化:Prompt 中明确约束了最大输出长度,避免模型无限生成冗余废话浪费 Token。
四、安全与合规治理
- 11. 敏感数据脱敏(PII):用户身份证、密码、手机号等敏感信息在离开企业内网前已完成动态掩码;
- 12. 输出强类型白名单校验:所有结构化产出在送入持久化数据库前均通过 Schema 解析器做防御性验证;
- 13. 高危工具调用人工拦截:智能体若涉及转账、修改权限、删除数据等破坏性动作,已接入人工审批确认流程。
五、运维与全链路可观测
- 14. 财务与用量归因打点:每个请求均记录所属租户/业务线、输入 Token 数与输出 Token 数,支持月底对账;
- 15. 核心指标告警配置:对大模型网关的 429 发生率、5xx 错误率与 P95 延迟已配置企业微信/钉钉/邮件实时告警通道。
结语:架构的本质是伴随业务进化
从一条简单的单行脚本直调,到服务内部的稳健封装,再到跨团队的统一智能网关与企业级智能体平台,AI 工具集成的四种模式生动地诠释了现代软件架构的演进规律。
不要盲目追求最高阶的架构,也不要放任技术债务在底层蔓延。优秀的工程团队总是在业务探索期用最敏捷的模式一快速验证商业闭环;在业务立足期用模式二筑牢稳定性防线;在业务规模化期通过模式三网关收敛治理成本;在智能化深水区依托模式四释放智能体的协同价值。
掌握这四种模式的演进规律与选型边界,你就能在波澜壮阔的大模型落地浪潮中,为团队搭建一套兼具极致研发效能、严密安全防线与优异经济性的现代化技术基座。
交流与反馈:如果你在构建企业级 AI 架构、搭建大模型统一网关、或是设计多智能体协同系统时遇到了特定的工程挑战与性能瓶颈,欢迎通过我们的 联系方式页面 与我们深入探讨。