做 AI 应用绕不开一个决定:用哪个大模型的 API。参数榜看花了眼,但真正影响你决策的,其实是任务类型、成本结构、稳定性这三件事。这篇文章给出一套”不用看榜单也能选”的框架。
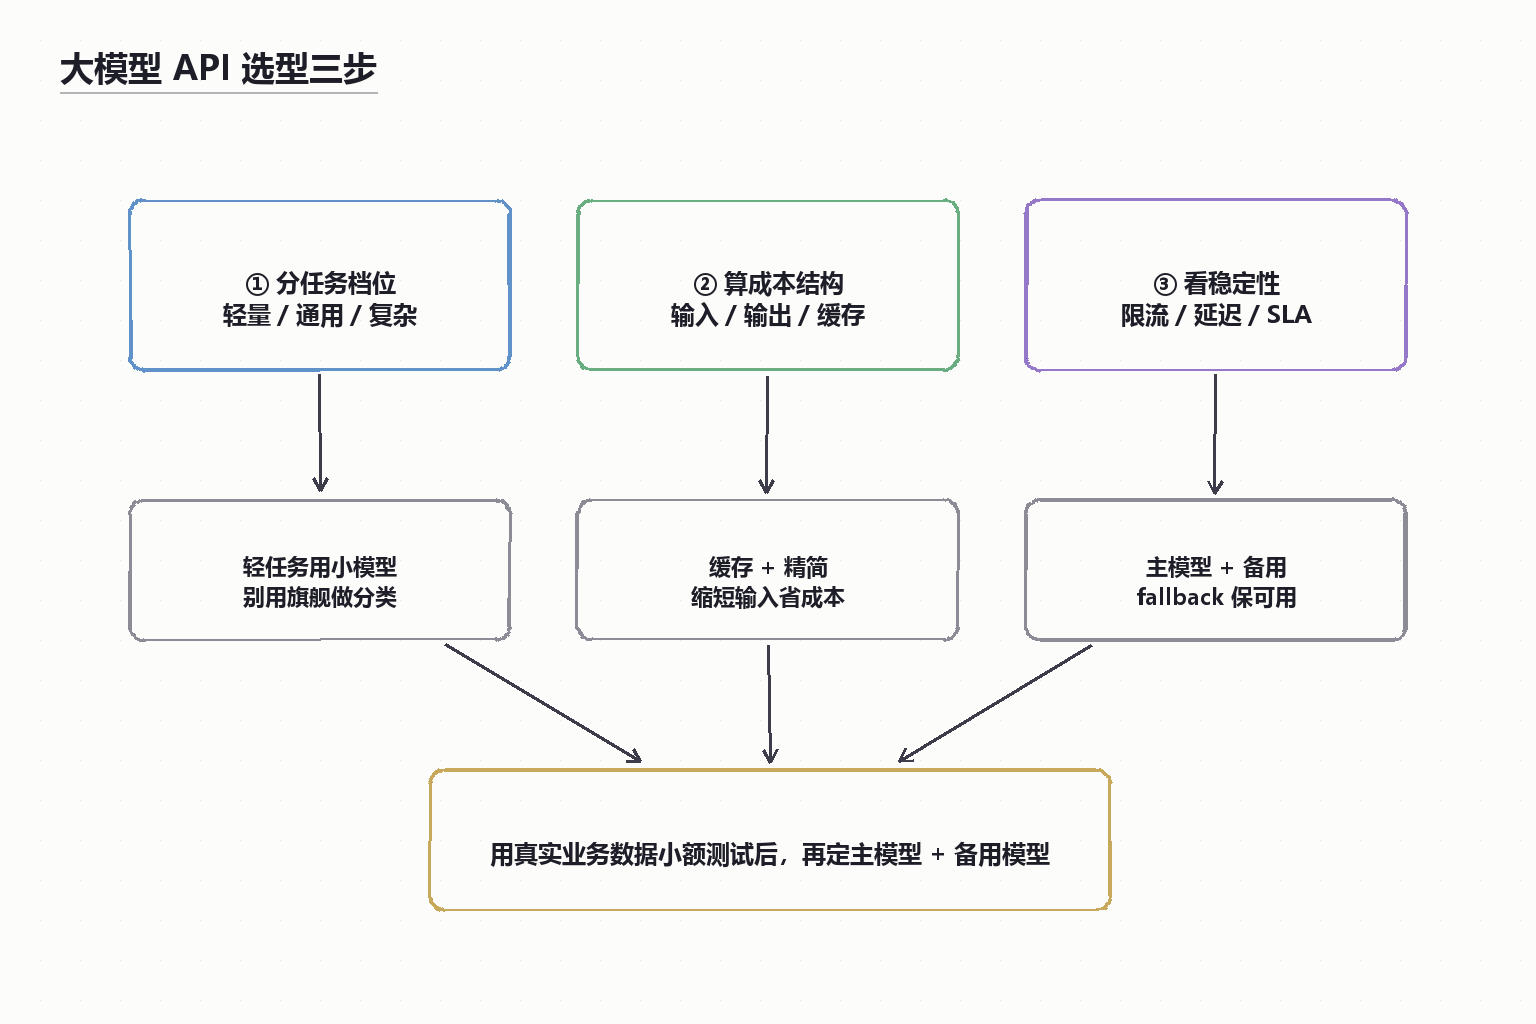
一、第一步:按任务类型分档
不要问”哪个模型最强”,要问”我这个任务属于哪一档“:
| 任务档位 | 特征 | 适合的模型 |
|---|---|---|
| 轻量 | 分类、抽取、简单改写 | 小而快的模型 |
| 通用 | 对话、总结、生成 | 中等能力模型 |
| 复杂 | 长文推理、代码、多步分析 | 旗舰模型 |
核心原则:让任务匹配模型,而不是都用最强。 用旗舰模型做分类,是最大的浪费。
二、第二步:算清成本结构
API 成本通常由三部分构成:
- 输入 token(你发给模型的内容)
- 输出 token(模型生成的内容)
- 缓存/其他(有的平台对重复输入有优惠)
降低成本的关键动作:
- 缩短输入:别把无关内容塞进 prompt,尤其长文档任务。
- 控制输出:明确要求”简洁””要点式”,避免模型啰嗦。
- 利用缓存:重复的上下文用缓存机制,避免重复计费。
- 分级调用:轻任务用小模型,判断/生成用大模型。
三、第三步:评估稳定性与工程因素
能力再强,不稳定也没法上生产。要评估:
- 限流与并发:QPS 上限是多少?会不会被限流?
- 延迟:平均响应时间能否满足你的交互要求?
- 可用性:有没有历史故障?有没有 SLA?
- 多路备份:能不能配置 fallback(主模型挂了切备用)?
生产环境里,**”能稳定跑”比”偶尔惊艳”重要得多**。
四、国产 vs 海外模型:怎么权衡
| 维度 | 国产模型 | 海外模型 |
|---|---|---|
| 中文能力 | 强 | 近年来提升明显 |
| 合规/数据 | 更易满足国内合规 | 需评估数据出境 |
| 成本 | 通常更低 | 通常更高 |
| 访问稳定性 | 国内链路顺 | 需评估网络 |
| 生态/工具 | 快速完善 | 生态成熟 |
结论:国内业务优先考虑国产模型(合规 + 成本 + 链路);需要特定能力或海外部署时,再引入海外模型。
五、一张选型决策流程
明确任务档位 → 列出候选模型 → 用真实数据小额测试
→ 对比:效果 / 成本 / 延迟 → 定主模型 + 备用模型 → 上线监控关键:一定要用”你业务里的真实数据”测,而不是用公开 demo。
六、落地时的三个建议
- 抽象一层调用接口:不要把模型写死在业务里,方便随时切换。
- 配 fallback:主模型异常时自动切备用,保证可用。
- 监控成本与质量:上线后持续看”花了多少”和”效果如何”,定期复盘。
结语
大模型 API 选型的本质,是用最低的成本、最稳的链路,解决你具体的任务。榜单可以看,但决策要落到”任务档位 + 成本结构 + 稳定性”这三个可量化的维度上。
需要针对你的业务做模型选型,欢迎 联系我们。