一个只会”一次性对话”的 Agent 和一个能”记住你”的 Agent,体验差距是数量级的。但”给 Agent 加记忆”这件事,远比想象中复杂——把全部历史都塞进上下文会爆炸,只留最近几轮又会”失忆”,而外挂一个数据库又面临”检索不准”的问题。
这篇文章把 Agent 的记忆机制拆成三个层次,讲清楚每一层解决什么问题、代价是什么、什么时候该用哪一种。
一、为什么 Agent 需要”记忆”
先把问题定义清楚。Agent 需要的记忆,本质上要解决三类需求:
- 连续性:多轮对话里,Agent 要记得之前说过什么,不能每轮都当新对话。
- 个性化:记得用户的偏好、习惯、历史决策,做出更贴合的建议。
- 知识积累:把过去处理过的内容沉淀下来,下次能直接调用。
这三类需求对应三种不同的记忆机制。把它们混为一谈,是设计失败的最常见原因。
二、短期记忆:上下文窗口的博弈
它是什么
短期记忆就是当前对话上下文里保留的内容。最朴素的实现是”把历史消息全带上”,但上下文窗口有限,而且 token 是要花钱的。
核心矛盾
| 策略 | 好处 | 代价 |
|---|---|---|
| 全量保留 | 信息最完整 | 很快超出窗口、成本高 |
| 只留最近 N 轮 | 成本低 | 早期关键信息丢失 |
| 滑动窗口 + 摘要 | 平衡 | 需要额外的摘要计算 |
实用做法
- 窗口 + 摘要:保留最近若干轮原文,更早的内容压缩成一段摘要。这是最常用的折中方案。
- 关键信息抽取:不要让模型”记全部”,而是抽取结构化要点(用户目标、约束、已确认事项)单独保留。
- 按需回填:只在需要时把某段历史调回来,而不是常驻上下文。
关键认知:短期记忆的目标不是”记住所有”,而是”在窗口限制下保住最重要的信息”。
三、长期记忆:把经验存到外部
它是什么
长期记忆把信息持久化到外部存储(数据库、文件、向量库),需要时再取回。它突破了上下文窗口的物理限制。
存什么、怎么存
长期记忆通常分两类:
- 结构化记忆:用户画像、偏好设置、关键事实。适合存关系型数据库或键值存储,读取精确、成本低。
- 非结构化记忆:历史对话片段、文档、笔记。适合存向量库,靠语义检索取回。
一个实用的划分原则:
| 信息类型 | 存储方式 | 取回方式 |
|---|---|---|
| 用户偏好 / 配置 | 键值 / 关系库 | 直接按 key 查 |
| 事实性知识 | 向量库 | 语义相似检索 |
| 事件流水 | 日志 / 时序库 | 按时间范围筛选 |
| 任务状态 | 关系库 | 按任务 ID 查 |
常见坑
- 什么都往里存:结果检索时噪音太大,把真正有用的信息淹没。
- 不设过期:过时信息被反复取回,导致 Agent 给出错误建议。
- 缺少去重:同一件事存了十遍,浪费存储也污染检索结果。
四、检索式记忆:让”取回”这一步准确
长期记忆的成败,不在存,而在取。检索式记忆解决的问题是:在大量历史里,准确找到当前需要的那几条。
检索的三种信号
- 语义相似:向量检索,找”意思接近”的内容。
- 关键词匹配:精确命中人名、术语、ID 等。
- 时间/元数据过滤:只看某段时间、某个来源的记录。
单一信号往往不够。 实践中最好的是”混合检索”:先用元数据过滤缩小范围,再语义 + 关键词双路召回,最后重排序。
提升检索质量的做法
- chunk 粒度要合适:太大会稀释关键信息,太小会丢上下文。按语义边界切分,而非按固定字数硬切。
- 加元数据:时间、来源、主题标签,让过滤成为可能。
- 重排序:召回一批后,用更精细的模型重新排序,把最相关的放前面。
- 评估闭环:记录”取回的内容到底有没有用”,持续优化。
五、三层怎么配合:一个参考架构
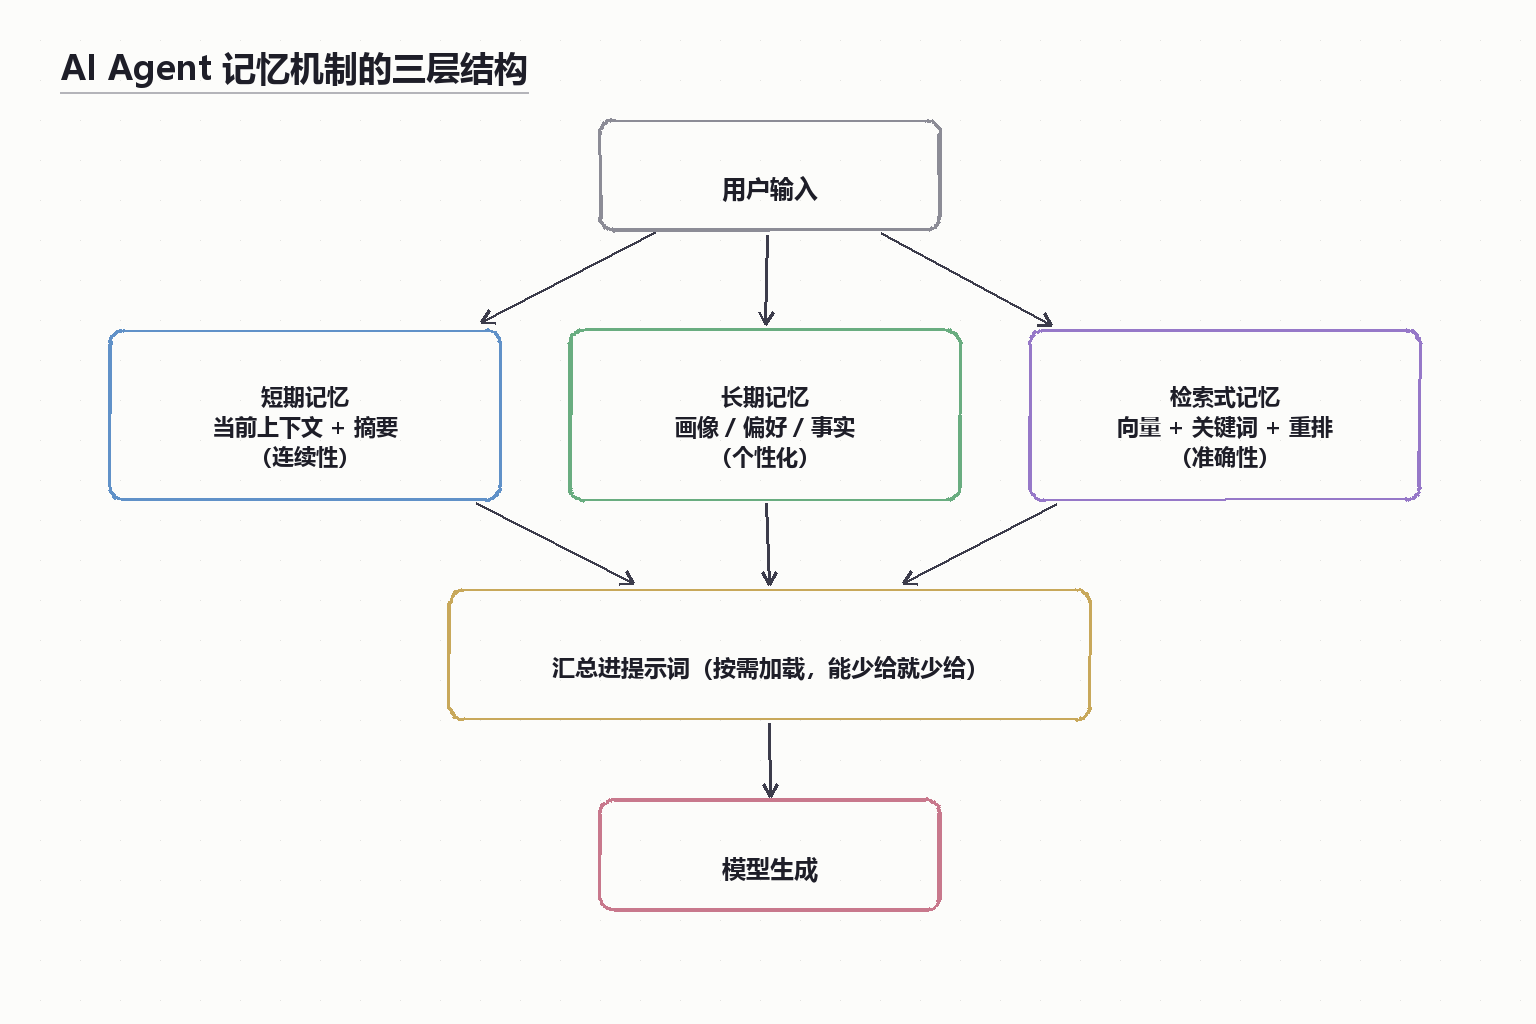
三层记忆不是互斥的,而是分层协作:
用户输入
  → 短期记忆:当前上下文 + 摘要(保证连续性)
  → 长期记忆:读取用户画像/偏好(保证个性化)
  → 检索式记忆:按需召回历史相关内容(保证知识可用)
  → 汇总进提示词 → 模型生成
→ 输出后:把值得留存的信息写回长期记忆核心原则:读写分离、按需加载、能少给就少给。
- 写入时:判断这条信息值不值得长期保留(不是所有对话都值得存)。
- 读取时:只取当前任务真正需要的部分,别一次性全塞进上下文。
六、一张决策清单
| 你的场景 | 推荐方案 |
|---|---|
| 单次任务、无需记忆 | 只保留当前上下文即可 |
| 多轮对话需要连续 | 窗口 + 摘要 |
| 需要记住用户偏好 | 键值库存结构化画像 |
| 需要语义化调取历史 | 向量库 + 混合检索 |
| 知识库问答 | RAG(分块 + 检索 + 重排) |
| 长期运行的个人 Agent | 三层组合,读写分离 |
七、落地时的三条建议
- 从最简单开始:先做”窗口 + 摘要”,跑到有真实痛点再上向量库,别一上来就搭复杂架构。
- 为检索质量投资:记忆系统的价值几乎全在”取回准不准”上,分块策略、元数据、重排序值得反复打磨。
- 给记忆设边界:哪些能存、存多久、谁能看——尤其是涉及用户隐私和敏感数据时,这不是技术问题而是合规问题。
结语
Agent 的记忆机制,本质是一个**”在有限窗口下,把对的信息在正确的时刻呈现出来”**的工程问题。短期记忆解决连续性,长期记忆解决容量,检索式记忆解决准确性——三者各司其职,缺一不可。
理解了这三层,你就能根据实际场景组合出最合适的方案,而不是盲目往上下文里堆内容。
有具体的 Agent 记忆设计问题,欢迎 联系我们 交流。