模型参数涨得没以前快了,上下文窗口却一年比一年离谱。于是每个做知识库、做企业问答、做文档助手的人都会撞上同一个问题:我把资料塞进 prompt 里不就完了,为什么还要折腾 RAG?
反过来也有人被 RAG 坑过:切片策略调了两周,召回率还是上不去,检索回来的东西牛头不对马嘴,最后发现”全塞进去”反而更准。于是又开始怀疑 RAG 这套东西是不是过时了。
这两种反应都是把问题简化成了立场。这篇文章不讲情怀,只讲两种路线的真实差别在哪里、什么时候该选哪个、以及能不能混着用。核心结论我先放这儿:这不是替代关系,是两种不同的信息供给策略,各自的失效场景完全不同。
一、先把两条路线说清楚:它们到底在做什么
RAG 的本质是”先筛后排”
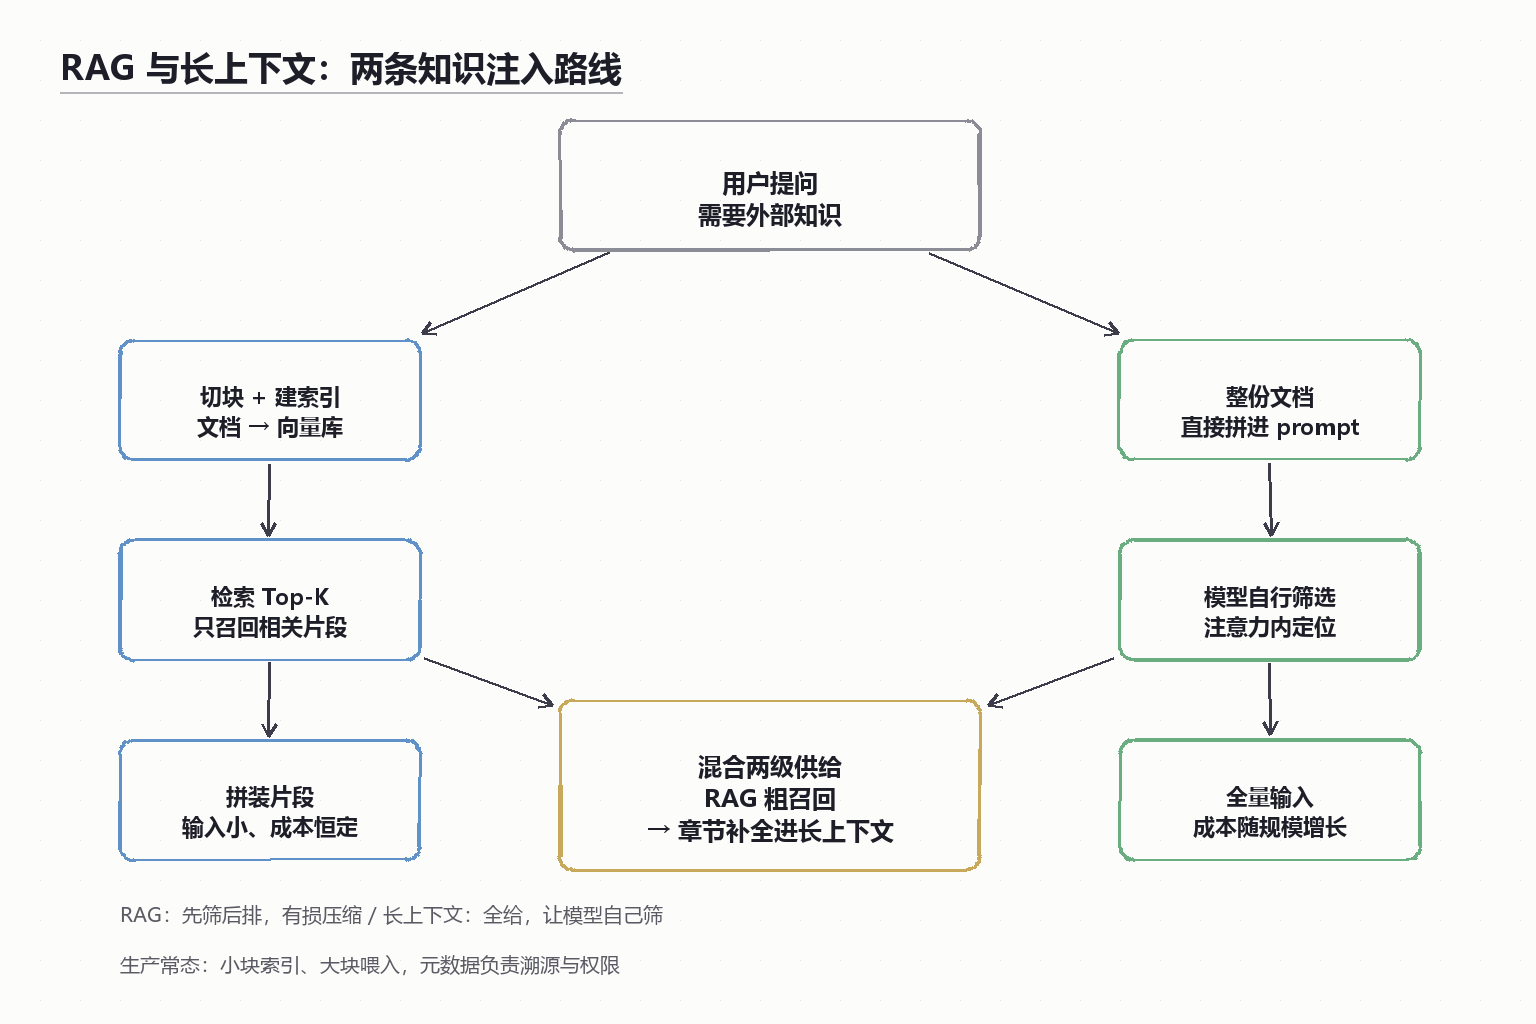
RAG(Retrieval-Augmented Generation)做的事情可以拆成四个动作:
- 切块(chunking):把长文档切成若干语义相对完整的小段;
- 索引(indexing):把每一段转成向量,存进向量库,同时保留原始文本和元数据;
- 检索(retrieval):用户提问时,把问题也转成向量,按相似度召回 Top-K 片段;
- 拼装(augmentation):把召回片段塞进 prompt,让模型基于这几段回答。
关键点在于:模型在生成时,只能看到被召回的那几段。这是一个有损压缩的过程——你在第 2 步就决定了模型未来可能看到的信息上限,第 3 步再从这个上限里挑一部分。
长上下文的本质是”全给,让模型自己筛”
长上下文(long context)路线几乎没有前置工程:把整份文档、整个代码仓库、整本手册直接拼进 prompt,让模型自己在注意力机制里找相关内容。
它把”筛选”这个动作从工程层搬到了模型层。你不需要设计切片策略、不需要调 embedding 模型、不需要维护向量库,但你要为每一个 token 付费,并且要接受”相关内容在超长文本里被稀释”的风险。
一个容易忽略的差别:更新与追溯
RAG 天然带元数据:每个片段都知道自己来自哪个文件、第几页、什么时间入库。这意味着你可以做”引用溯源””按时间过滤””按权限过滤”。
长上下文路线里,如果你不自己在 prompt 里标注来源,模型回答完之后你没法说清”这句话是从哪来的”。
一句话总结:RAG 是提前做选择题,长上下文是把判断题交给模型。
二、成本对比:不是”谁便宜”,而是”成本函数长什么样”
很多人算成本只算单次调用,这会得出完全错误的结论。两条路线的成本函数结构根本不同。
| 成本项 | RAG 路线 | 长上下文路线 |
|---|---|---|
| 一次性建设成本 | 高:切片策略、embedding、向量库、召回评测 | 低:几乎没有,拼字符串就行 |
| 每次调用输入成本 | 低且相对恒定(只看 Top-K 片段) | 随文档规模线性增长 |
| 每次调用输出成本 | 相近 | 相近 |
| 延迟 | 检索 + 生成,检索通常很快 | 主要吃输入 token 的预填充时间 |
| 维护成本 | 持续:文档变更要重新索引 | 低:换文档就换字符串 |
| 扩容成本 | 加文档基本不影响单次成本 | 文档翻倍,单次成本大概率也翻倍 |
这张表最能说明问题的是**”每次调用成本”那一行**。
假设你自己维护一份 500 页的内部规范手册。走长上下文路线,每一次提问都要把这 500 页塞进去,无论用户问的是”报销流程”还是”服务器命名规范”。而走 RAG,用户问”报销流程”时只召回三段相关内容,输入量可能只有前者的百分之几。
但注意:如果这份手册你一个月只查两次,RAG 的前期建设成本(设计切片、搭向量库、写召回评测)可能几年都摊不回来。低频场景下,长上下文的经济性反而更好。
所以判断标准不是”哪个便宜”,而是:
- 调用频次高 + 文档规模大 → RAG 的成本曲线明显更优;
- 调用频次低 + 文档规模中等 → 长上下文更省事也更省钱;
- 文档每天都在变 → RAG 的重索引成本要算进去,长上下文反而省心。
三、效果对比:两类失效场景,比准确率数字更重要
公开的”RAG vs 长上下文”评测里,结论经常互相打架。原因很简单:测试集不同,失效模式就不同。与其记结论,不如记住两类失效场景。
RAG 的三类典型失效
第一类:切片把语义切断了。
一段论证跨了两个 chunk,第一块里有前提,第二块里有结论。检索只召回第二块,模型拿到的就是一句没有上下文的断言。这是实践中最常见、也最难发现的问题——回答看起来通顺,但缺了前提。
第二类:召回不到,但”看起来”召回对了。
用户问”新版接口的鉴权方式变了吗”,文档里写的是”v2 版本调整为 Bearer Token”。字面相似度不高,向量检索很可能召回一堆无关的”接口说明”。模型基于这些片段硬答,就会产生看起来很自信的错误回答。
第三类:多跳问题。
“A 组件的负责人现在管哪个项目”——需要先查 A 组件负责人是谁,再查这个人的项目归属。单次检索拿不到完整链路,除非你专门设计多轮检索。
长上下文的四类典型失效
第一类:中间遗忘(lost in the middle)。
模型对超长上下文开头和结尾的信息利用较好,中间部分容易被忽略。这是结构性的注意力偏差,不是”再多给点 token 就能解决”的问题。
第二类:干扰项误导。
文档里存在多份相似但版本不同的内容(比如三个版本的流程说明),模型可能拿旧版本回答新问题。RAG 可以用时间元数据过滤,长上下文只能靠 prompt 里明确说”以最新版为准”——而这句话本身也可能被忽略。
第三类:幻觉性引用。
模型被要求”基于以下文档回答”时,往往会生成看起来完整的答案,即使文档里根本没有。长上下文给的”安全感”会让人放松对答案的核查。
第四类:成本失控导致的工程妥协。
为了控制成本,你可能会砍文档、砍历史轮次,最后得到的其实是”一个质量不稳定的、自己拼出来的 RAG”。
一张对照表:失效场景映射
| 场景特征 | RAG 表现 | 长上下文表现 |
|---|---|---|
| 单点事实查询(”X 是什么”) | 稳定,召回准就很好 | 稳定 |
| 跨段落的完整论证 | 风险高(切片断裂) | 较好 |
| 多跳推理 | 需专门设计 | 较好(前提是全部材料在内) |
| 相似文档存在多版本 | 好(可元数据过滤) | 风险高(干扰项) |
| 需要引用溯源 | 好(天然带出处) | 需自行标注,易幻觉 |
| 文档超长且结构松散 | 中等(召回质量决定上限) | 风险高(中间遗忘) |
| 权限隔离(不同用户看不同文档) | 好(检索层过滤) | 需在拼装层严格控制 |
最后一行是企业场景里最容易被忽视的:长上下文路线下,权限控制发生在”你往 prompt 里放什么”这一步,一旦写错就是数据越权。RAG 可以在检索层按用户身份过滤,边界更清晰。
四、决策框架:五个问题定位你的场景
不要凭感觉选。按顺序问自己五个问题,前两个就能排掉大部分场景。
问题 1:文档总量有多大?
几页到几十页(大约几万字以内)→ 长上下文基本够用,别折腾。上百页或持续增长 → 必须认真考虑 RAG。
问题 2:同一份知识被查询的频次高吗?
每天几十上百次 → RAG 的固定成本能被摊薄。偶尔用 → 长上下文更务实。
问题 3:答案需要溯源吗?
需要给用户看到”这句话出自哪份文件的哪一节” → RAG 有结构性优势。只需给结论 → 差别不大。
问题 4:不同用户看到的知识范围一样吗?
不一样 → 必须做检索层过滤,长上下文路线要做好严格的拼装控制,否则出事。
问题 5:问题形态是单点事实还是跨段落推理?
大量跨段落推理、多跳问题 → 长上下文更稳,或者需要专门优化 RAG 的切片与多轮检索。
把五问的答案组合起来,会得到三种典型画像:
- 画像 A(小文档 + 低频 + 无需溯源) → 长上下文,一次性做完;
- 画像 B(大文档 + 高频 + 需溯源/需权限) → RAG,值得投入建设;
- 画像 C(大文档 + 需要跨段落理解) → 混合,见下一节。
五、混合方案:真正上生产的形态
实践中很少有纯粹的”全 RAG”或”全长上下文”。比较稳的做法是两级供给:
用户提问
  → 第一级:RAG 粗召回(从大库里捞出 5~20 个候选片段,
    带文件/时间/权限元数据)
  → 第二级:把候选片段的"整节原文"塞进长上下文窗口
    (不是只塞约 300 字的切片,而是补全到完整的章节)
  → 模型在"补全后的上下文"里做推理
  → 输出 + 附带片段元数据作为引用
这个结构解决了两边的痛点:
- 用 RAG 解决了规模问题(不用把整库塞进去);
- 用”章节补全”解决了切片断裂问题(召回到一个片段,就把它的父章节一起给);
- 用元数据解决了溯源与权限问题。
在工程上,这通常叫父子块(parent-child chunk) 或 小片检索、大片喂入:索引时用小块提高召回精度,喂给模型时用大块保证语义完整。
混合方案的三个落地要点
- 召回阶段宁可宽一点:Top-K 设大一些(比如 10~20),因为后面有长上下文兜底,召回阶段的漏检比冗余更致命。
- 给每个片段明确标注来源与时间:在 prompt 里用固定格式包住,例如
[来源: 文件名 | 更新: 2026-09 | 章节: 3.2],模型引用时不容易编造。 - 设置”检索不到就承认”的出口:明确告诉模型”如果提供的资料中没有答案,就说没有”,这比任何召回优化都更能降低幻觉率。
六、自检清单:上线前逐项确认
这份清单按”路线无关”和”路线相关”分两部分,可以直接拿去做评审。
通用项(两条路线都要过)
- 有评测集:至少 30~50 条来自真实用户的问题,带标准答案,每次改动都跑一遍。
- 有”无答案”用例:故意问文档里没有的东西,确认系统会拒答而不是编造。
- 有引用格式规范:回答里必须带来源标识,且能点回原文。
- 有版本意识:文档更新后,旧版本内容不会继续被当成正确答案。
- 有失败兜底:检索为空、超时、超长时,有明确的降级路径。
RAG 专项
- 切片按结构切(标题/段落),而不是固定字符数硬切;
- 每个 chunk 保留父章节引用,便于补全上下文;
- 混合检索(向量 + 关键词),避免纯向量在专有名词上的漏检;
- 召回结果做重排(rerank),Top-K 的精度比数量重要;
- 文档变更后有增量索引机制,不是每次全量重建。
长上下文专项
- 文档按逻辑顺序排列,重要内容不要放在正中间;
- 关键约束(”以最新版为准””只回答权限内内容”)放在开头和结尾各说一次;
- 输入 token 量有监控与上限告警,避免某次请求把成本打爆;
- 权限过滤发生在拼装前,且只在一个地方做(不要散落多处);
- 长文档做了结构化标注(章节头、分隔符),帮助模型定位。
七、几个常见误区
误区一:上下文窗口够大,RAG 就没用了。
窗口变大解决的是”能不能放下”,没解决”该看哪几段””怎么溯源””怎么按权限隔离”。规模一大,这几个问题只会更严重。
误区二:RAG 就是向量检索。
向量检索只是召回的一种手段。生产里更常见的是关键词 + 向量混合召回 + 重排。只上纯向量检索,专有名词、编号、错误码这类查询几乎必踩坑。
误区三:切片越小召回越准。
小切片召回精度可能更高,但语义完整性更差。正确做法是”小块索引、大块喂入”,而不是一味切碎。
误区四:效果不好就换更强的模型。
如果问题是召回错了,换模型只会让模型更有信心地基于错误材料回答。先修检索,再换模型,顺序不能反。
误区五:长上下文不需要工程。
它省掉的是索引工程,但引入了拼装工程:权限、成本上限、来源标注、顺序设计,都是要写代码的。
八、给你的落地顺序建议
如果现在从零开始做一个知识库问答,我建议这样推进:
- 第一周:用长上下文跑通闭环。不做索引,直接把文档拼进去,跑 30 条真实问题,记录哪些答错。这一步的目的是建立评测基线,而不是交付。
- 第二周:分析错误类型。把错答分成”材料里没有””材料里有但没找到””找到了但推理错”三类。第三类换模型,前两类是检索问题。
- 第三周:如果”没找到”占比高,再引入 RAG。这时你已经有了评测集,能客观判断 RAG 到底有没有带来提升。
- 第四周:合并成两级供给。RAG 负责召回,长上下文负责推理,元数据负责溯源。
这个顺序的价值在于:你不会在还没搞清楚问题在哪的时候,就先背上 RAG 的工程债。反过来,如果一开始就上 RAG,出了问题你很难区分是切片问题、embedding 问题还是模型问题。
结语
RAG 和长上下文,一个在降低输入规模,一个在提高输入容量。它们解决的是同一个问题的两端,而不是互相替代。
真正决定成败的,从来不是选了哪条路线,而是你有没有评测集、有没有溯源机制、有没有把”检索不到就承认”写进系统里。
需要针对你的文档规模和业务场景做具体方案,欢迎 联系我们。