当一个 AI 原生功能从实验室 Demo 走向数十万甚至上百万的真实用户时,工程团队往往会在月底收到一张令人触目惊心的 API 账单。
在很多团队的初始认知里,模型调用成本似乎是一个“按量付费的自然支出”:用户输入越多、交互轮数越长,账单数字就只能线性甚至指数级上升。面对高昂的开销,不少产品甚至不得不采取简单粗暴的“降智”策略——将所有调用一刀切换成廉价小模型,或者对用户使用频次设置苛刻的硬性限流,最终却以牺牲关键体验和留存率为代价。
然而,在大规模生产工程的实践中,AI 调用成本从来不是黑盒算力费,而是一门可以被精细化拆解、重构和治理的 I/O 工程。许多系统账单高企的根源,不在于大模型本身昂贵,而在于架构上的严重粗放:静态提示词被无状态地重复传输、简单格式化任务被顶配旗舰模型过度消化、非实时任务在黄金并发期抢占高价实时通道。
本文将从真实的工程落地视角出发,系统梳理现代 AI 系统成本优化的三大核心支柱:提示词与语义缓存(Caching)、动态模型分级路由(Tiered Routing) 以及 异步批量处理(Batching),并结合上下文精炼工程与生产级代理网关代码,提供一套行之有效的可复用降本方案。
成本失控的四大典型病灶
在动手治理成本之前,我们需要先给系统的 API 调用做一次病理透视。根据对大量中后台与 AI 原生应用的分析,绝大多数无谓的 Token 消耗集中在以下四个维度:
1. 无状态传输与上下文雪崩
在多轮对话、长文档分析或复杂 Agent 工作流中,传统的调用方式是每次请求都把全量历史记录(包含 System Prompt、数千 Token 的企业知识库片段、过往数十轮对话)原封不动地重新发送给 API。
在一次持续 20 轮的会话中,最初设定的系统提示词和上下文会被反复计算 20 次。上下文像滚雪球一样越滚越大,后半段的单次交互成本甚至可以达到初始轮次的数十倍。
2. “大炮打蚊子”式的统一选型
许多系统在架构设计初期为了图省事,将所有业务逻辑统统指向同一个顶配旗舰大模型。
无论是让模型判断用户的意图是“查天气”还是“订机票”,还是仅仅做一次文本实体提取或 JSON 格式修正,都一律调用千亿级大模型。这种在简单场景下的过度配置,直接造成了数倍乃至数十倍的成本溢出。
3. 同步阻塞与峰值溢价
很多业务场景其实天然具备时间容忍度,例如夜间数据报表归纳、长视频字幕翻译、知识库异步索引打标、离线客诉质检等。
然而系统依然统一使用高优先级、按实时高并发计费的同步 Chat Completion 接口。这不仅浪费了云厂商专为非实时任务提供的半价批处理通道,还容易在业务高峰期触发平台的 TPM(Tokens Per Minute)与 RPM 限流。
4. 冗余生成与输出失控
由于缺乏严格的结构化输出契约(JSON Schema)与合理的 Max Tokens 上限,模型在回答时常常伴随着冗长客套的寒暄话术。更严重的是,当模型因幻觉输出无效格式导致业务反序列化失败时,系统往往会触发盲目的全链路重试机制,一次失败相当于付出了两到三次的双倍开销。
成本优化杠杆全景与收益矩阵
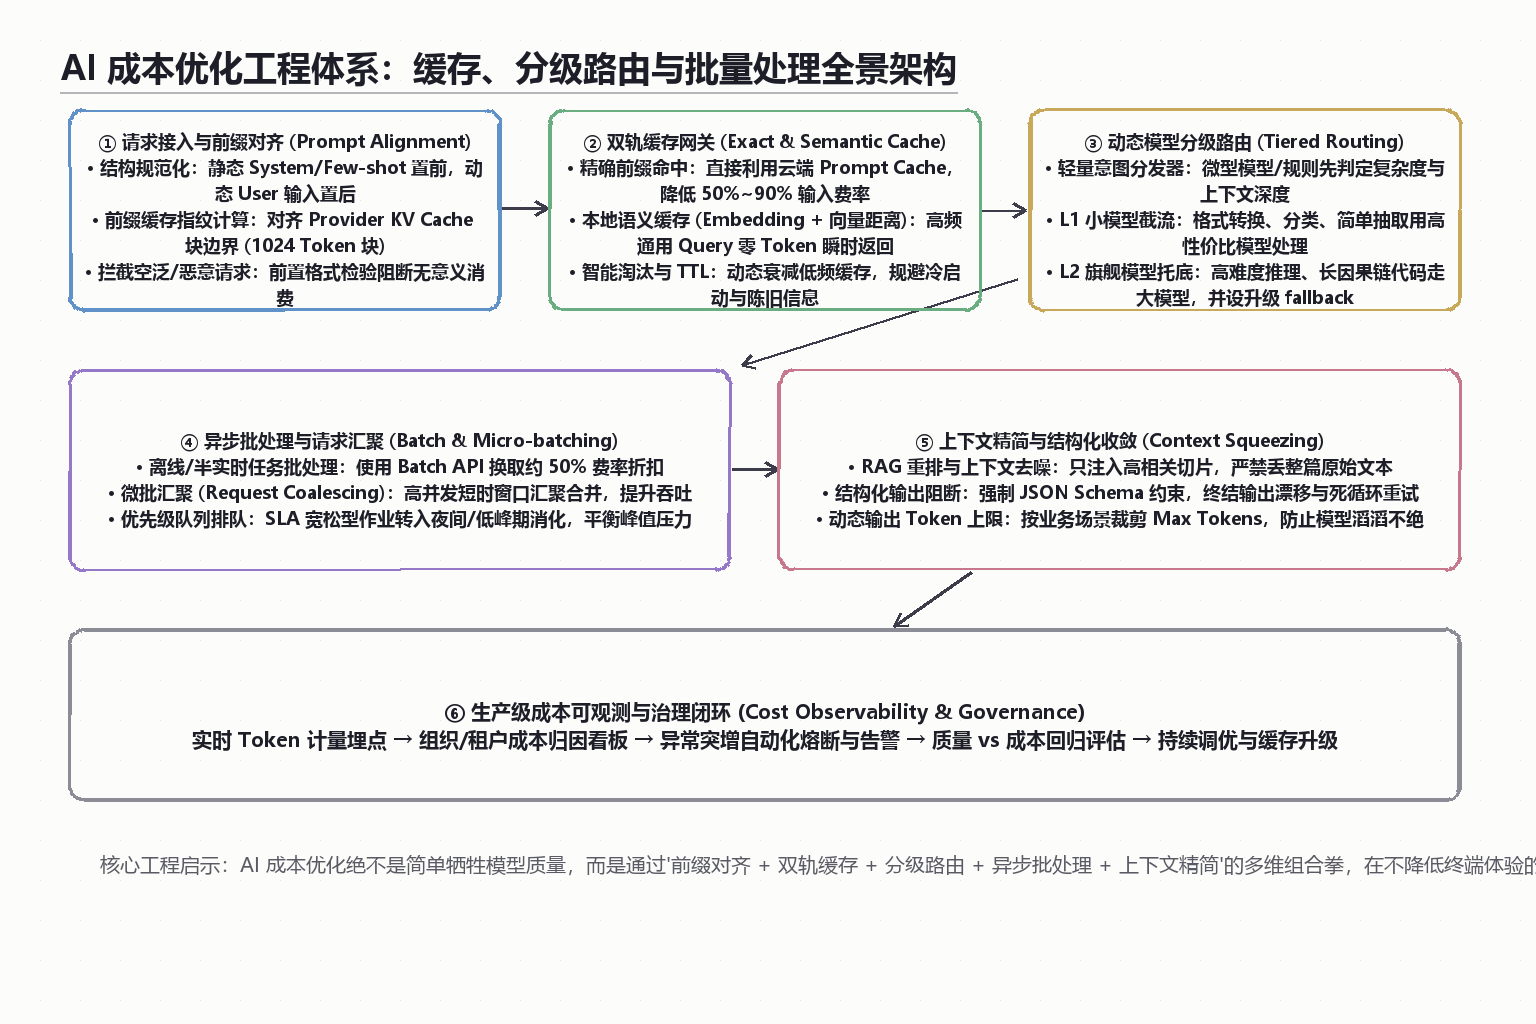
对 AI 调用的成本优化绝不是单点打补丁,而是一个涉及接入层、网关层、调度层和模型层的完整工程体系。在启动改造前,我们需要清晰了解各类技术手段的降本杠杆率、实施难度及潜在风险:
| 优化技术杠杆 | 核心技术原理 | 典型成本降幅(输入/输出) | 延迟影响 | 工程复杂度 | 核心适用场景 |
|---|---|---|---|---|---|
| 云端提示词缓存 (Prompt Caching) | 复用 Provider 侧显存中的 KV Cache 状态 | 输入端降低 50% ~ 90% | 首字延迟显著降低(TTFT 骤降) | 低(需规范提示词前缀排列) | 固化 System Prompt、代码库上下文、长文档连续问答 |
| 本地语义缓存 (Semantic Cache) | 向量空间近邻检索 + 高频热点问答缓存 | 命中时输入/输出均降为 0% | 毫秒级极速响应 | 中(需维护向量库与失效机制) | 客服高频 FAQ、公共知识检索、重复高频指令 |
| 动态模型分级路由 (Tiered Routing) | 轻量判别器分类意图,按复杂度派发大小模型 | 综合成本降低 40% ~ 70% | 简单任务变快,复杂任务持平 | 中高(需构建分流规则与回退链条) | 混合意图系统、全功能智能助手、工作流多步骤编排 |
| 异步批处理 (Batch API) | 离线队列集中处理,平衡厂商算力波峰波谷 | 官方直接返还约 50% 费率折扣 | 异步交付(通常数小时内完成) | 低中(需改同步为异步轮询/回调) | 离线内容分析、数据标注、夜间批处理作业 |
| 上下文精缩 (Token Squeezing) | Rerank 高密度切片、消除无关冗余历史 | 输入端降低 30% ~ 60% | 延迟随上下文变小而缩短 | 中(需改造 RAG 检索与上下文管理器) | 复杂企业级 RAG、长期记忆多轮对话 |
| 结构化输出约束 (JSON Schema) | 强制输出符合强类型规范,杜绝死循环重试 | 降低 15% ~ 30% 的无效 Token 与重试成本 | 输出更紧凑,避免多余修饰语 | 低(参数层配置并配强验证) | API 对接、工具调用(Function Calling)、信息结构化提取 |
策略一:提示词缓存与双轨缓存网关
在所有的优化手段中,缓存(Caching) 是投资回报率最高、见效最快的技术路线。现代大语言模型的缓存可以分为两大流派:云端精确前缀缓存与本地语义缓存。
1. 云端提示词缓存(Prompt Caching)的硬件本质与前缀对齐
现代 LLM 在自回归生成时,Transformer 会为每一个输入的 Token 生成 Key 和 Value 向量,存储在 GPU 显存的 KV Cache 中。如果前后两次请求拥有完全相同的 Prompt 前缀,理论上模型根本不需要重新对这部分内容做矩阵乘法运算,直接复用显存中的 KV Cache 即可。
各大主流 API 厂商目前均已支持显存级的 Prompt Caching,通常要求前缀连续相同达到一定长度(例如 1024 个 Token 以上)。一旦命中,厂商通常会给予 50% 至 90% 的输入 Token 费率减免,同时首字延迟(TTFT)大幅缩减。
但要稳定命中云端前缀缓存,开发者必须严格遵守“前缀对齐三大法则”:
- 静态绝对置前:将最稳定、从不改变的 System Prompt、工具调用函数签名(Tool Definitions)、Few-shot 示例排在数组的最前端。
- 半动态内容居中:将企业长期通用知识库、用户档案等较长但更新频率中等的信息排在中间。
- 高频动态置后:当前的实时时间、用户最新的提问 Query、随机盐值等每轮都变动的字段,绝对不能插在前面,必须固定放在最末尾。
- 消除不确定随机性:避免在系统提示词的前半部分拼入动态时间戳(如
当前时间是 10:43:48),否则会导致整个前缀指纹全盘改变,缓存命中率直接归零。正确做法是将时间变量注入在 User Prompt 的末尾或者专用的上下文字段中。
【错误的前缀排布 - 缓存命中率 0%】
[User: 今天是周一] → [System: 你是客服助手...] → [Tool Definitions] → [User: 帮我退货]

【正确的前缀排布 - 缓存命中率 > 80%】
[System: 你是客服助手...] → [Tool Definitions] → [Few-shot Examples] → [User: (动态参数+当前Query)]
2. 本地语义缓存(Semantic Cache)
云端 Prompt Cache 只能节省输入 Token,且必须是字符级的一致。而对于终端用户而言,许多提问虽然字面不同,但表达的业务诉求完全一致。例如:
- “你们的退款流程是怎样的?”
- “我想退货,怎么申请退款?”
- “买的东西不想要了,支持退款吗?”
如果每次都将这些请求送往大模型,既浪费钱又增加网络耗时。语义缓存(Semantic Cache) 的核心思想是:将历史 Query 转化为文本嵌入向量(Embedding),当新 Query 到来时,先在向量数据库(如 Redis、pgvector、Qdrant)中计算余弦相似度。若相似度超过预设的高置信度阈值(通常设定在 0.95 ~ 0.98),则直接返回历史缓存结果,输入和输出 Token 消耗均为 0。
在构建语义缓存时,必须设立严格的安全与失效边界:
- 个性化隔离:缓存键必须绑定租户 ID、用户身份权限或角色分组,严禁把包含用户私密数据的回答误命中给另一个用户。
- 时间敏感性豁免:包含“今天”、“最新”、“库存状态”等实时动态意图的 Query,必须跳过语义缓存,直通模型。
- TTL 动态衰减:通用策略设置合理的过期时间,并在底层知识库文档发生变更时,主动发布 Pub/Sub 事件批量清除相关知识簇的缓存。
策略二:动态模型分级与智能路由(Tiered Routing)
在软件架构中,处理海量请求的核心原则从来不是“让最强的服务器抗下所有”,而是“分流与降级”。AI 架构同样适用这一规律。
1. 梯队化模型分工设计
在生产环境中,我们可以把模型资源划分为四个能力梯队:
- L0 规则与模式匹配层(0 成本):使用正则、关键词字典、状态机处理机械格式转化、打招呼问候、简单敏感词过滤。
- L1 极速轻量模型层(成本约为旗舰的 1/20 ~ 1/50):适用于文本分类、情感判断、Query 改写、路由意图判别、短摘要提取、结构化 JSON 校验。
- L2 均衡主力模型层(成本约为旗舰的 1/5 ~ 1/10):适用于常规 RAG 生成、大多数日常问答、常规代码编写、多语言翻译。
- L3 旗舰高智能模型层(基准满额成本):仅用于长因果链逻辑推导、高难度架构设计、复杂数学逻辑、极端长上下文综合研判。
2. 意图判别器与路由策略
实现智能路由的关键在于:如何用几乎可以忽略的代价,准确判断一个请求应该去 L1 还是去 L3?
常用的路由判别方式包括:
- 基于元数据的启发式规则:检查请求的参数特征。例如,输入字符数小于 100 且用户意图为打标分类的,直接打入 L1 模型;需要深度推理或带有代码运行沙箱的,打入 L2/L3。
- 微型模型轻量仲裁:先用极其廉价的轻量模型(设置
max_tokens: 16,要求仅输出单个分类标签如EASY/MEDIUM/HARD),由它来决定后续主力调用走向。 - 投机式执行(Speculative Cascading):先让轻量模型尝试生成。如果输出的自我置信度高(或通过了自动化 JSON 格式校验器),则直接采用;如果校验失败或模型返回兜底标识,再静默平滑升级到旗舰模型重跑。根据行业实测,80% 以上的企业工单和日常咨询在 L1/L2 阶段就能高质量结案。
策略三:异步批处理与请求汇聚
很多技术团队在做系统设计时,习惯性地把所有对 LLM 的调用都封装为 HTTP 同步阻塞调用。但从算力供需关系来看,实时交互与离线分析的商业价值与服务等级协议(SLA)是完全不同的。
1. 挖掘 Batch API 的 50% 制度红利
几乎所有主流的大模型提供商都推出了 Batch API 接口。其运作机制是:开发者将一批待处理的请求(几百到几万条)打包成一个 JSONL 文件上传,云厂商保证在 24 小时(通常在 1~3 小时内即可完成)内处理完毕并提供下载。
作为交出“即时性”的回报,云厂商直接为 Batch API 提供 统一的 50% 价格折扣,并且拥有独立且充裕的速率限额(Rate Limits),不会占用生产在线业务的实时配额。
以下业务场景应当强制全量迁移至 Batch API:
- 知识库历史存量文档的向量化与元数据重算
- 自动化生成评测测试集与离线回归质检
- 每日/每周报表的大规模异步总结
- 大批量外呼录音和客服工单的违规质检与意图归类
- 大规模语料翻译与冷数据清洗
2. 微批汇聚(Request Coalescing / Micro-batching)
对于并发量较高的半实时服务(例如社区评论自动审核、电商商品描述生成),可以引入微批汇聚机制:
服务不针对每个用户请求立即发起单次模型调用,而是在内存中设立一个滑动时间窗口(例如 100ms ~ 300ms)或容量上限(例如满 10 个请求)。当窗口到达或数量满额时,将多个单条请求拼装为一个复合批量 Prompt(使用编号严格分隔输出),单次调用完成多人份的生成。这不仅能摊销掉重复的 System Prompt 成本,还能显著提升整体系统的吞吐量(Throughput)。
策略四:输入裁剪与输出收敛工程
除了系统架构层面的缓存与分流,在单次请求内部“抠细节”同样能带来可观的边际收益。
1. 上下文精炼与 RAG 重排去噪
在企业 RAG 系统中,很多初级工程师习惯把向量检索出来的 Top 10 切片(可能多达上万 Token)连带整篇原始材料全部硬塞给上下文。这不仅带来了极高的计费成本,还会触发大模型的“迷失在中间(Lost in the Middle)”效应,导致回答质量下降。
精细化裁剪实践:
- 两阶段检索与重排(Rerank):第一阶段粗筛出 20 个段落,第二阶段使用 Cross-Encoder Rerank 严格按相关性打分,最终仅保留前 3~5 个真正包含答案线索的高分片段注入上下文。
- 句子级粒度抽取:提取出上下文片段后,使用简单的规则引擎剔除无关的 HTML 标签、格式噪声以及免责声明等冗余字符。
- 滑动窗口遗忘:在对话历史管理中,不要保留数十轮的完整对话原文。对 5 轮以前的历史进行异步总结(Summary),用 100 字的语义摘要替代上千字的原始对话流水。
2. 结构化输出与 Max Tokens 硬约束
- 阻断客套修饰语:通过明确的提示词或结构化输出模式,命令模型禁止输出“好的,我已经收到了您的需求,下面是为您整理的内容:”等没有信息密度的开场白与结语。
- 按需压低 Max Tokens:很多 API 默认的
max_tokens是 4096 甚至更高。如果当前任务仅仅是提取一个包含 5 个字段的 JSON,将max_tokens强行限制为 300。这不仅能防止模型偶发“发疯”陷入无限死循环输出吞噬你的额度,还能在异常时第一时间中断扣费。 - JSON Schema 校验一次通过:利用平台原生支持的 Structured Outputs 特性。原生约束由底层的 Constrained Decoding(约束解码)技术保证,保证 100% 遵守 JSON 语法树,杜绝由于括号不闭合或格式错误引发的系统级重试。
生产级实战代码:智能成本优化代理网关
下面是一个采用 Python 编写的轻量级成本优化代理网关实现。该网关综合实现了 精确前缀哈希指纹校验、轻量级本地语义缓存(模拟) 以及 复杂度动态分级路由 的核心逻辑:
"""
AI 成本优化代理网关 (CostOptimizationGateway)
功能:
1. 静态前缀对齐与 Prompt Caching 优化
2. 语义缓存命中(避免重复调用)
3. 请求复杂度判定与大小模型分级路由 (Tiered Routing)
4. Token 用量与成本节约统计
"""

import hashlib
import json
import time
from typing import Dict, Any, Tuple, Optional


class CostOptimizationGateway:
    def __init__(self, semantic_cache_threshold: float = 0.95):
        self.semantic_cache_threshold = semantic_cache_threshold
        # 本地模拟缓存存储: hash -> {"embedding": [...], "response": str, "timestamp": float}
        self.cache_store: Dict[str, Dict[str, Any]] = {}
        # 统计计数器
        self.stats = {
            "total_requests": 0,
            "cache_hits": 0,
            "l1_routed": 0,
            "l2_routed": 0,
            "saved_tokens_approx": 0
        }

    def _normalize_prefix(self, system_prompt: str, tools: list) -> str:
        """
        强制对齐前缀:移除易变时间戳,确保静态提示词哈希完全稳定
        """
        static_block = {
            "system": system_prompt.strip(),
            "tools": tools or []
        }
        return json.dumps(static_block, sort_keys=True)

    def _calculate_embedding(self, text: str) -> list:
        """
        生产环境中应调用轻量级本地 Embedding 模型 (如 bge-micro)
        这里用简化哈希生成确定性浮点向量做示意
        """
        seed = int(hashlib.md5(text.encode("utf-8")).hexdigest()[:8], 16)
        import random
        rnd = random.Random(seed)
        vec = [rnd.random() for _ in range(32)]
        norm = sum(x ** 2 for x in vec) ** 0.5
        return [x / norm for x in vec]

    def _cosine_similarity(self, v1: list, v2: list) -> float:
        return sum(a * b for a, b in zip(v1, v2))

    def _check_semantic_cache(self, query: str) -> Optional[str]:
        """
        检索语义缓存,相似度超过阈值则直接命中
        """
        query_vec = self._calculate_embedding(query)
        best_match = None
        highest_sim = -1.0

        for key, item in self.cache_store.items():
            sim = self._cosine_similarity(query_vec, item["embedding"])
            if sim > highest_sim:
                highest_sim = sim
                best_match = item["response"]

        if highest_sim >= self.semantic_cache_threshold:
            return best_match
        return None

    def _judge_complexity(self, query: str, context_len: int) -> str:
        """
        路由仲裁器:判定调用轻量级模型 (L1) 还是旗舰大模型 (L2)
        """
        # 规则 1: 简短明确的分类或格式提取任务走 L1
        fast_keywords = ["提取", "分类", "翻译成英文", "修正拼写", "总结成一句话"]
        is_simple_task = any(kw in query for kw in fast_keywords) and len(query) < 120

        # 规则 2: 极长上下文或明确要求推理推导的走 L2
        needs_deep_reasoning = any(kw in query for kw in ["推导", "架构设计", "证明", "反思", "原因分析"])

        if is_simple_task and not needs_deep_reasoning and context_len < 1000:
            return "L1-Lightweight"  # 例如轻量快速模型
        return "L2-Flagship"         # 例如旗舰复杂大模型

    def execute_chat_completion(
        self,
        system_prompt: str,
        user_query: str,
        context_docs: str = "",
        tools: list = None
    ) -> Dict[str, Any]:
        self.stats["total_requests"] += 1

        # 1. 检查语义缓存
        cached_result = self._check_semantic_cache(user_query)
        if cached_result:
            self.stats["cache_hits"] += 1
            self.stats["saved_tokens_approx"] += len(user_query) + len(cached_result)
            return {
                "source": "semantic_cache",
                "model_used": "none",
                "content": cached_result,
                "cost_saved": True
            }

        # 2. 规范化前缀,促进 Provider 侧 Prompt Cache 命中
        normalized_static_prefix = self._normalize_prefix(system_prompt, tools)

        # 3. 复杂度路由仲裁
        total_context_len = len(system_prompt) + len(context_docs)
        selected_model = self._judge_complexity(user_query, total_context_len)

        if selected_model == "L1-Lightweight":
            self.stats["l1_routed"] += 1
            # 模拟轻量模型处理
            mock_output = f"[L1 处理结果] 针对 '{user_query}' 的快速格式化输出。"
        else:
            self.stats["l2_routed"] += 1
            # 模拟旗舰模型深度处理
            mock_output = f"[L2 深度推理结果] 经过长链条推导完成针对 '{user_query}' 的综合解答。"

        # 4. 写入语义缓存(仅针对具备重用价值的问答)
        if len(user_query) > 6 and "当前" not in user_query:
            query_hash = hashlib.sha256(user_query.encode("utf-8")).hexdigest()
            self.cache_store[query_hash] = {
                "embedding": self._calculate_embedding(user_query),
                "response": mock_output,
                "timestamp": time.time()
            }

        return {
            "source": "model_inference",
            "model_used": selected_model,
            "content": mock_output,
            "cost_saved": False
        }


# --- 验证测试用例 ---
if __name__ == "__main__":
    gateway = CostOptimizationGateway(semantic_cache_threshold=0.92)
    system = "你是一个智能技术支持专家,请用客观专业的语言回答。"

    # 第 1 次:简单任务 -> 路由到 L1 轻量模型
    res1 = gateway.execute_chat_completion(system, "提取下列文字的电话:联系我 13800138000")
    print("请求 1 路由结果:", res1["model_used"], "| 来源:", res1["source"])

    # 第 2 次:复杂推导任务 -> 路由到 L2 旗舰大模型
    res2 = gateway.execute_chat_completion(system, "请推导 Transformer 中自注意力机制的时间复杂度原因分析")
    print("请求 2 路由结果:", res2["model_used"], "| 来源:", res2["source"])

    # 第 3 次:语义相似任务 -> 命中语义缓存 (零 Token 消耗)
    res3 = gateway.execute_chat_completion(system, "请推导 Transformer 自注意力机制的时间复杂度与原因")
    print("请求 3 路由结果:", res3["model_used"], "| 来源:", res3["source"])

    print("网关运行累计统计:", gateway.stats)
落地中的 5 大反模式深度避坑
在许多团队实施成本优化的过程中,往往会因为过度追求节约而走向极端,踩入以下典型陷阱:
1. 语义缓存阈值设置过于激进
为了追求高缓存命中率,把语义相似度阈值从合理的 0.96 调低到 0.85 甚至更低。这会导致严重的问题“答非所问”。例如用户询问“Python 如何连接 MySQL?”,系统可能错误匹配成“Node.js 如何连接 MySQL?”的缓存。
正解:宁可漏掉缓存回源模型,也绝不能给用户提供错误的相似回答。生产环境相似度阈值严禁低于 0.95,对于金融、医疗等敏感领域应只使用精确匹配。
2. 小模型输出不做格式校验与降级保护
把所有简单任务切给廉价小模型后,由于小模型的指令遵循能力天然逊于旗舰模型,一旦遭遇边缘情况(Edge Cases)可能会输出格式破损的残缺数据,导致下游代码抛出异常。
正解:构建“分流-检验-升级”闭环。当小模型输出无法通过 Pydantic 或 JSON Schema 校验时,立即捕获异常并静默路由到旗舰模型重跑一次,保障系统坚韧度。
3. 在静态提示词中无意识混入动态变量
很多开发者喜欢在 System Prompt 头部写类似 今天是 2026年11月2日 10:45:00 或者生成一个随机会话 TraceID: x9f21a。这种无意识的代码习惯,会直接导致每次请求的哈希指纹完全变化,令云端本来可以免费复用的数千 Token KV Cache 完全失效。
正解:使用静态配置模板,彻底将易变字段后置到 User 消息的最末尾。
4. 盲目对高并发在线服务使用 Batch API
有的团队看到 Batch API 有半价优惠,硬生生把用户在前端等待的同步问答转成 Batch 异步轮询。用户点一次按钮需要等 10 分钟才能看到回复,直接毁掉了核心业务体验。
正解:明确划分 SLA 边界。用户在线交互场景必须走流式(Streaming)低延迟实时通道;后台无感任务、批量数据处理才允许走 Batch 模式。
5. 缺乏精细化成本监控与归因看板
很多团队只知道月底总账单花了多少钱,但根本不知道这些钱具体是被哪一个业务模块、哪个实验分支、甚至哪几名重度用户消耗掉的。缺乏精细归因的优化就像盲人摸象。
正解:在代理网关层强制为每个请求打上 tenant_id、feature_tag、user_id 的元数据标签,将 Token 消耗按业务线细分可视化,精准揪出异常膨胀的“Token 吞噬怪”。
生产级 AI 成本治理 15 项自检清单
在你的系统正式接入大流量之前,建议工程团队对照以下 15 项核心指标逐一核查治理进度:
一、提示词与云端缓存治理(KV Cache)
-
- 系统提示词(System Prompt)与函数定义(Tools)是否统一收敛在请求前缀,未混入动态变动的日期时间?
-
- 静态系统提示词长度是否达到了云厂商 Prompt Cache 激活的最小门槛(通常 ≥ 1024 Tokens)?
-
- 是否监控了云厂商返回结果中的
cached_tokens字段,并计算了实际的前缀缓存命中率?
- 是否监控了云厂商返回结果中的
-
- 多轮对话是否按照只追加(Append-only)的顺序排列,未在中间插入乱序变量?
二、本地语义缓存与网关防护
-
- 高频问答(FAQ)或通用业务知识是否前置部署了语义缓存层?
-
- 语义相似度判决阈值是否严控在 0.95 以上,避免低置信度错误匹配?
-
- 缓存键是否严格做了多租户与用户鉴权隔离,杜绝跨用户数据污染?
-
- 底层业务文档更新时,是否有配套的缓存主动失效(Invalidation)联动机制?
三、分级路由与架构分流
-
- 是否根据任务复杂度建立了明确的 L1(轻量)与 L2/L3(旗舰)模型阶梯?
-
- 文本打标、分类、简单结构化抽取等任务是否已全面剥离给高性价比模型?
-
- 小模型分流后是否配置了输出格式强校验与静默升级回退机制(Fallback)?
四、批处理与上下文精简
-
- 非实时、低时效性要求的离线数据清洗与报表任务,是否已全量切换为 Batch API?
-
- RAG 知识检索是否增加了 Re-rank 阶段,严格控制召回片段的数量与长度?
-
- 所有输出接口是否设置了贴合业务上限的
max_tokens,杜绝无节制长文本生成?
- 所有输出接口是否设置了贴合业务上限的
-
- 是否启用了基于业务维度(项目/团队/功能)的 Token 消耗监控与异常突增自动告警?
结语:成本控制与技术架构的动态平衡
在 AI 原生时代,技术负责人的核心竞争力之一,不再仅仅是“能否把大模型接进系统”,而是“能否以最具商业可行性的单位经济效益(Unit Economics)持续交付稳定的智能”。
成本优化从来不是孤立的“省钱技巧”,而是一项涉及全链路系统重构的工程实践。它考验着团队对底层硬件机制(KV Cache)的理解深度、对高并发中间件的架构调度能力,以及对业务场景容忍度的敏锐洞察。
通过建立前缀对齐、双轨缓存、动态分级路由、异步批处理以及精细化上下文工程这五道防线,你完全可以在模型质量不打折扣、核心用户体验不受影响的前提下,将系统的综合账单开销压降数倍。当智能调用的成本壁垒被真正打破,你的产品才能在激烈的市场竞争中拥有更充裕的试错空间与更高的商业天花板。
如果在落地 AI 成本优化、架构选型或网关设计过程中遇到具体工程瓶颈,欢迎通过 交流与联系 与我们深入探讨。