在内容生产和技术写作中,大语言模型已经深度渗透到了选题构思、资料梳理和初稿起草的各个环节。然而,伴随生成效率指数级提升而来的,是一股弥漫在互联网上的浓重“AI 味”。
许多读者在刷到一篇文章的前三行时,就会在潜意识中产生警惕并迅速划走:“在当今数字化飞速发展的浪潮中……”、“不可否认的是,这如同一把双刃剑……”、“不仅赋能了……更铺就了……”。这种文字语法挑不出明显硬伤,段落排布工整对称,但读完之后却让人感到极度疲劳和空虚——没有具体的场景,没有真实的代价,没有作者的性格,更没有可以被落地复现的细节。
很多团队尝试在提示词结尾加上“请写得像人类一样”、“语气自然口语化一点”或者“去掉 AI 腔”,但收效甚微。模型依然会换着花样输出结构对称的排比句与假大空的宏观综述。
要彻底消除 AI 写作的机器感,必须从大模型的生成机理出发,理解“AI 味”从何而来,进而通过结构去对称、语言去套话、事实双轨核查以及自动化质检网关,建立一套工业级的人机协同写作流水线。
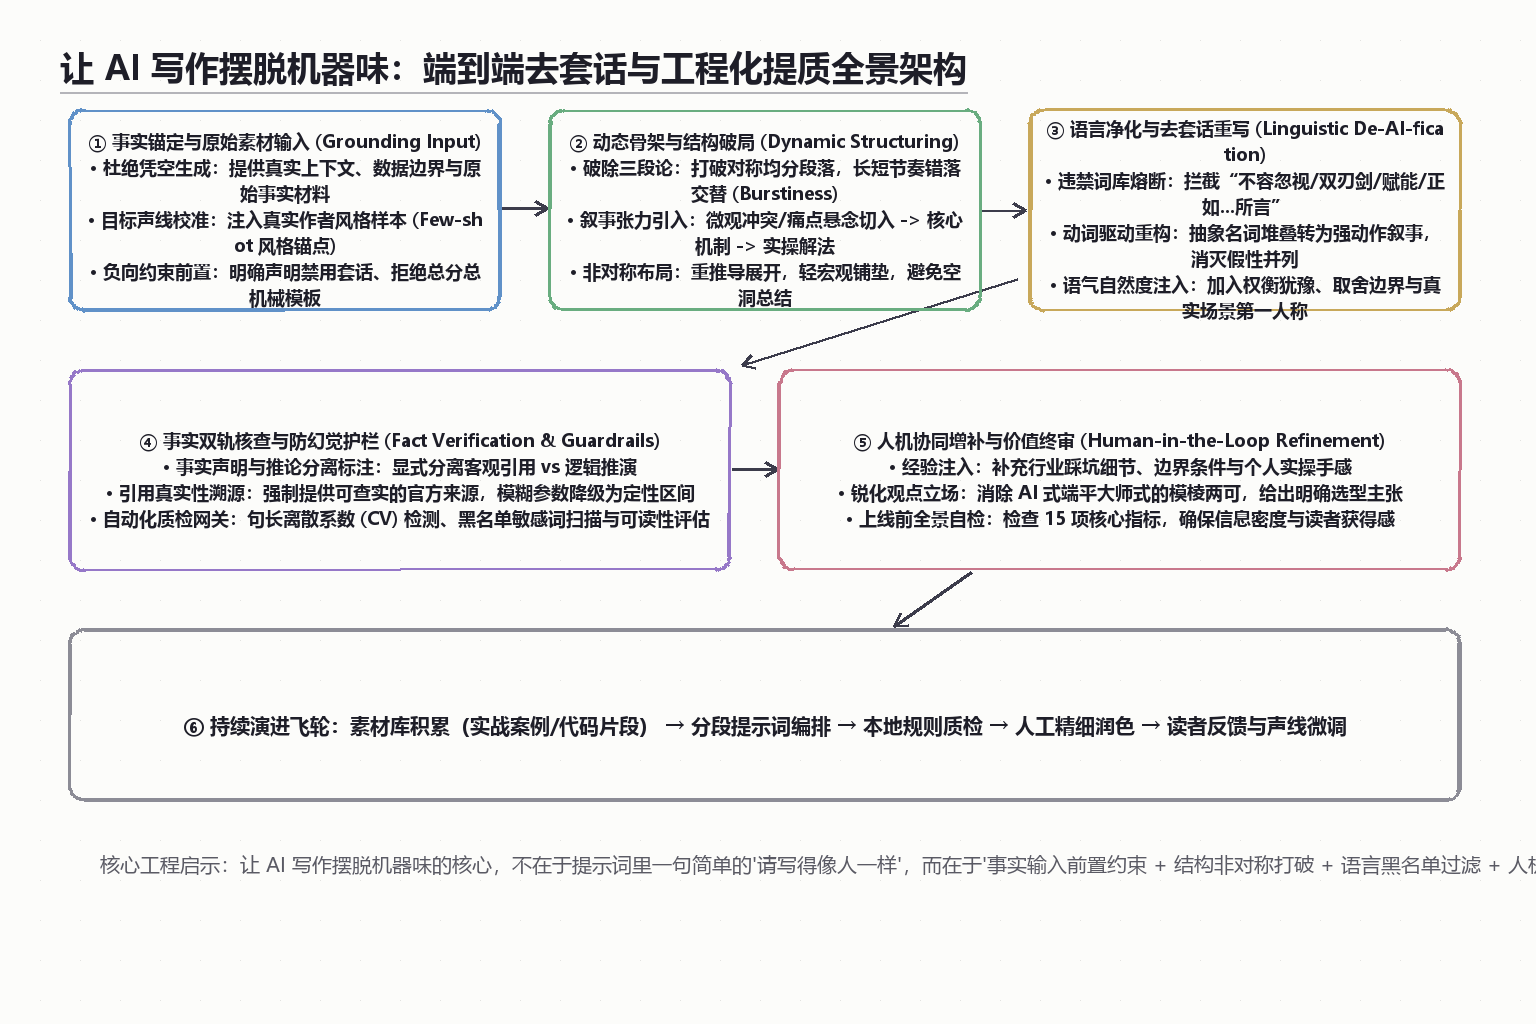
一、解剖“AI 味”:从统计学到语言学的核心病灶
所谓“AI 味”,本质上是自回归大语言模型(Autoregressive LLM)在以最大概率预测下一个 Token 时的统计平均收敛现象。模型在海量语料上训练,天生倾向于选择最稳妥、最安全、最平滑的用词与句式。这种“概率最高”的表达,恰恰是人类写作中最容易被识破的无趣陈词滥调。
具体而言,“AI 味”在文本表层体现为以下五个维度的病灶:
1. 结构均质化与突发度(Burstiness)坍塌
人类写作具有极高的变奏律(Burstiness):在深入阐述一个技术痛点时,可能会写一个包含推导和转折的长句,随后紧跟一个仅有五六个字的短句作为总结定音;某一个核心段落可能长达四百字,而紧随其后的过渡段只有一句话。
反观 AI 生成的文本,段落往往高度均分:引言一段、正文固定三到四个要点、总结一段;每个要点下面固定包含一段背景、一段举例、一段意义,字数严格控制在 120 到 150 字之间。整篇文章的句长方差极低,阅读感受如同单调的节拍器,缺乏呼吸感与情绪起伏。
2. 宏观假大空与微观细节缺失
AI 习惯于从“宇宙起源”或“宏观时代浪潮”切入,热衷于使用宏大叙事掩盖信息的匮乏。例如写一篇关于“数据库慢查询排查”的文章,AI 会花三分之一的篇幅去论述“在现代企业级应用架构中,数据犹如流动的血液,高效的数据处理能力是企业降本增效的关键基石”。而真正面临数据库连接池打满的工程师,需要的是看到 EXPLAIN ANALYZE 的执行计划偏差和索引失效的真实复盘。
3. 套话高密度与虚幻隐喻
由于预训练语料中的高频关联,AI 对某些修辞和连接词有着病态的偏好:
- 八股连接词:总而言之、不可否认、显而易见、正如前文所述、值得注意的是。
- 陈腐比喻:双刃剑、里程碑、催化剂、航标、绘就了一幅…的宏伟画卷。
- 虚张声势的空洞动词:赋能、擘画、深耕、重塑、织就、铺就。
4. “端平大师”式的虚伪客观
为了遵守对齐策略(RLHF)中的安全与中立原则,AI 在面对技术选型、架构争论或趋势判断时,往往极度抗拒表达带有倾向性的观点。它会本能地列出“方案 A 的三大优势与三大劣势”,再列出“方案 B 的三大优势与三大劣势”,最后得出一个放之四海而皆准的废话结论:“两者各有千秋,具体取决于您的业务场景与团队需求。”
这种缺乏实战权衡与技术担当的“假客观”,是技术读者最反感的机器特征之一。真实的工程决策从来不是在两个完美选项中挑选,而是在两个都有缺陷的方案中选择死得较慢、成本可控的那一个。
5. 事实与逻辑悬空(虚假权威)
当 AI 被要求为论点提供论据时,经常会触发概率拼接:
- 虚构权威机构报告:“根据某知名国际咨询机构最新发布的行业调查报告显示……”(既没有机构全名,也没有具体年份与报告名称);
- 伪造精确指标:“能够帮助团队整体研发效率提升 37.5%,运维成本降低 24.2%”;
- 凭空捏造名人名言或文献引用。
下表总结了典型 AI 腔调与自然高质量手写文本的八大关键维度对照:
| 评估维度 | 典型 AI 腔调(机器味浓重) | 自然高质量手写(工程师/专业创作者) |
|---|---|---|
| 开头方式 | 宏观大词铺垫(“在数字化转型的浪潮中……”) | 微观痛点、真实反常现象或具体故障现场直切 |
| 段落排布 | 机械对称(严格 3 大点,每点字数均等,工整对仗) | 节奏错落(长段深度剖析与短句定音交替,非对称展开) |
| 过渡连接 | 机械依赖“首先/其次/再者/最后/总而言之” | 依托逻辑推导天然衔接,用问题推进或因果倒逼 |
| 动词与名词 | 抽象名词堆叠(“进行系统架构层面的优化与推进”) | 强动作动词驱动(“重构连接池,掐断超时慢请求”) |
| 观点倾向 | 骑墙中庸(“各有利弊,取决于具体场景”,无立场) | 立场鲜明(给出清晰的取舍代价与明确的主张) |
| 修辞与隐喻 | 陈旧套话(“双刃剑/里程碑/绘就画卷/赋能”) | 场景化实体隐喻,或完全摒弃修辞、用数据事实说话 |
| 论据与事实 | 模糊权威与精确伪数据(“某知名报告称效率提升 30%”) | 具体版本号、确切配置项、真实可查的公开技术规范 |
| 作者在场感 | 悬空的上帝视角,缺乏个人体验与第一人称犹豫 | 真实第一人称反思、踩坑复盘与边界取舍思考 |
二、结构重塑:打破机械三段论与重建行文张力
要让文章具备人类思维的灵动感,第一步不是改词,而是打破文章的拓扑骨架。任何依赖大模型“一键生成完整大纲”的做法,最终都会收敛到工整无聊的三段论结构。
1. 逆向开篇法:从故障现场与微观切口进入
人类创作者动笔,往往源于某一次具体的踩坑、一个反直觉的数据点、或者同行之间的一次激烈争论。文章的开篇应当抛弃一切背景交代,直接把读者拽入现场。
- 反面示例(AI 习惯):
“自动化测试是现代软件工程中不可或缺的重要组成部分。随着持续集成和持续部署(CI/CD)理念的深入人心,单元测试的覆盖率成为了衡量代码质量的关键指标。然而在实际落地过程中,许多团队却面临着维护成本高昂的挑战……”
- 正面重构(自然真实):
“上周三凌晨两点,生产集群的告警群突然炸了锅。流水线上 800 多个单元测试全部飘绿,但刚上线的结算模块却在第一笔订单进来时直接抛了空指针。事后复盘发现,为了冲刺 85% 的单测覆盖率指标,团队写了大量不带断言的空 Mock。覆盖率数字看上去了无瑕疵,系统却在裸奔。”
通过微观、具体、带有时空感的情境导入,不仅彻底消除了开篇的机器感,还能在 5 秒钟内抓住专业读者的注意力。
2. 引入非对称布局与变奏控制(Burstiness)
在规划章节时,主动打破“三大点、每点分三小点”的对称强迫症:
- 轻量前置,重量推导:基础概念与前置知识压缩在一两个精炼段落内带过,甚至直接给出一句话定义或指向参考链接;
- 重锤深砸核心矛盾:将全篇 60% 以上的篇幅倾注在最复杂、最容易踩坑的深水区模块(例如核心算法实现、性能调优极限推导或边界条件处理);
- 长短交替的句子节奏:在一个深入剖析底层内存泄漏机制的长复句之后,紧随一句干脆利落的陈述:“这根本不是语法问题,而是生命周期错配。”
3. 用问题推进替代序列连接词
如果通篇都是“第一、第二、第三”、“一方面、另一方面”,读者的阅读期待就会被消解。高阶的行文是用问题链与推导因果驱动下文的:
- 提出方案 -> “但这会引发另一个问题:如果并发请求瞬间翻倍,本地缓存被击穿怎么办?”
- 引入机制 -> “解决思路不是增大内存,而是给读取流程加上滑动窗口限流。”
- 审视边界 -> “然而在分布式场景下,单机滑动窗口立刻就会失效。”
这种环环相扣的推进方式,是人类真实技术思考的自然流露,AI 的概率模型很难自发生成这种张力,必须由创作者在骨架层面进行强制约束。
三、语言净化:违禁词库熔断与动词驱动重写
当文章骨架确立后,进入段落语言的起草阶段。消除语言层面的“AI 味”,核心在于建立严格的负向词库拦截机制与动词驱动的句式重构。
1. 高频 AI 废话与套话黑名单
在工程实践中,可以梳理一份明确的“高危敏感词/套话清单”。只要文本中出现这些词汇,必须被无条件熔断并替换为真实、具体的描述:
【高危套话黑名单】
1. 连接与过渡类:总而言之、不可否认的是、值得注意的是、毋庸置疑、显而易见、正如...所说
2. 宏大陈腐隐喻类:双刃剑、里程碑、催化剂、绘就画卷、谱写篇章、航标灯塔
3. 抽象赋能动词类:赋能、深耕、擘画、重塑、织就、铺就、助力、打通底层逻辑
4. 空泛总结排比类:不仅...而且...更...、从...到...再到...、既要有...又要有...
5. 虚假情感共鸣类:让我们拭目以待、未来可期、毫无疑问将带来颠覆性变革
2. 动词驱动重构:消灭“名词化堆叠”
大语言模型非常喜欢将动态的动作转化为抽象的名词组合,这在语言学上被称为“名词化”(Nominalization)。这种句式显得官僚、冰冷且冗长。
- AI 名词化堆叠:
“系统通过对用户请求数据的解析与校验处理,实现了对于潜在恶意载荷的安全拦截机制的生效。”
- 人类动词驱动重写:
“系统直接解析请求参数;一旦嗅探到危险字符,立刻掐断连接并记录日志。”
把句子中的核心动作提炼出来,使用具有具体动作方向的动词(如“掐断”、“剥离”、“压制”、“回滚”、“绕过”),句子的信息浓度与可读性会立刻提升数倍。
3. 在 Prompt 中实施负向约束与少样本风格注入
要让模型在起草阶段就减少套话输出,不能只给正向要求,必须配合显式的负向约束(Negative Constraints)与少样本(Few-shot)风格样本。
以下是一套经过实战检验的高鲁棒性 Prompt 指令模板:
# 角色与写作目标
你是一名拥有 10 年一线架构与运维经验的资深工程师。请根据我提供的真实技术素材,起草关于 [具体主题] 的实战剖析段落。

# 语言与行文硬性约束(违反任何一条均视为不合格输出)
1. 严禁使用任何套话:禁止出现“总而言之/不可否认/双刃剑/赋能/深耕/重塑/画卷/里程碑/不仅...而且...更...”等词汇。
2. 严禁宏观大词开篇:禁止从“数字化转型/时代浪潮/重要基石”等宏观背景切入,必须从具体的异常现象、参数异常或微观代码片段展开。
3. 杜绝端平大师式假客观:在方案对比时,必须给出明确的技术取舍主张和适用的边界条件,禁止写“各有优劣取决于具体需求”此类废话。
4. 句式与节奏要求:打破句式工整性,混合使用 5-10 字短句与复合推导句;严禁段落字数均等;动词优先,消灭抽象名词堆叠。
5. 事实诚信原则:严禁编造任何咨询机构名称、精确百分比提升数据或文献出处;凡涉及不确定数据,必须使用“通常在...区间”、“在特定压测场景下”等严谨定性描述。

# 参考风格样本(Few-shot)
输入场景:解释缓存雪崩
合格输出:“缓存雪崩最怕的不是单台 Redis 挂掉,而是同一批大促商品键在凌晨整点同时过期。DB 线程池在 200 毫秒内被瞬间打满,慢查询堆积引发级联超时。解法没有魔法:过期时间必须叠加 10%-20% 的动态随机抖动,同时把互斥锁粒度细化到业务 ID 级别。”
四、事实防线:双轨核查与数据防幻觉护栏
在 AdSense 审核或专业读者的显微镜下,AI 生成内容最致命的硬伤不仅是语言腔调,更是事实幻觉与伪造引用。一旦文章中出现编造的 API 名称、不存在的协议规范或虚假的调研数据,整篇文章的专业信用就会彻底归零。
为此,必须在内容工作流中建立事实双轨核查机制:
[原始生成内容]
       │
       ▼
 ┌──────────────────────────────────────────────┐
 │  事实声明与推论分离标注 (Claim-Inference Separation)  │
 └──────────────────────┬───────────────────────┘
                        │
          ┌─────────────┴─────────────┐
          ▼                           ▼
 ┌─────────────────┐         ┌─────────────────┐
 │   客观事实声明  │         │   逻辑推演结论  │
 │ (Fact Claims)   │         │  (Deductions)   │
 └────────┬────────┘         └────────┬────────┘
          │                           │
          ▼                           ▼
 ┌─────────────────┐         ┌─────────────────┐
 │ 权威信源交叉溯源│         │ 业务因果链审视  │
 │ (查规范/查代码) │         │ (推导是否自洽)  │
 └────────┬────────┘         └────────┬────────┘
          │                           │
          └─────────────┬─────────────┘
                        │
                        ▼
 ┌──────────────────────────────────────────────┐
 │          事实核查五步漏斗 (5-Step Funnel)           │
 │ 1. 溯源检索 -> 2. 交叉印证 -> 3. 时效核验     │
 │ 4. 边界界定 -> 5. 定性降级 (淘汰伪精确数值)   │
 └──────────────────────┬───────────────────────┘
                        │
                        ▼
                [合格交付文本]
1. 事实声明与逻辑推演显式分离
在审查 AI 初稿时,将文本解构为两类成分:
- 客观事实声明(Fact Claims):例如“PostgreSQL 16 引入了
pg_stat_io视图”、“HTTP/3 底层基于 QUIC 协议使用 UDP 传输”。这类内容必须要求对应官方文档、Release Notes 或 RFC 规范的明确索引。 - 逻辑推演结论(Deductions):例如“在长连接高并发场景下,使用状态机比深度嵌套回调更容易排查内存泄漏”。这类内容重点审查因果链条是否自洽、有无逻辑跳跃。
2. 数据与引用的“三不原则”
- 不凭空引述机构:只要没有具体的调研机构英文全称、具体发布月份与报告标题,一律直接删除所谓“第三方权威调查显示”的字样;
- 不给出无法复现的微观价格与精确百分比:云厂商的计费规则、API 调用价格极度动态,且带有地域和套餐梯度,严禁在正文中写死具体数字,必须使用“按量计费处于每千 Token 厘级区间”或“在百兆带宽基准下”等定性或区间表述;
- 不引用未验证的代码库或第三方库:所有正文提及的开源项目或依赖库,必须核验其在 GitHub 或官方源上的真实存在性、最新版本维护状态与协议许可证。
3. 事实核查五步漏斗法
当遇到 AI 输出的一项技术参数或结论时,按照五步漏斗依次筛选:
- 溯源检索:在官方一手源(RFC、官方 Docs、源码仓库 commit)中核对是否存在;
- 交叉印证:对比两个以上独立权威信源的描述差异;
- 时效核验:确认该特性在当前主流长效支持版本(LTS)中是否已被弃用或行为发生变更;
- 边界界定:补全该方案生效的前提条件(例如“仅在 Linux 内核 5.4 以上启用 eBPF 时生效”);
- 定性降级:若无法获取确凿一手统计样本,主动将孤立的精确数值降级为工程区间(例如把“性能提升 35%”改为“在单机万级并发基准下,P99 延迟有可观察的收敛”)。
五、工程化落地:构建本地自动化“去 AI 味”质检网关
为了避免纯靠人工肉眼筛查带来的疲劳与遗漏,我们可以将语言学指标和禁词规则固化为一套本地自动化质检网关脚本。
该脚本基于三大核心指标进行量化打分:
- 句长离散系数(Coefficient of Variation, CV):$CV = \frac{\sigma}{\mu}$,反映句子长度的波动程度。人类高质量写作的 $CV$ 通常在 0.55 到 0.85 之间(长短结合,高波动态势);而 AI 写作的 $CV$ 往往低于 0.35(句长高度同质化)。
- 套话与黑名单词频密度(Cliché Density):每千字中出现的“AI 腔调词汇”频次。
- 段落对称度惩罚(Paragraph Symmetry Penalty):检测主体章节段落长度的方差。
以下是完整的 Python 自动化质检脚本实现,可以直接作为 CI 流水线或本地发布前的 Git Hook:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
TextHumanizeLinter - 文本去 AI 腔自动化质检网关
用于量化检测文本中的句长变奏律、套话密度与段落对称性。
"""

import re
import math
from typing import List, Dict, Any


class TextHumanizeLinter:
    # 典型 AI 高频套话与连接词黑名单
    CLICHE_WORDS = [
        "总而言之", "不可否认的是", "不可否认", "显而易见", "值得注意的是",
        "毋庸置疑", "正如前文所述", "双刃剑", "里程碑", "催化剂",
        "赋能", "深耕", "擘画", "重塑", "织就", "铺就", "绘就",
        "不仅如此", "毫无疑问", "未来可期", "拭目以待", "画卷"
    ]

    def __init__(self, text: str):
        self.raw_text = text
        # 剥离 Markdown 标题、代码块与前置元数据
        self.clean_text = self._clean_markdown(text)

    def _clean_markdown(self, text: str) -> str:
        # 移除 front-matter
        text = re.sub(r"^---[\s\S]*?---\n", "", text)
        # 移除代码块
        text = re.sub(r"```[\s\S]*?```", "", text)
        # 移除图片与行内链接
        text = re.sub(r"!\[.*?\]\(.*?\)", "", text)
        text = re.sub(r"\[.*?\]\(.*?\)", "", text)
        # 移除 Markdown 标题标记
        text = re.sub(r"^#+\s+.*$", "", text, flags=re.MULTILINE)
        return text.strip()

    def split_sentences(self) -> List[str]:
        # 中文断句规则:句号、叹号、问号、分号及换行
        raw_sents = re.split(r"[。!?;\n]+", self.clean_text)
        sentences = [s.strip() for s in raw_sents if len(s.strip()) >= 3]
        return sentences

    def split_paragraphs(self) -> List[str]:
        raw_paras = self.clean_text.split("\n\n")
        paragraphs = [p.strip() for p in raw_paras if len(p.strip()) >= 20]
        return paragraphs

    def calculate_burstiness(self, sentences: List[str]) -> Dict[str, float]:
        if not sentences:
            return {"mean": 0.0, "std": 0.0, "cv": 0.0}
        lengths = [len(s) for s in sentences]
        mean = sum(lengths) / len(lengths)
        variance = sum((x - mean) ** 2 for x in lengths) / len(lengths)
        std = math.sqrt(variance)
        cv = (std / mean) if mean > 0 else 0.0
        return {"mean": round(mean, 2), "std": round(std, 2), "cv": round(cv, 4)}

    def scan_cliches(self) -> List[Dict[str, Any]]:
        hits = []
        for word in self.CLICHE_WORDS:
            count = len(re.findall(re.escape(word), self.clean_text))
            if count > 0:
                hits.append({"word": word, "count": count})
        return sorted(hits, key=lambda x: x["count"], reverse=True)

    def evaluate(self) -> Dict[str, Any]:
        sentences = self.split_sentences()
        paragraphs = self.split_paragraphs()
        burstiness = self.calculate_burstiness(sentences)
        cliches = self.scan_cliches()
        total_chars = len(self.clean_text)

        # 套话总发生率(每千字发生频次)
        total_cliche_count = sum(item["count"] for item in cliches)
        cliche_density = (total_cliche_count / (total_chars / 1000.0)) if total_chars > 0 else 0.0

        # 评分算法逻辑(满分 100 分):
        # 1. 句长离散系数 (CV):> 0.6 得 40 分;0.4-0.6 得 25-35 分;< 0.4 属于机器高危,扣至 10 分
        cv = burstiness["cv"]
        if cv >= 0.60:
            score_burstiness = 40.0
        elif cv >= 0.45:
            score_burstiness = 30.0 + (cv - 0.45) / 0.15 * 10.0
        else:
            score_burstiness = max(5.0, cv / 0.45 * 25.0)

        # 2. 套话密度:0 次扣 0 分(得 40 分);每千字出现 1 次扣 10 分,扣完为止
        score_cliche = max(0.0, 40.0 - (cliche_density * 12.0))

        # 3. 基础字数与信息密度保障(得 20 分)
        score_volume = 20.0 if total_chars >= 2500 else (total_chars / 2500.0 * 20.0)

        final_score = round(score_burstiness + score_cliche + score_volume, 1)
        level = "HUMAN_NATURAL" if final_score >= 80 else ("BORDERLINE" if final_score >= 60 else "AI_FLAVORED")

        return {
            "final_score": final_score,
            "level": level,
            "total_chars": total_chars,
            "sentence_count": len(sentences),
            "paragraph_count": len(paragraphs),
            "burstiness": burstiness,
            "cliche_density_per_kilo": round(cliche_density, 2),
            "cliche_hits": cliches
        }


if __name__ == "__main__":
    import sys
    test_text = """
    不可否认的是,在数字化转型的浪潮中,大语言模型赋能了各行各业。
    它如同一把双刃剑,既带来了前所未有的效率提升,也带来了潜在的挑战。
    总而言之,我们需要深耕技术底层,绘就智能化的宏伟画卷。
    """
    linter = TextHumanizeLinter(test_text)
    report = linter.evaluate()
    print("质检结果:", report)
在工程实践中,任何初稿在进入人工精修环节前,都可以先通过上述脚本跑出评分。如果 $CV$ 低于 0.45 或者套话密度大于 1.5,直接退回给重写流程或由脚本自动标注高危段落,极大地压缩了人工校对的盲目时间。
六、人机协同闭环:从生成到交付的高效工序
消除“AI 味”并不是全盘拒绝大模型,而是把大模型放在合适的位置上。大模型擅长结构化整理、语法纠错、多维视角发散与初稿扩充;而人类创作者掌控核心假设、真实痛点输入、技术立场抉择与灵魂注入。
高水准的人机协同工序分为以下四个严密的阶段:
阶段 1:材料准备与背景约束(冷启动阶段)
- 绝不让 AI 凭空写文章:在唤醒模型前,创作者必须提供一手“硬核输入”。包括:本地调试的真实错误堆栈、生产压测的数据截图文本提取、两到三个关键架构选型争议点、核心配置文件的关键片段。
- 确立写作边界:明确规定“本文不讨论 X,只聚焦在 Y 场景在 Z 约束下的最优解法”。
阶段 2:分块受控起草(禁止一键起草全篇)
- 严禁输入一个题目后要求 AI 输出 5000 字长文。这种“长程依赖”会导致模型在中后期不可逆地陷入自说自话与车轱辘话。
- 采用章节迭代法:每次只让模型根据提供的子素材起草一个
##小标题。生成完毕后,创作者立即进行快速审阅与微调,再带着微调后的上下文输入下一个章节。
阶段 3:自动化脚本质检过滤
- 运行类似
TextHumanizeLinter的本地校验工具,扫描全文的套话密度与离散度。 - 将识别出的高危连接词(如“总而言之/双刃剑/赋能”)与句长高度一致的均质段落进行高亮标记,强制重构。
阶段 4:人工“注入灵魂”(价值终审)
人工重写阶段不是改标点符号,而是重点增补三样 AI 永远无法生成的东西:
- 第一人称真实踩坑经历:“我们在某次机房断电演练中遇到了这个极端情况,原本设计的优雅降级全部失效了……”;
- 鲜明而有代价的技术主张:“如果你的日活跃用户不到十万,坚决不要碰分布式事务中间件,乖乖用本地单库事务与消息最终一致性”;
- 具象的生活化细节与工程直觉:“排查这个网络抖动问题,排查人员在机房连续喝了四罐红牛,最后发现是交换机上一根被折弯了 90 度的劣质跳线”。
七、生产上线:高质量内容 15 项自检清单
在将文章正式推送到静态站点并发布上线前,建议根据以下 15 项准入标准进行逐一核对。只有全部达标,内容才具备极强的读者价值与长效生命力:
| 检查维度 | 序号 | 具体检查项 | 达标判定标准 |
|---|---|---|---|
| 标题与开篇 | 01 | 标题是否具体明确并包含真实场景/方法论? | 拒绝纯标题党与抽象大词,包含具体对象与实操限定 |
| 02 | 开篇前 100 字是否杜绝了宏观废话与时代浪潮铺垫? | 直接从痛点、故障、反直觉事实或微观情境切入 | |
| 结构与节奏 | 03 | 句长变异系数(CV)是否处于健康区间? | 本地自动化检测 $CV \ge 0.55$,长短句错落交织 |
| 04 | 是否彻底打破了各章节字数严格对称的均质化布局? | 核心机制段落深度剖析,辅助段落轻盈精炼 | |
| 05 | 是否消灭了“首先/其次/最后”等生硬的序列词? | 依靠逻辑推导、矛盾反问与因果链条自然过渡 | |
| 词汇与语言 | 06 | 是否全篇清零了“双刃剑/赋能/重塑/画卷”等 AI 禁词? | 自动化套话密度检测为零命中 |
| 07 | 是否将“进行…的优化”等抽象名词化表达转换为强动词? | 句子主体由精准动作驱动,消灭官僚式排比 | |
| 08 | 观点表述是否具备明确的技术立场与取舍代价? | 拒绝“端平大师”,明确指出适用的边界与劣势代价 | |
| 事实与论据 | 09 | 引用的所有框架、库名与 API 是否真实可查并核实了版本? | 在官方文档或 GitHub 仓库中得到一手验证 |
| 10 | 是否淘汰了无法溯源的“某权威报告”与微观精确伪数据? | 均有确切信源,非一手数据主动降级为定性区间 | |
| 11 | 代码片段与命令是否完整、可复现并包含防御性注解? | 关键代码无语法伪代码漏洞,包含边界异常处理 | |
| 视觉与排版 | 12 | 是否包含至少一张结构清晰的高清逻辑架构示意图? | 图片路径与渲染正常,信息层次分明 |
| 13 | 复杂多维对比是否采用清晰的 Markdown 表格呈现? | 核心参数与方案优劣结构化整理,方便读者检索 | |
| 读者价值 | 14 | 读完后读者是否能照着文章复现成果或完成某项决策? | 提供可落地的代码、配置模板、自检清单或决策漏斗 |
| 15 | 文章末尾是否提供了真实的互动交流与反馈渠道? | 保留开放的讨论入口,促进技术社区良性互动 |
结语:让 AI 成为画笔,而不是画手
摆脱“AI 味”的终极法门,不在于掌握多么精妙玄奥的提示词咒语,而在于认清人与机器的分工边界。
大语言模型是一个无比庞大、反应迅捷的可能世界联想机。它拥有近乎无限的词汇量与结构记忆,但它没有体温,没有在深夜排查故障时的焦虑,没有架构方案上线被用户认可时的喜悦,更没有为工程灾难承担责任的勇气。
如果把整篇文章的创作主权全盘交给 AI,输出的必然是一篇毫无生气的统计学平庸之作;但如果由创作者提供带有真实痛点的硬核素材,用严格的负向规则约束其结构与语言,并在生成后以挑剔的工程师视角进行二次雕琢与事实审校,AI 便会成为一支极其强大的数字画笔。
在日常的内容生产或企业技术文档建设中,如果你对如何搭建自动化的去套话质检脚本、或如何将提示词工程与领域工作流深度整合有任何疑问与实战想法,欢迎随时通过 联系方式 与我们深入探讨交流。