过去两年里,AI 图像生成技术经历了从学术惊艳到大众娱乐、再到工业级生产力落地的剧烈演进。无论是消费级领域的“输入一句咒语即刻生成大片”,还是设计行业对自动化批量出图的探索,AI 绘图早已脱离了最初低像素、扭曲手指的玩具阶段。
然而,当技术从个人的“抽卡自娱”走向严肃的企业级商业交付时,团队往往会迅速遭遇现实的冰水:
- 可控性匮乏:文字提示词极难精确描述复杂的构图、透视与特定产品的微小结构;
- 一致性崩溃:同一个角色在不同分镜中频频“换脸”,同一件商品换背景后尺寸比例与颜色严重失真;
- 合规与版权迷雾:生成的图像究竟能否享有著作权?是否侵犯了原作者的版权或公众的肖像权?商业使用时会不会遭遇下架或法律追责?
本文旨在为从事数字营销、电商运营、游戏美术、品牌设计的专业从业者及工程团队,提供一份全景式的技术选型与商用实操指南。我们将从技术底座演进、文生图与图生图的精确控制层级,深入探讨角色与资产一致性工程,并重点厘清商业使用的版权红线与合规防线,最后给出一套可直接落地的企业级质检清单与选型决策漏斗。
1. 技术底座演化:从扩散模型到整流匹配(DiT)
理解 AI 生图工具的边界,首先需要理解其底层的图像生成范式是如何演进的。
早期的生成对抗网络(GAN)在人脸生成等特定垂类表现出色,但在处理开放领域的复杂文字描述时极易发生模式崩溃(Mode Collapse)。自 2022 年起,潜空间扩散模型(Latent Diffusion Models, LDM)奠定了文生图的主流基础,其核心逻辑是在低维隐空间中向潜向量持续注入高斯噪声,再训练神经网络逐步去噪重建图像。
而近期的技术突破则全面转向了扩散变换器架构(Diffusion Transformer, DiT)与整流匹配(Flow Matching)。相比传统基于 U-Net 骨干网络的模型,DiT 具备三大关键优势:
- 长程上下文理解能力:基于 Transformer 的全局注意力机制,能够真正理解长达数百词的复杂排版、多个实体的空间位置关系与相互作用;
- 文字渲染保真度:突破了过去生成画面中文字必乱码的顽疾,能够精准在招牌、海报、标签上渲染拼写正确的英文和常见字体;
- 图像解耦与高分辨率原生训练:支持原生任意画幅长宽比直出,减少了非标比例下的肢体重叠与画面畸变。
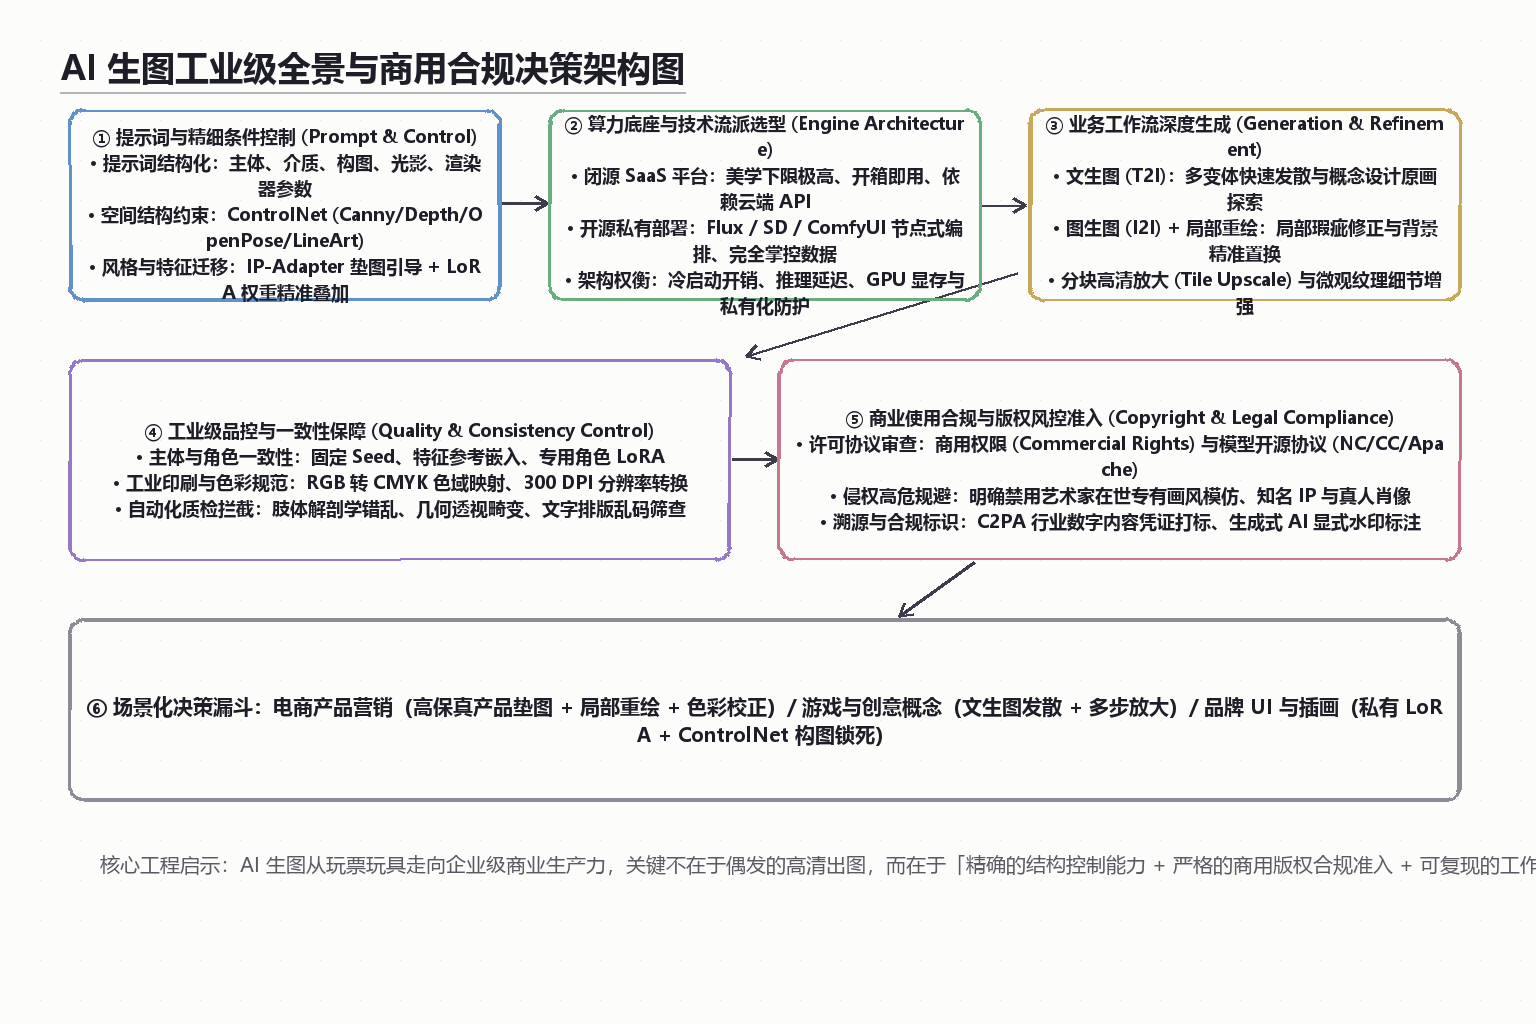
在实际生产中,工具选型主要分为两大阵营:闭源商业云服务与开源私有化部署生态。
2. 主流技术流派与工具生态全景对比
企业在选择工具栈时,往往在“追求开箱即用的美学质量”与“追求对生产链路的绝对控制权”之间权衡。下表总结了当前主流工具流派的核心特征:
| 评估维度 | 闭源商业 SaaS / 托管 API(如 Midjourney、DALL-E 3、Ideogram 等) | 开源私有化引擎(如 Stable Diffusion XL、Flux、SD 1.5 系列) |
|---|---|---|
| 典型代表形态 | Discord 机器人、Web 交互工作台、标准化 REST API | ComfyUI 节点编排系统、WebUI、本地/自建云推理集群 |
| 美学下限与直出率 | 极高;提示词鲁棒性强,无需调参即可产出高完成度商业视觉 | 依赖底模、LoRA 及工作流调优,裸模型直出效果参差不齐 |
| 精确空间与结构控制 | 较弱;主要依赖文字与简单垫图,难以像素级限定骨骼与边缘 | 极强;支持 ControlNet、IP-Adapter、Regional Prompt 精准约束 |
| 文本渲染与排版 | 头部工具表现优异,英文标语及短语拼写准确率高 | 现代 DiT 架构模型大幅提升,老旧 U-Net 模型几乎不可用 |
| 数据与资产保密性 | 提示词与参考图需上传第三方云端,可能面临模型二次训练风险 | 权重完全本地运行,未授权数据不离开企业内网安全域 |
| 批量化与流水线编排 | 受制于并发限流与第三方 API 计费模式,定制自动化链路成本高 | 可深度集成 CI/CD、企业 ERP、电商后台,节点逻辑完全可编排 |
| 商用权利明确度 | 依赖各平台订阅层级的服务协议(ToS),规则可能动态调整 | 遵循模型开源许可证(如 Apache 2.0、OpenRAIL、非商用限制协议) |
选型核心洞察
- 创意探索与前期提案:优先选择闭源 SaaS。其极高的美学审美偏置能够帮助创意总监、策划人员在短时间内批量发散灵感、产出情绪板(Moodboard)与提案演示。
- 量产交付与私有化生产:必须引入开源私有化架构(尤其是以 ComfyUI 为代表的节点式流水线)。商业交付要求 100% 确定性的构图、精确的品牌色调匹配以及与企业内部系统的无缝串联,黑盒 API 难以支撑严格的工业级验收。
3. 从发散到确定:三大核心生成范式的工业级应用
商业视觉设计绝不是“碰运气”的过程。生产环境下的生图流程,通常是由文生图、图生图以及局部修复交织构成的渐进式收敛工作流。
[概念探索阶段]                 [结构锁定阶段]                   [工业精修阶段]
  文生图 (T2I)       ───►       图生图 (I2I) + ControlNet   ───►   局部重绘 (Inpainting)
  (发散创意构图与风格)           (锁定边缘、深度与人物骨架)         (修补手部/面部瑕疵,置换局部)
                                                                    │
                                                                    ▼
                                                            分块高清放大 (Tile Upscale)
                                                            (突破像素限制,注入微观细节)
3.1 文生图(Text-to-Image):结构化提示工程
在工程化应用中,低效的“形容词堆砌”必须被结构化的 Prompt 语法替代。一套高鲁棒性的文生图提示词应当具备明确的层级分工:
$$\text{Prompt} = \text{核心主体 (Subject)} + \text{环境场景 (Context)} + \text{构图与视角 (Framing)} + \text{材质与光影 (Lighting)} + \text{风格媒介 (Style/Medium)}$$
- 主体层:清晰定义核心对象、材质、状态(例:
a minimalist ceramic coffee mug with matte finish); - 环境层:避免笼统的“背景好看”,写明具体的环境元素、光照朝向(例:
placed on a rough concrete surface, soft morning sunlight casting long shadows from the left); - 构图层:指明景别与镜头语言(例:
low-angle close-up shot, 85mm portrait lens, shallow depth of field); - 质感层:明确渲染引擎或胶片特性,杜绝使用无意义的“超高清”、“大师之作”等占位词。
3.2 图生图(Image-to-Image)与条件引导技术
图生图的本质是在已有图像潜向量的基础上添加一定比例的噪声(Denoising Strength,去噪幅度),并在此基础上引导模型重新生成。
- 低去噪幅度(0.2 - 0.4):保留绝大部分原始线条与轮廓,仅改变局部光影质感或画面风格;
- 高去噪幅度(0.6 - 0.8):大幅重组画面内容,保留粗略色块与几何布局,适合做剧烈变体。
然而单纯调整去噪幅度无法满足商业精度需求。工业界的主流解法是引入多模态条件控制组件:
- ControlNet(几何与空间控制):
- Canny / LineArt(线稿边缘):精准提取产品包装、工业制件的外轮廓线,确保商品几何形状在生成时分毫不差;
- Depth(深度图):保留画面的前后景深空间结构,换背景时透视关系绝不崩塌;
- OpenPose(人体骨骼姿态):锁定模特的站姿、手势和动态角度,解决文生图难以精准摆姿态的痛点。
- IP-Adapter(图像特征引导):
- 绕过文字提示词难以描述的细微纹理,直接将参考图的视觉语义向量注入跨注意力层。例如上传一张特定材质布料或艺术品,让新画面无缝继承该材质特征。
3.3 局部重绘(Inpainting)与高保真超分辨率
商业设计中最忌讳“因一处瑕疵而推翻重来”。
- 局部重绘(Inpainting):将生成图中的手部、面部、商标错乱区域制作成遮罩(Mask),仅对遮罩区域进行重新采样去噪。结合专用重绘模型(Inpainting Model),可以在保持背景与环境光完全不变的前提下,迭代修复手部肢体或替换画面主体。
- 分块高清放大(Tile Upscaling):普通模型在直接输出 $2K$ 或 $4K$ 图像时,由于显存瓶颈与注意力机制感受野限制,极易出现“多头、多肢”的重复图案。工业方案采用分块模糊扩散放大:将图像切分为带有重叠重采样区域的图块(Tiles),分别注入微弱噪声重建微观毛孔、纤维质感,最后缝合拼装,能够稳定产出满足印刷标准的超高清物料。
4. 商业落地最大的拦路虎:一致性(Consistency)攻坚方案
任何严肃的商业项目(如系列故事画册、跨渠道广告广告活动、虚拟品牌代言人、电商商品换景)都会面临一个致命问题:如何让同一个主体在多张图像中保持完全一致?
如果同一主角换个场景就换了五官轮廓,或者同一款运动鞋在不同角度下鞋底纹理变异,AI 产出就无法通过专业验收。当前成熟团队解决一致性问题主要依赖以下三大路径:
                   ┌────────────────────────────────────────┐
                   │    商业级主体一致性解决方案全景        │
                   └────────────────────────────────────────┘
                                       │
      ┌────────────────────────────────┼────────────────────────────────┐
      ▼                                ▼                                ▼
【轻量即时级】                   【特征引导级】                   【深度权重级】
固定 Seed + 提示词微调            IP-Adapter + 垫图参考           定制 LoRA / 微调底模
• 优势:零额外训练成本           • 优势:单张参考图即可生效      • 优势:多角度极高复原度
• 劣势:动作大时面部崩塌         • 劣势:难以捕捉极端微观特征    • 劣势:需清洗多张训练素材
• 适用:静态肖像微调             • 适用:服装款式/空间风格迁移   • 适用:企业虚拟人/核心标品
4.1 方案 A:特征注入与跨注意力适配(IP-Adapter Face / Clip-Vision)
无需训练专用模型,在推理阶段将人物的面部对齐裁剪图(Crop Face)输入 Clip-Vision 编码器,提取面部语义特征,并通过解耦交叉注意力(Decoupled Cross-Attention)强制注入到生成流程中。结合 ControlNet OpenPose 锁死骨骼,可以实现让同一角色在不同场景中做出各种指定动作。
4.2 方案 B:轻量级微调(LoRA,Low-Rank Adaptation)
针对企业长期使用的核心视觉资产(如企业 IP 吉祥物、虚拟代言人、主力产品硬件):
- 收集并清洗 15–30 张不同光照、不同景深、不同角度的高清素材;
- 规范编写详细的标注文本(Captioning),将特征与特定触发词(Trigger Word)绑定;
- 微调 U-Net 或 DiT 的注意力权重,训练生成体积仅数十兆至数百兆的 LoRA 权重文件。
在实际调用时,只需载入该 LoRA 并在提示词中加入触发词,即可在任何场景中稳定复现该主体,面部与结构相似度通常可达 95% 以上。
4.3 方案 C:电商产品的“硬性遮罩+边缘融合”(Matting & Inpainting Blend)
对于工业制造标品(如手机、腕表、化妆品瓶身),任何试图通过 AI “重画一遍”的做法都是错误的,因为商业客户要求每一个按钮、每一行丝印文字必须百分百保真。
正确工程做法:
- 拍摄商品高精度白底摄影图;
- 采用算法(如 RMBG / Segment Anything)进行发丝级抠图,提取核心商品图层;
- 将商品图层放置于目标草图的透视视点上;
- 仅将其余外围背景区域设为重绘遮罩,利用图生图生成环境光照与倒影,并使用环境反光对商品边缘进行轻微调色融合。通过这种“产品硬保真,背景全生成”的混合架构,彻底规避商品形变风险。
5. 商业使用的法律边界与版权红线
AI 生图技术日臻成熟,但全球范围内的法律与合规框架仍处于剧烈变动中。企业使用 AI 图像用于广告宣传、商品包装、软件 UI 或出版物时,面临着显著不同于传统外包设计的法律风险。
5.1 著作权归属:AI 生成物能否获得版权保护?
各国司法实践目前呈现出高度分化但逐步明朗的趋势:
- 美国司法与版权局(USCO)立场:坚持“人类作者(Human Authorship)”原则。在 Thaler v. Perlmutter 及 Zarya of the Dawn 等标志性案件中,版权局认定:单纯由人类输入文字提示词、由算法随机生成的图像,不受美国著作权法保护,属于公有领域(Public Domain)。人类仅对经过人工实质性挑选、排版组合或大幅手动手绘加工的衍生部分享有版权。
- 中国司法判例探索:在具有广泛影响力的“AI 文生图第一案”(北京互联网法院(2023)京0491民初11279号)中,法院审理认定:若原告在创作过程中投入了智力劳动——包括精心设计提示词、反复调整参数(种子数、CFG 权重、迭代步数)、精选并最终呈现特定构图——该生成图像体现了创作者的个性化表达,具备独创性,认定为美术作品并受到著作权法保护。
企业启示:即便在认可独创性的法域,企业若想主张 AI 图像的排他性版权,必须完整归档全流程的创作过程链条(提示词版本变更、工作流配置参数、草图底稿、中间分层 PSD 修改记录),以证明人类在创作中存在实质性智力投入。
5.2 侵权高危雷区分析
在商业应用中,即便图像由模型自发计算得出,以下三类行为依然属于极高侵权风险:
                 ┌────────────────────────────────────────┐
                 │      AI 生图商用侵权三大高危雷区       │
                 └────────────────────────────────────────┘
                                       │
      ┌────────────────────────────────┼────────────────────────────────┐
      ▼                                ▼                                ▼
【雷区一:在世艺术家风格模仿】        【雷区二:知名商业 IP 侵权】      【雷区三:真实人物肖像侵权】
在提示词中显式指定“in the style     生成具有高辨识度的动漫角色、电影  使用知名公众人物、明星肖像
of [在世艺术家]”,复刻其专有风格     形象、知名产品外观或注册商标      垫图,或提示词直接指名生成
• 风险:不正当竞争/侵权诉讼 • 风险:商标侵权与著作权侵权惩罚 • 风险:侵犯肖像权、人格权- 显式模仿在世艺术家的专有风格:虽然普遍法理认为“单纯的艺术风格不受版权保护”,但在提示词中直接注入知名在世艺术家姓名(如
in the style of [Artist])并用于商业营利,在全球多起集体诉讼中正被指控构成不正当竞争及商业搭便车。商业项目应全面禁止在 Prompt 中使用具体的当代个人创作者名字,转而用流派中性词(如Neo-Impressionism,Cyberpunk Concept Art)替代。 - 知名 IP 与商标要素渗透:现代基础模型吞吐了海量互联网数据,当提示词涉及某些特定科幻、超级英雄或动漫关键词时,极易无意识生成具有独创性表达的受保护形象(如米老鼠耳朵轮廓、宝可梦生物特征)。只要最终展示的图像与权利人的独创性表达构成实质性相似,无论由谁绘制均构成侵权。
- 真人肖像权与深度伪造(Deepfake)防范:在未取得正式授权的情况下,使用明星、KOL 甚至员工本人的照片制作 LoRA 并生成商业宣传物料,直接违反民法典中关于肖像权与人格权的规定。商业虚拟代言人应采用多面孔混合融合(Face Blend)技术,确保生成面孔与任何真实存在的人均无唯一对应关系。
5.3 平台服务条款(ToS)与商业授权陷阱
许多团队误以为“只要付费开通了会员,就可以随意商用”。事实并非如此:
- 免费层与付费层差异:部分主流平台明确规定,免费版账号生成的图像归属于公有领域或需采用 CC-BY-NC(非商业使用)协议;唯有高级付费订阅(Pro/Business)在订阅有效期内生成的图像才享有完全商业使用权。
- 开源许可证的限制性条款:
- Apache 2.0 / MIT 许可证:商业友好,允许商用、二次修改与闭源集成;
- CreativeML OpenRAIL 系列:包含“可接受使用政策(AUP)”,明确禁止用于特定军事、骚扰或未经授权的面部识别场景;
- Non-Commercial(NC)限制:诸如部分社群分享的检查点权重或 LoRA 明确标注了
CC-BY-NC或私有非商用条款。一旦企业将使用了此类 LoRA 的海报投入商业推广,将直接面临违约与侵权追偿。
5.4 C2PA 标准与内容溯源合规
随着全球范围内对生成式 AI 监管政策的收紧,主流硬件厂商、操作系统和社交媒体平台正在全面接入 C2PA(内容来源与真实性联盟) 元数据标准。
主流闭源模型(如 DALL-E 3 等)会在生成的图片 EXIF/XMP 数据中深度嵌入不可见或数字签名的凭证(Content Credentials),记录其生成引擎、时间戳与修改历史。企业在构建全链路流水线时,切勿盲目编写脚本暴力剥离 C2PA 凭证,而应建立合规的内容发布标准,确保商业展示符合当地监管对于“AI 生成内容显式标识”的法定义务。
6. 实战工程落地:电商物料端到端自动化流水线
为了将上述方法论付诸实践,我们展示一个在电商场景下被广泛采用的工程化流水线逻辑:从单一白底摄影原片,自动生成多套风格化营销海报,并自动执行风控质检。
[原始白底图] ──► [自动抠图与尺寸标准化] ──► [注入背景提示词 + ControlNet 边缘约束]
                                                       │
                                                       ▼
                                            [图生图渲染环境与倒影]
                                                       │
                                                       ▼
                                            [自动化质检网关 (QA Gateway)]
                                            ├─ 1. 色彩直方图偏移校验
                                            ├─ 2. 边缘结构相似度 (SSIM)
                                            └─ 3. 人类感官异常拦截
                                                       │
                                                       ▼
                                            [通过: 压标合规 / 拦截: 触发告警]
下面是一段用于该流水线的核心质检网关伪代码,演示如何在软件工程层面建立确定性保障:
"""
工业级 AI 图像生产流水线质检与合规准入检查器 (Quality & Compliance Gateway)
"""
import dataclasses
from typing import List, Tuple
import cv2
import numpy as np


@dataclasses.dataclass
class InspectionResult:
    passed: bool
    structural_ssim: float
    color_delta_e: float
    violations: List[str]


class ImageQualityGateway:
    def __init__(self, ssim_threshold: float = 0.85, max_color_drift: float = 12.0):
        """
        初始化质检阈值
        :param ssim_threshold: 商品核心区域结构相似度下限(防止商品形变)
        :param max_color_drift: 商品核心区域允许的色彩漂移上限(防止品牌色失真)
        """
        self.ssim_threshold = ssim_threshold
        self.max_color_drift = max_color_drift

    def inspect_product_integrity(
        self,
        raw_product_crop: np.ndarray,
        generated_product_crop: np.ndarray,
        forbidden_keywords_found: List[str]
    ) -> InspectionResult:
        violations = []

        # 1. 敏感违规/侵权元素拦截
        if forbidden_keywords_found:
            for kw in forbidden_keywords_found:
                violations.append(f"命中违规敏感提示或标签: {kw}")

        # 2. 图像尺寸一致性对齐
        if raw_product_crop.shape != generated_product_crop.shape:
            generated_product_crop = cv2.resize(
                generated_product_crop,
                (raw_product_crop.shape[1], raw_product_crop.shape[0])
            )

        # 3. 计算商品核心区域的结构相似度 (SSIM)
        gray_raw = cv2.cvtColor(raw_product_crop, cv2.COLOR_BGR2GRAY)
        gray_gen = cv2.cvtColor(generated_product_crop, cv2.COLOR_BGR2GRAY)
        ssim_score = self._compute_simple_ssim(gray_raw, gray_gen)

        if ssim_score < self.ssim_threshold:
            violations.append(
                f"商品核心结构形变超标!当前 SSIM={ssim_score:.3f},要求 >= {self.ssim_threshold}"
            )

        # 4. 计算色彩漂移 (转换为 Lab 色彩空间评估 Delta E)
        color_drift = self._compute_mean_color_drift(raw_product_crop, generated_product_crop)
        if color_drift > self.max_color_drift:
            violations.append(
                f"商品色彩饱和度与色相偏离过大!当前 Delta E={color_drift:.2f},要求 <= {self.max_color_drift}"
            )

        return InspectionResult(
            passed=len(violations) == 0,
            structural_ssim=ssim_score,
            color_delta_e=color_drift,
            violations=violations
        )

    def _compute_simple_ssim(self, img1: np.ndarray, img2: np.ndarray) -> float:
        """简易灰度结构相似度度量"""
        u_x = np.mean(img1)
        u_y = np.mean(img2)
        var_x = np.var(img1)
        var_y = np.var(img2)
        cov_xy = np.cov(img1.flatten(), img2.flatten())[0][1]

        c1 = (0.01 * 255) ** 2
        c2 = (0.03 * 255) ** 2
        ssim = ((2 * u_x * u_y + c1) * (2 * cov_xy + c2)) / ((u_x**2 + u_y**2 + c1) * (var_x + var_y + c2))
        return float(ssim)

    def _compute_mean_color_drift(self, img1: np.ndarray, img2: np.ndarray) -> float:
        """计算在 CIELab 空间下的平均欧氏色差 (简易 Delta E)"""
        lab1 = cv2.cvtColor(img1, cv2.COLOR_BGR2LAB).astype(np.float32)
        lab2 = cv2.cvtColor(img2, cv2.COLOR_BGR2LAB).astype(np.float32)
        diff = np.sqrt(np.sum((lab1 - lab2) ** 2, axis=2))
        return float(np.mean(diff))
7. 企业 AI 视觉工具选型决策漏斗
不同规模与发展阶段的企业,其技术储备、预算及风控诉求大相径庭。以下四步决策漏斗可帮助团队快速定位适合的技术路线:
[第一步:数据隐私与敏感度评估]
 ├── 涉及未公开商业机密、专有研发硬件或高度敏感医疗/金融数据?
 │    └── 是 ──► 【必选私有化部署】(自建 GPU 节点 + Flux / SDXL + ComfyUI,物理隔离)
 │    └── 否 ──► 进入第二步
 │
[第二步:批量化与生产链路定制程度]
 ├── 是否需要每天自动化生成海量商品图、并对接内部 ERP / PIM 系统?
 │    └── 是 ──► 【选型私有化 API / 开源管道编排】(以 ComfyUI API 或自建推理容器为底层)
 │    └── 否 ──► 进入第三步
 │
[第三步:可控性与设计精度要求]
 ├── 是否必须 1:1 还原指定角色、固定商标构图与特定姿态?
 │    └── 是 ──► 【开源混合流】(IP-Adapter + ControlNet 骨架锁死 + 定制 LoRA)
 │    └── 否 ──► 进入第四步
 │
[第四步:人员技术背景与交付节奏]
 ├── 团队以纯平面设计师为主、缺乏 Python 算法与运维工程支持?
 │    └── 是 ──► 【商业 SaaS 专业版】(Midjourney / 商业闭源平台企业订阅,敏捷发散)
 │    └── 否 ──► 【混合双轨制】(前端设计师用 SaaS 提概念,后端工程团队用 ComfyUI 量产)
8. 商业使用上线前 12 项合规与质量自检清单
在任何一张 AI 生成图片正式投入商业营销、印刷包装或公开发布前,建议通过以下 12 项自检清单完成逐一核验:
一、版权与授权准入(Legal & Licensing)
- 服务协议核查:确认当前生成所用的账号处于付费商业授权期内,非教育或免费试用版本。
- 模型许可证排查:所使用的开源底模、LoRA 权重及 VAE 均不包含
NC(Non-Commercial)非商用限制。 - 提示词排毒:彻底审查 Prompt,已清除任何在世艺术家的姓名、受保护品牌商标名称及肖像指代。
- 过程资产留存:已完整备份初始提示词、参数配置、中间版本与人工修改图层,建立独创性证据链。
二、视觉质量与工程结构(Visual Quality & Consistency)
- 解剖学与肢体检查:人物手部(手指数量与关节走向)、瞳孔高光、牙齿及四肢结构无任何多生或畸变。
- 透视与物理逻辑:光影朝向(主光、辅光、反射光)与阴影投射角度在主体与背景之间保持物理一致。
- 几何边缘保真:产品核心外观、直线几何线条未出现由于扩散过程导致的微观波浪扭曲。
- 色彩空间与分辨率:如用于线下物料,已完成从 sRGB 至 CMYK 的色域转换,且实际分辨率满足 300 DPI 印刷标准。
三、监管合规与内容标注(Compliance & Labeling)
- 肖像权交叉核验:画面中的虚构面孔未与任何知名人物发生高相似度巧合碰撞,已做面部融合打散。
- 无恶意隐藏水印:画面背景与暗部已通过对比度增强检查,确认无原训练集残存的摄影机构或图库水印。
- 法定标识添加:根据相关互联网信息服务深度合成管理规定,在画面显著位置或元数据中添加了“AI 生成”显式标识。
- C2PA 元数据保护:如采用标准内容分发平台,确保包含创作者信息与数字签名的防伪凭证完好无损。
9. 结语
AI 图像生成从来不是“按下回车就坐等收工”的魔法,而是一门融合了美学感知、提示工程、几何约束与法律风险防范的全新工程学科。从闭源 SaaS 的审美探索,到开源节点流的像素级控制,再到商业落地的版权护栏,企业唯有在技术掌控力与合规确定性之间找到平衡,才能真正将 AI 视觉转化为可持续的核心生产力。
如果你在本地部署、定制化 LoRA 训练、批量图像工作流集成或商业合规落地过程中遇到具体架构疑难,欢迎通过 /contact/ 页面与我们展开深入交流。