过去几年中,自然语言处理与大语言模型(LLM)的爆发式演进,彻底打破了人们对机器翻译(Machine Translation)的传统认知。
从早期的统计机器翻译(SMT),到以 Google 翻译、DeepL 为代表的神经机器翻译(NMT),再到如今基于 GPT-4o、Claude 3.5 Sonnet、DeepSeek 等大模型的长上下文推理翻译,机器生成的译文在语法通顺度、词汇丰富度以及跨语种表达自然度上,已经达到了甚至超越普通双语者的水准。以至于在许多跨国企业和出海团队中,一种激进的声音开始蔓延:“人工翻译与校对已经过时,直接交给大模型做全量流水线即可。”
然而,在真正的商业生产实践中,盲目乐观往往会迅速撞上现实的冰山。
在技术文档本地化中,AI 可能会在不经意间将代码块中的参数变量 {user_name} 篡改成中文或吞掉下划线,导致前端代码渲染崩溃;在跨国法律合规协议中,一个情态动词(将 may 误译为 shall)的细微偏差,足以颠覆上亿元标的合同的违约责任判定;而在出海营销文案中,直白或过度平滑的机器润色,不仅难以击中当地用户的文化痛点,甚至可能触发意料之外的宗教与种族公关灾难。
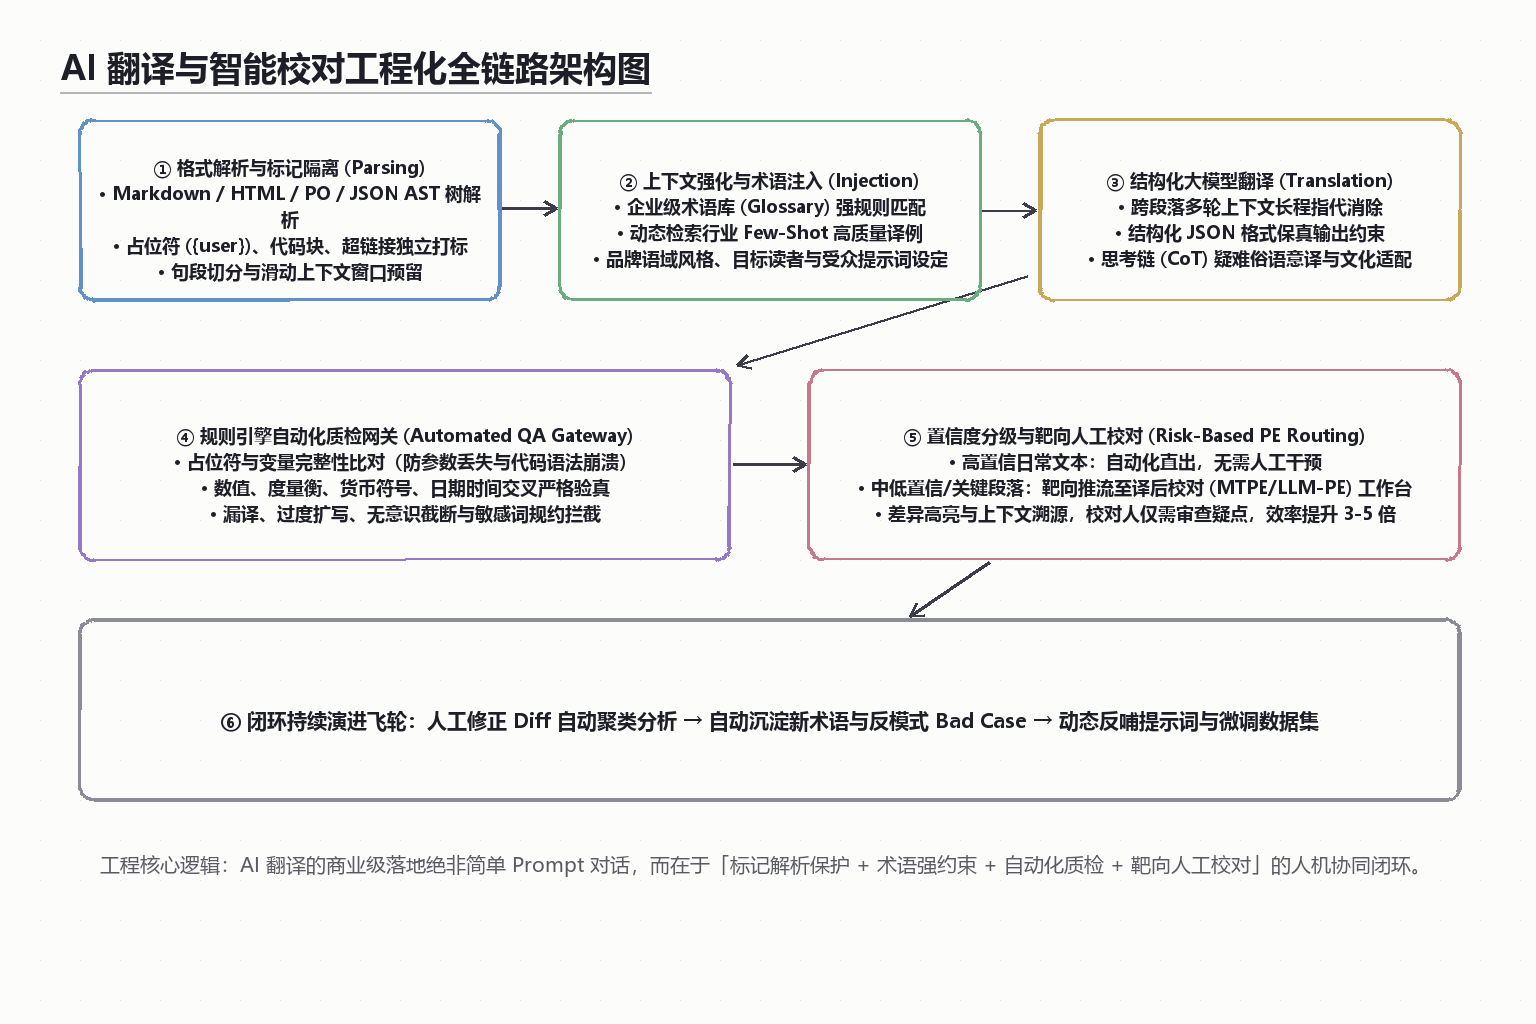
AI 翻译的质变,并不意味着人工校对的消亡,而是推动了翻译生产力范式的根本重构:从传统的“人工逐字敲定”,演进为“结构化前置约束 + 大模型生成 + 规则引擎质检 + 靶向人工校对(Risk-based Post-Editing)”的人机协同新工程。
本文将跳出学术界脱离业务实际的跑分迷思,深入企业级技术文档、出海营销、法律金融与即时客服四大高频场景,全面剖析主流 AI 翻译的技术边界、暗礁陷阱,并交付一套可直接落地的工业级流水线架构与自检清单。
一、从 NMT 到 LLM:现代翻译技术的底层范式跃迁
要科学评估 AI 翻译的能力水位,首先必须理解传统专用神经机器翻译(NMT)与大语言模型(LLM)驱动的上下文翻译在底层机制上的本质差异。
1. 机制分水岭:局部模式对齐 vs 全局语义推理
传统的 NMT 模型(如 DeepL、Google Translate 底层的 Transformer 架构)本质上是一个高度特化的序列到序列(Seq2Seq)映射器。
- 优点:针对千万级平行语料(Parallel Corpora)进行了极致的对齐训练,推理时延极低(通常单句在数十毫秒以内),吞吐量极大,且极少出现发散性胡言乱语;
- 致命瓶颈:传统的 NMT 几乎是在句子(Sentence)甚至短语级别进行独立翻译。它缺乏对整篇文章篇章结构、长程代词回指(Coreference Resolution)、前后专业术语一致性以及特定语域风格(Register)的全局把控能力。前文刚刚将
Spring确认为技术框架名,后文遇到相同词汇时,依然可能孤立地将其误译为“春天”。
相比之下,通用大语言模型(LLM)将翻译视作自回归长上下文生成的特例。
- 多轮长程记忆:大模型拥有动辄 32k 到 128k 甚至更长的有效注意力窗口,能够同时“看见”上下文前言后语,准确解析长程主谓关系与代词指代;
- 指令可操控性(Steerability):你可以通过 System Prompt 明确注入译文风格(如“硅谷极客风格”、“严谨的司法判例风格”)、目标受众背景(如“针对毫无编程基础的初学者”),甚至在输入中动态拼接数千词的企业术语白名单;
- 复杂文化推理:大模型具备庞大的世界知识库,能够理解双关语、隐喻、历史典故并完成“创译(Transcreation)”。
2. 为什么学术指标(BLEU / COMET)在商业中频繁失真?
许多企业在技术选型时,常常照搬学术论文中的 BLEU、ROUGE 或 COMET 评分。然而,这些指标在真实的商业落地中往往具有严重的欺骗性:
- BLEU 对“意译”的惩罚:BLEU 核心依赖译文与人工参考译文的 N-gram 精确重合度。如果大模型为了让中文更加地道,进行了句式倒装、长句拆分或主动/被动语态转换,虽然阅读体验大幅提升,但其 BLEU 得分反而会大幅下滑;
- 对“灾难性单点错误”的钝感:在一段 200 字的协议中,如果大模型把“乙方不得将专利转让给第三方”翻成“乙方可以将专利转让给第三方”,整段文本在 BLEU 算法中重合度高达 95% 以上,得分为极优;但在商业和法务视角下,这是一个导致合同彻底作废的 0 分致命事故;
- 格式与元数据盲区:标准学术基准仅比对纯文本字符,完全不考核 HTML 标签保真度、Markdown 语法嵌套、国际化占位符是否被篡改等工程关键项。
因此,评估 AI 翻译的质量,必须建立在真实场景的业务可用性与工程鲁棒性之上。
二、四大核心场景纵深评测与能力边界
为了还原真实的生产环境表现,我们将企业高频翻译任务划分为四大典型场景,从难度、表现、失误特征及人工干预必要性四个维度展开评测。
场景一:技术文档与开源代码库(API 文档、Markdown、开发手册)
- 业务特征:包含大量 Markdown 标题、代码块、内联代码(Inline Code)、超链接、配置文件、技术专有名词以及动态国际化占位符(如
{userId}、%s、$HOME)。 - 评测表现:
- 传统 NMT:表现较差。DeepL 等工具在处理带有复杂标签的代码文本时,容易破坏 Markdown 语法树,偶发代码行与正文串行合并,或者强行将不应翻译的函数名(如
get_user_state)拆解意译; - 旗舰 LLM(如 Claude 3.5 Sonnet / GPT-4o):表现极其惊艳。在明确指令下,大模型对 Markdown 语法树具备极强的保护本能,能严格保持代码块原貌,精准识别技术黑话(如准确将
thread pool译为“线程池”,将deadlock译为“死锁”),并能针对上下文自动理顺中文主谓倒装,产出非常专业的开发者文档; - 潜在隐患:极少数情况下,长文本输出会偶发截断,导致代码块最后的反引号
```丢失,或把英文状态下的全角/半角标点符号混用。
- 传统 NMT:表现较差。DeepL 等工具在处理带有复杂标签的代码文本时,容易破坏 Markdown 语法树,偶发代码行与正文串行合并,或者强行将不应翻译的函数名(如
- 综合评级:92 分(高度可用)。需配合轻量级正则质检网关核验占位符。
场景二:出海商业营销与本地化文案(Landing Page、广告语、社媒软文)
- 业务特征:重在引起情感共鸣、激发购买欲望。强调韵律感、幽默感、本土化俗语替代,极度排斥死板字面直译。
- 评测表现:
- 传统 NMT:几乎不可用。译文充斥着浓厚的“翻译腔”,句型僵硬呆板,对于双关语、谐音梗完全无能为力,直译出的文案不仅无法驱动转化,甚至显得廉价不专业;
- 旗舰 LLM:表现远超传统预期。大模型展现出了卓越的“创译”能力。如果给定品牌调性、目标市场受众特征(如东南亚年轻群体、欧美 B2B 决策者)并提供几个优秀 Few-Shot 示例,大模型能够给出多个不同文化维度的润色方案,甚至能够针对同一英文 Slogan 创作出工整对仗的四字成语或充满诗意的口号。
- 综合评级:85 分(强辅助)。可以替代初稿撰写,但最终上线版本的文化审查与语感定稿,必须由目标市场母语者(Native Speaker)亲自拍板。
场景三:法律合同、财报合规与医学文献(采购协议、招股书、临床指南)
- 业务特征:追求词义的单一指向性与绝对精确,语法结构复杂(大量长难句、后置定语、嵌套从句),对情态动词、主客体范围、免责边界具有极端严苛的要求,容错率为零。
- 评测表现:
- 传统 NMT:语言生硬,虽然能凭借特定术语库机械对齐词汇,但面对包含多重修饰关系的长复合句时,极易出现指代不清或主谓关系错位;
- 旗舰 LLM:最危险的“高分低能”陷阱。大模型生成的法律译文在表面上极其通顺、专业感拉满、句式结构无懈可击,极具欺骗性。但在深层逻辑上,它偶发地会出现情态动词漂移(例如将义务性条款
shall not弱化为表态性条款is discouraged from)、反义词误判、漏译关键排他性限制条件等致命缺陷。由于译文读起来非常顺畅,审校人员极易产生安全错觉而漏过核心风险点。
- 综合评级:65 分(高危红线区)。绝不能用于无人值守直出,必须由专业法律/医学背景的译审人员进行 100% 逐字全量双盲交叉校对。
场景四:跨境即时沟通与智能客服工单(在线 IM、工单交互、多语言 FAQ)
- 业务特征:输入源质量极差(包含大量用户拼写错误、语法不通、方言俚语、缩写表情),同时对系统的单次推理端到端延迟(Latency)和并发吞吐成本极为敏感。
- 评测表现:
- 传统 NMT:时延优势极大(单次调用 <100ms),但在面对拼写错误严重、缺乏主语的破碎口语句子时,翻译结果经常完全失真、语无伦次;
- 旗舰 LLM:容错与纠错能力惊人。即使海外客户发来的消息错字连篇(如
pls rply asap i cant log in ma acc),大模型也能瞬间理解真实意图并翻译为地道的目标语。但大模型的调用延迟通常在 1~3 秒以上,直接嵌入即时双向聊天可能让用户产生卡顿等待感。
- 综合评级:80 分(分场景可用)。异步工单与 FAQ 知识库翻译首选 LLM;毫秒级实时在线客服建议采用“轻量专用大模型或经过语法纠错前置过滤的商业 NMT”。
三、主流翻译技术方案多维横向评测对比
为了帮助工程团队在选型时算清“技术收益”与“架构成本”的明细账,下表汇总了当前四大主流技术流派在 7 个关键工程维度上的综合表现:
| 技术流派与代表工具 | 篇章上下文一致性 | 专有名词与术语锁定 | 格式与占位符保真度 | 文学润色与创译能力 | P99 响应延迟 | 综合推理成本 (每百万Token) | 推荐核心应用场景 |
|---|---|---|---|---|---|---|---|
| 传统商业 NMT (DeepL Pro / Google Cloud Translation) |
弱 (以单句切分为主) | 较强 (原生支持专业 Termbase 挂载) | 中等 (偶发破坏复杂 Markdown 树) | 弱 (以机械对齐为主,翻译腔重) | 极低 (50 - 150ms) |
中等固定成本 | 实时双向聊天、百万级海量商品标题翻新、冷启动语料粗筛 |
| 通用旗舰闭源 LLM (Claude 3.5 Sonnet / GPT-4o) |
极强 (支持跨段落回指与全局语域) |
极强 (通过 Few-shot 与 Prompt 强约束) | 极强 (具备 AST 语法感知能力) |
卓越 (能根据受众文化自适应重构) |
中等 (1.5 - 4.5s) |
较高 | 品牌出海营销、高价值产品落地页、技术深度研报与白皮书 |
| 高性价比开源 LLM (DeepSeek-V3 / Qwen-2.5-72B) |
强 (长文本推理能力扎实) | 强 (结合结构化 JSON 输出注入) | 强 (遵循指令能力稳定) | 良好 (行文自然流畅,中文功底深厚) | 中等 (1.0 - 3.0s) |
极低 (私有化或云端低价调用) |
企业知识库全量批量翻译、内部工单翻译、技术文档流水线 |
| 专业翻译管理系统 (TMS) (Phrase / memoQ + 插件生态) |
视接入的底层引擎而定 | 完美 (原生具备 CAT 术语库与记忆库) |
完美 (专业级双语标记隔离保护) |
弱 (重在工程管控而非算法创作) | 视接入引擎而定 | 软件 License 成本高昂 | 传统专业本地化团队、多语言软件发版、专业翻译服务商 |
四、AI 翻译的四大“隐形暗礁”与反模式剖析
即使使用了当前最顶尖的大模型,在复杂的生产环境中,大模型依旧会产生一些不易被常规审查发现的系统性偏差。理解这些反模式,是设计后置防御体系的前提。
1. 致命幻觉与无意识删节(Hallucination & Silent Omission)
在处理长难句、多重否定句或包含生僻领域的专业文献时,大模型存在一种内在的“过度自信倾向”:遇到未完全理解的细分条件,它不会报错,而是选择“合理化重构”。
- 无意识删节:模型往往会无声无息地抹掉句中的限定副词(如
substantially、rarely、allegedly),使得原本严密的审慎表述退化为绝对化判断; - 过度扩写与脑补:在大模型翻译简短的技术报错信息时,偶尔会根据其预训练权重中的常识,擅自给用户“附赠”一段排查建议并混入正文中,导致前端 UI 布局直接溢出。
2. 占位符与格式标记逃逸(Format Corruption)
在国际化(i18n)开发中,程序员广泛使用占位符注入动态参数。例如:Welcome back, {username}! You have {count} unread notifications.
未经特殊防护的大模型在处理此类文本时,极易发生以下故障:
- 错误地将变量名翻译为中文:
欢迎回来,{用户名}!(导致后端字符串插值引擎因找不到 key 而抛出KeyError异常); - 将英文半角花括号转换为中文全角括号:
{username}; - 擅自将变量下划线去掉或添加多余空格:
{ user_name }。
3. “假朋友”误区与行业黑话混淆(False Friends & Jargon Collision)
在跨学科或特定工业语境中,同一个词汇的含义可能发生 180 度翻转:
- 在通用英语中,
pipeline是“管道”;但在 DevOps 研发语境中,它是“流水线”;在芯片硬件语境中,它是“流水线架构”;在销售 CRM 语境中,它是“商机漏斗”; - 常见的语言学“假朋友”:英文
actual意为“实际的”,但常被初级 AI 顺手联想为“目前的”(误与法语/德语词源混淆);eventually意为“最终”,常被误当成“偶然地/万一”。
如果没有在翻译前置链路中进行严格的领域上下文判定与术语表注入,大模型极易在多义词上阴沟翻船。
4. “机器腔调”(AI Translationese)与过度平滑
随着大模型广泛接受人类反馈强化学习(RLHF),其输出往往呈现出一种高度趋同的“客服式礼貌与平滑”:
- 偏好堆砌连词(“因此”、“与此同时”、“值得注意的是”);
- 大量采用被动句式与冗长的名词化短语(例如将原本简短有力的“Click here to restart”翻译为“请点击此处以进行重新启动操作”);
- 抹杀了原作者鲜明的个人笔触、锋芒与幽默感。
对于追求品牌辨识度与极简文风的现代科技产品而言,这种过度平滑的平庸感同样是一种严重的负面资产。
五、工程化实践:构建企业级高可靠人机协同(MTPE / LLM-PE)流水线
为了在实际工程中兼顾大模型的高吞吐低成本与商业级交付的绝对确定性,我们必须打破“直接把文本喂给 LLM”的原生做法,构建一套纵深防御的四阶工程化流水线。
1. 架构核心四步拆解
- 第一阶:格式解析与标记隔离(Source Parsing & Masking):使用 AST 语法解析器将原始 Markdown/HTML/PO 拆解,将代码块、超链接与
{variable}占位符提取并替换为不可翻译的唯一样本令牌(如__PROTECTED_VAR_0__),彻底杜绝大模型篡改变量; - 第二阶:上下文编排与术语注入(Context & Termbase Injection):匹配企业术语库(Glossary),检索该篇章命中的专业词汇对,并结合预设的语域规则,构造结构化 Prompt;
- 第三阶:带约束的结构化推理(Structured LLM Translation):要求大模型以 JSON 强约束格式返回译文,并保留分段映射关系;
- 第四阶:规则引擎自动化质检网关(Automated QA Gateway):通过静态规则快速核验占位符完整性、数值一致性、未译字符比例,计算质量风险分(Risk Score),实现高分自动化放行,低分靶向推送人工校对台。
2. 生产级 Python 自动化流水线实战代码
以下是一套可直接投入生产复用的轻量化翻译与质检核心骨架代码,包含占位符掩码保护、动态术语注入以及自动化 QA 校验网关:
import re
from typing import Dict, List, Tuple
from pydantic import BaseModel, Field

class TranslationItem(BaseModel):
    id: str
    source: str
    target: str = Field(description="翻译后的目标语言文本")

class TranslationBatchResponse(BaseModel):
    translations: List[TranslationItem]

class IndustrialTranslator:
    def __init__(self, glossary: Dict[str, str]):
        self.glossary = glossary
        # 匹配大括号占位符、printf占位符及内联代码反引号
        self.var_pattern = re.compile(r'(\{[a-zA-Z0-9_]+\}|%[0-9]*\$?[sdf]|`[^`]+`)')

    def preprocess_masking(self, text: str) -> Tuple[str, Dict[str, str]]:
        """第一阶:将敏感占位符与代码标记提取为保护令牌"""
        token_map = {}
        counter = 0

        def replace_match(match):
            nonlocal counter
            token = f"__VAR_TOKEN_{counter}__"
            token_map[token] = match.group(0)
            counter += 1
            return token

        masked_text = self.var_pattern.sub(replace_match, text)
        return masked_text, token_map

    def postprocess_unmasking(self, text: str, token_map: Dict[str, str]) -> str:
        """还原被保护的占位符与标记"""
        unmasked_text = text
        for token, original in token_map.items():
            unmasked_text = unmasked_text.replace(token, original)
        return unmasked_text

    def build_system_prompt(self, target_lang: str = "zh-CN") -> str:
        """第二阶:构建包含术语白名单的严密提示词"""
        glossary_rules = "\n".join([f"- {k} => {v}" for k, v in self.glossary.items()])
        return f"""你是一位拥有20年本土化经验的资深技术出版物翻译专家。
目标语:{target_lang}。

核心行为准则:
1. 绝对严禁修改形如 __VAR_TOKEN_N__ 的保护令牌,必须原封不动保留在译文中。
2. 严格遵循以下企业术语表(Glossary),命中对应词汇时必须使用指定译名:
{glossary_rules}
3. 遵循技术写作规范:中文与英文单词之间保留一个半角空格;代码专有名词不强行直译。
4. 杜绝翻译腔与被动句式堆叠,输出必须地道自然、专业严谨。
5. 请直接以符合 JSON Schema 的格式输出,严禁添加任何额外寒暄。"""

    def automated_qa_check(self, source: str, target: str, token_map: Dict[str, str]) -> List[str]:
        """第四阶:自动化质量审计网关"""
        warnings = []

        # 检查项 1:保护令牌完整性检测
        for token in token_map.keys():
            if token not in target:
                warnings.append(f"【严重】保护令牌丢失或被篡改: {token} (原变量: {token_map[token]})")

        # 检查项 2:阿拉伯数字一致性核验(提取所有纯数字进行集合比对)
        src_numbers = set(re.findall(r'\b\d+(?:\.\d+)?\b', source))
        tgt_numbers = set(re.findall(r'\b\d+(?:\.\d+)?\b', target))
        if src_numbers != tgt_numbers:
            diff = src_numbers.symmetric_difference(tgt_numbers)
            warnings.append(f"【警告】源文与译文数值存在差异,请复核数字: {diff}")

        # 检查项 3:大段未翻译英文残留检测(排除令牌与允许的专有名词)
        cleaned_target = self.var_pattern.sub('', target)
        for token in token_map.keys():
            cleaned_target = cleaned_target.replace(token, '')
        long_english = re.findall(r'[a-zA-Z]{12,}', cleaned_target)
        if long_english:
            warnings.append(f"【提示】发现较长连续英文,疑为漏译或未识别术语: {long_english}")

        return warnings

# ================= 模拟执行演示 =================
if __name__ == "__main__":
    demo_glossary = {
        "pipeline": "流水线",
        "deadlock": "死锁",
        "concurrency": "高并发"
    }
    translator = IndustrialTranslator(glossary=demo_glossary)

    sample_src = "Ensure the CI pipeline checks for any deadlock under high concurrency with user {user_id}."
    masked_src, tokens = translator.preprocess_masking(sample_src)

    print(f"原始输入: {sample_src}")
    print(f"掩码保护后: {masked_src}")
print(f"提取变量令牌表: {tokens}")这套代码的精妙之处在于:它把大模型视作不可信的外部运算单元。通过在输入前利用正则/AST 完成敏感标记的“物理隔离”,在输出后执行强规则的“数字与占位符断言”,从工程底座上抹杀了 90% 以上因大模型幻觉导致的生产级灾难。
六、生产级人工校对(PE)自检清单与质量分级准入
在人机协同工作流中,人工校对(Post-Editing,简称 PE)绝非漫无目的的从头通读,而是依托质检网关报警信息的靶向防御。
根据文本的重要程度与传播范围,我们建议企业建立清晰的三级质量准入体系:
- L1 级(内部参考级):如员工内部分享、非核心业务的海外工单转译。要求:自动化 QA 网关 0 报错,无须人工审校即可直接流转;
- L2 级(公开发布级):如常规技术文档、官方知识库、日常产品更新日志。要求:自动化 QA 网关通过后,人工针对标题、前言、结论以及 QA 警报点进行靶向抽检(抽检率约 15%-25%);
- L3 级(核心资产级):如商业合同、财务报表、主站 Landing Page Slogan、公开发行书籍。要求:全量人工深度精校 + 目标语言母语者双盲试读。
在执行 L2 / L3 级别校对时,建议校对团队对照以下 12 项标准化核验指标逐一核验:
| 序号 | 校验维度 | 具体核验项目与准入标准 | 常见失误形式 |
|---|---|---|---|
| 01 | 占位符安全 | 是否核对全篇动态变量、占位符无一缺失、大小写与原代码完全一致? | {username} 被翻译为 {用户名},导致编译报错 |
| 02 | 数字与单位 | 原文中的阿拉伯数字、百分比、货币符号($ / ¥ / €)及度量衡单位是否准确无误? | 将 50,000 误转为 5000,或将 billion 算错数量级 |
| 03 | 逻辑转折词 | 关键转折连词(However, Although, Unless, Provided that)逻辑朝向是否颠倒? | 把“除非另有约定”误翻成“根据上述约定” |
| 04 | 情态动词权能 | 法律与规则性条款中的 shall, must, may, should 权限等级是否精确对齐? |
将强制义务动词(必须)降级为建议性动词(应当) |
| 05 | 术语库一致性 | 行业与企业自定义术语表是否 100% 遵从?全篇同一概念译名是否全局统一? | 前半篇用“令牌”,后半篇无故跳变为“代币”或“通证” |
| 06 | 排他与范围修饰 | only, exclusively, including but not limited to 等限定短语是否漏译? |
漏掉“仅限于”三个字,导致服务协议保障范围被无限放大 |
| 07 | 代码与专有名词 | 函数名、类名、CLI 命令行参数、HTTP 动词(GET/POST)是否绝对保持未翻译? | 将 git checkout 翻译为“git 结账”,引发开发者嘲讽 |
| 08 | Markdown 语法树 | 链接语法 [text](url) 中的括号与目标 URL 是否完好?代码块缩进是否损坏? |
误将链接 URL 内部路径做中文翻译,导致全站超链接 404 |
| 09 | 主被动语态重构 | 是否剔除了不符合中文习惯的冗余被动句(如大量“被……”、“由……所导致”)? | 机械直译导致中文句式极其拗口,读感犹如拼装机 |
| 10 | 文化与政治合规 | 译文中是否存在涉及种族、宗教、地名、地图归属或文化禁忌的隐性冒犯? | 地名未按国家标准规范译法翻译,造成出海合规舆情 |
| 11 | 无意识截断排查 | 核对段落总数与长短比例,确认模型未在长文本推理中断流导致后半句丢失? | 模型因达到 Token 上限未闭合段落,语句在逗号处戛然而止 |
| 12 | 排版空格与标点 | 汉字与西文字符之间是否按技术规范留出标准半角空格?标点符号中英文状态是否正确? | 中文正文里突兀插入英文半角逗号,或者文字与英文粘连挤压 |
七、落地选型决策漏斗与总结建议
企业引入 AI 翻译,最忌讳的是“拿着一把锤子看什么都是钉子”。不同的业务形态对成本、时延、准确率的容忍度完全不同。技术负责人可以依据以下四问决策漏斗,迅速收敛技术栈架构:
            【开始评估业务翻译需求】
                      │
       [问题 1: 发生错误是否引发直接法律/人身风险?]
                /             \
            [是]               [否]
             │                  │
【强制全量人工审校 (L3)】  [问题 2: 是否要求 <200ms 的极低时延?]
底座选旗舰 LLM 或专有 TMS        /             \
                             [是]               [否]
                              │                  │
                 【选专用商业级 NMT】    [问题 3: 篇幅是否长且重在语境风格?]
                 (如 DeepL API 配合缓存)          /             \
                                              [是]               [否]
                                               │                  │
                                   【选用旗舰通用 LLM】    【轻量级高性价比 LLM】
                                   (Claude 3.5 / GPT-4o) (DeepSeek / Qwen 批量)
                                   配合前置 AST 标记保护   自动化 QA 网关自闭环
核心结论
- 不要再比拼纯文本的 BLEU 跑分:脱离了格式保护、变量隔离与术语强约束的翻译对比毫无意义。真正拉开工程差距的,是翻译网关层对 AST 的前置解析与后置静态规则校验能力;
- 大模型的翻译长板在“意境”与“格式理解”,短板在“确定性”:让大模型发挥其擅长的长程上下文梳理、文化语域适配与风格润色,而把数字、占位符、专有名词的一致性判定交给确定性的代码规则与术语库;
- 校对团队的角色升级:翻译人员不再是单调的打字机,而是进化为提示词与术语库架构师(Termbase & Prompt Engineer)以及高风险段落的质量守门人。利用好靶向校对策略,企业能在翻译综合成本降低 70% 的同时,实现交付交付质量的逆势跃升。
本文由 TypeTube 团队原创深度整理。如果你在多语言技术文档本地化流水线构建、企业级翻译术语网关设计或 LLM-PE 人机协同落地中遇到具体架构瓶颈,欢迎前往我们的 联系与交流页面 共同切磋探讨。