在企业的日常运营与数字化流程中,非结构化与半结构化文档如同庞大的暗物质:法务部门每个季度需要人工核验数百份长达几十页的商业合作与采购合同;财务团队每逢月末月初被成千上万张发票、报销单据、银行对账单以及供应商结算清单所淹没;投资与审计人员则需要从格式各异的企业财报和资产负债表中逐项誊录核心财务指标。
长期以来,这类业务高度依赖一线员工的“肉眼比对 + 手工键盘录入”。据企业管理咨询机构的调研显示,财务与法务后台运营人员有超过 50% 至 65% 的有效工时被沉淀在机械化的文档信息誊抄、表格格式对齐和跨系统数据录入上。不仅人工成本高昂,且不可避免地出现漏录、串行、金额小数点错位等低级但后果严重的失误。
虽然过去十年间企业广泛尝试过传统 OCR(光学字符识别)与基于规则的模板匹配技术,但在面对版面轻微抖动、印章遮挡、跨页表格切断、非固定排版以及需要法律条款深层语义理解的场景时,传统方案的脆断性极高,维护成本往往迅速吞噬最初的自动化收益。
随着多模态大语言模型(Multimodal LLM)与文档智能技术(Document Intelligence)的跨越式演进,文档自动化提取已经从“机械的像素级字符识别”跃迁为“融合版面几何拓扑、跨页语义理解与确定性规则审计的端到端认知工程”。本文将系统拆解一套面向合同、发票与复杂报表的工业级批量文档提取流水线,涵盖分层架构设计、关键字段抽取契约、确定性数学校验逻辑、跨页长文档缝合技术,并提供可直接复用的 Python 核心网关代码与生产上线自检清单。
一、三代文档处理技术演进与方案对比
要构建能够真正融入企业生产环境的文档处理系统,首先必须清楚各代技术方案的能力边界与工程成本。盲目选用最新或最复杂的技术往往会导致过度设计,而低估场景复杂性又会陷入无休止的规则修补陷阱。
| 评估维度 | 第一代:传统纯人工模式 | 第二代:传统 OCR + 规则/模板匹配 | 第三代:多模态 LLM + 文档智能工程 (现代化方案) |
|---|---|---|---|
| 核心机制 | 肉眼逐行审阅,手工敲键盘录入 ERP 或 CRM 系统。 | 基于固定坐标的锚点识别,结合正则表达(Regex)匹配。 | 多模态版面分析 + 结构化 Schema 约束 + 语义指代消解。 |
| 版面适应能力 | 适应力极强,但受制于个人情绪、疲劳度与经验差异。 | 极度脆弱;发票格式微调或扫描件缩放偏移即导致提取崩溃。 | 极高泛化能力;对扫描倾斜、字体多变、版式错落均具备稳健容忍度。 |
| 复杂表格还原 | 人工识别逻辑明确,但多列多行录入耗时极长且极易串行。 | 仅能提取简单单线表格;合并单元格、无线框表格与跨页表格基本失效。 | 结合版面坐标与 Markdown/HTML 表格结构重构,精准还原单元格拓扑。 |
| 语义与上下文理解 | 完全依赖人工专业知识(如理解违约金上限或竞业限制)。 | 零语义理解能力;无法识别同义替换、条款隐藏含义与上下文关联。 | 深度理解法律与财务语境,精准定位隐含条款、实质权利义务及前置条件。 |
| 新模板接入成本 | 仅需简单业务培训,但边际处理成本恒定且居高不下。 | 每个新版式均需算法工程师手动标注锚点、配置正则表达式,周期长。 | 零样本(Zero-shot)或少样本(Few-shot)自适应,几分钟内完成契约定义。 |
| 异常检测与自愈 | 容易因视觉疲劳漏过异常金额;复核通常依赖双人双录。 | 只能做死板的字符长度或数字类型检查,无法自愈。 | 结合确定性数学验算与置信度审计,自动标出疑点并驱动人机协同复核。 |
二、不同文档类型的核心特征与提取范式
不同类型的文档在信息密度、结构规范度与业务容错率上存在本质差异。在工程落地中,绝不能采用“一刀切”的黑盒 Prompt,而必须针对文档类型制定针对性的特征提取范式。
2.1 商业合同:非结构化长文本与法律风险条款
商业合同通常呈现出长篇幅(数页至数十页)、排版样式高度多样、包含大量专业法律术语的特征:
- 关键实体抽取:签约主体(甲乙双方及连带责任方)、统一社会信用代码、法定代表人、合同标的物、签约日期与履行起止日期。
- 金额与履约条款:合同总金额(大写与小写核对)、付款节点与里程碑、验收标准与质量保证金比例。
- 责任与合规风险防范:违约金计算上限(如“按逾期每日千分之五且不超过总额 20%”)、管辖法院、单方解除权触发条件、知识产权归属以及保密期限。
- 签署有效性核验:签署页是否有有效骑缝章、公章印文是否清晰、授权代表签字是否完整,是否存在手写涂改痕迹。
2.2 增值税发票与费用单据:高度格式化与版面几何绑定
各类发票(数电发票、增值税专用发票、增值税普通发票、国际商业发票 Invoice)属于高度结构化但版面紧凑的单据:
- 网格与代码绑定:发票代码、发票号码、开票日期、机器校验码必须做到 100% 绝对精确提取,一位不差。
- 双向主体与税号:购买方与销售方的全称、纳税人识别号、地址电话、开户行及账号。
- 行级货物/服务明细:货物或应税劳务名称、规格型号、单位、数量、单价、金额、税率与税额。
- 数学闭环强约束:各行金额之和必须精确等于不含税金额;各行税额之和必须精确等于合计税额;价税合计大写必须与小写严格吻合。
2.3 财务报表与对账流水:多列嵌套与数据勾稽关系
资产负债表、利润表、现金流量表以及银行对账单通常具有极高的数据密度与严谨的勾稽平衡:
- 复杂表格拓扑:包含多级科目层级(流动资产、非流动资产、资产总计)、跨列合并表头(如“期初余额”、“期末余额”)。
- 会计勾稽关系验算:资产总计 = 负债合计 + 所有者权益合计;营业收入 - 营业成本 - 税金及附加 = 营业毛利。
- 对账流水时序连续性:银行流水中的交易时间戳、借贷方向、交易对手、流水号以及账户变动后余额的连续递推演算。
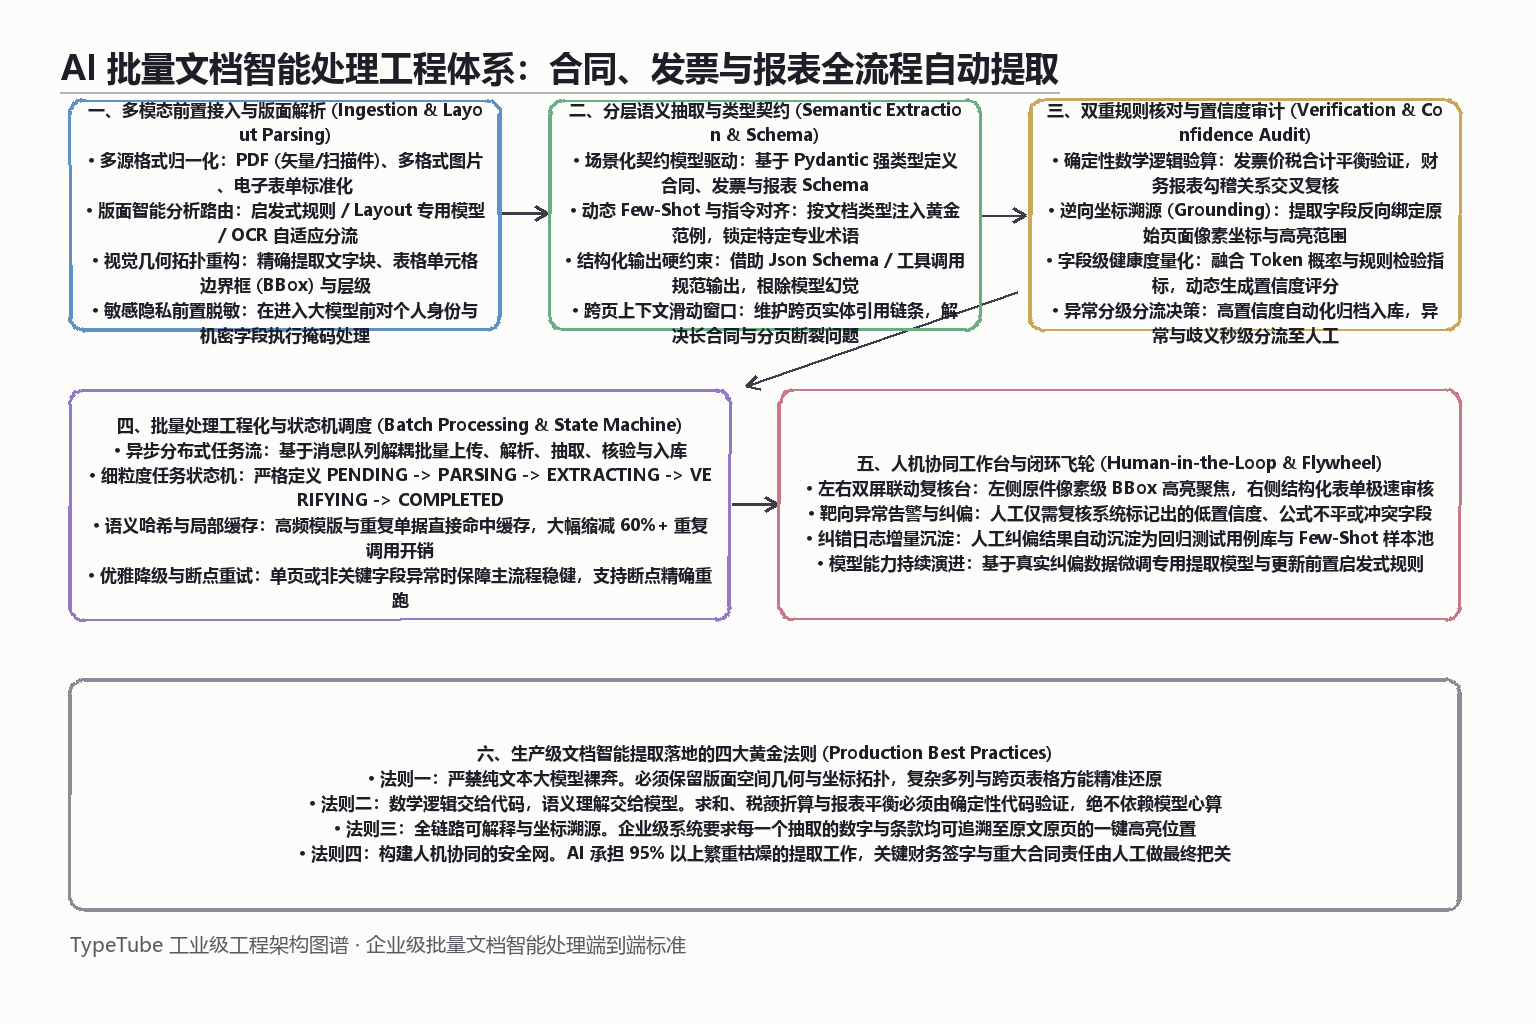
三、工业级文档处理系统的四层工程架构
为了在生产环境中实现每小时数万页文档的高并发、低成本、高精度处理,必须将流程解耦为分工明确的流水线架构,杜绝直接将原始 PDF 图像盲目喂给大模型的低效做法。
3.1 第一层:多模态前置接入与格式归一化 (Ingestion & Normalization)
- 多源格式解包:将上传的电子格式 PDF(矢量文本层可直接提取)、扫描版 PDF(纯图像或双层 PDF)、高分辨率图片(PNG/JPG/TIFF)统一解析为标准页面图像流与文本切片。
- 图像质量增强:利用轻量图像处理库进行自动旋转纠偏、去黑边、二值化去噪、阴影消除,提升极端场景下的字符可辨识度。
- 敏感数据合规掩码:在将文档内容外发至大模型 API 之前,基于本地正则表达式或微型命名实体识别(NER)模型,对公民个人身份证号、个人银行卡号、手机号等执行本地脱敏占位替换。
3.2 第二层:版面智能分析与空间拓扑重构 (Layout Analysis)
- 版面元素分类:使用轻量版面分析算法(如 PaddleDetection、LayoutLM 架构)将页面快速划分为段落文本块、多级标题块、表格区域、印章区域以及图像说明。
- **阅读顺序重构 (Reading Order)**:针对双栏排版、三栏排版或环绕插图排版,依据版面坐标重建符合人类自然阅读逻辑的文本流,彻底避免跨栏内容横向串读。
- 表格结构矢量化:对表格区域提取单元格物理边界框(Bounding Box, BBox),识别跨行跨列单元格,重构为带坐标的 HTML 表格或带有明确行列分隔的 Markdown 格式。
3.3 第三层:大模型认知抽取与强类型契约 (LLM Extraction & Schema)
- Pydantic 模式契约:严格使用 Python Pydantic 强类型模型声明预期抽取的 JSON 结构,利用大模型提供商的 Structured Outputs 或 Function Calling 机制强制约束输出类型。
- 动态 Few-Shot 注入:根据前置分类器识别出的单据类别(如“国际海运提单” vs “国内增值税发票”),动态检索知识库中对应的 1~2 个高质量标注范例注入上下文。
- **坐标反向对齐 (Grounding)**:要求模型在输出抽取字段值的同时,输出该值对应的页面索引及原图坐标范围(xmin, ymin, xmax, ymax),为下游审计提供不可篡改的事实溯源底据。
3.4 第四层:双重确定性校验与置信度审计 (Verification & Audit)
- 硬性规则校验器:脱离大模型,完全由后端确定性 Python 代码执行数学平衡校验、日期时序合法性核验以及正则格式验证。
- **综合置信度评分 (Confidence Score)**:结合大模型的 Token 采样概率(Logprobs)与规则校验通过率,生成 0 到 100 分的字段健康度评分。
- 人机协同分流(HITL):得分在阈值以上且完全通过确定性校验的文档,自动入库同步下游系统;任何触发等式不平或低置信度的字段,自动生成高亮疑点卡片,推送至人工复核工作台。
四、生产级实战代码:端到端文档智能抽取与校验网关
下面提供一套结构完整、符合工业级工程标准的 Python 实现。代码集成了 Pydantic 强类型契约定义、多类文档的抽取 Schema、确定性数学等式验证器、坐标溯源结构以及健康度综合审计机制。
"""
Document Intelligence Processing Gateway
生产级文档智能提取与确定性审计网关
"""

import re
from datetime import date
from decimal import Decimal
from typing import List, Optional, Tuple, Dict, Any
from pydantic import BaseModel, Field, field_validator, model_validator


# =====================================================================
# 1. 基础元数据与坐标溯源模型 (Grounding Metadata)
# =====================================================================

class BoundingBox(BaseModel):
    """提取字段在原始文档图像中的归一化坐标 (0.0 - 1.0)"""
    page_index: int = Field(description="页面索引,从0开始计数")
    x_min: float = Field(ge=0.0, le=1.0, description="左边界坐标")
    y_min: float = Field(ge=0.0, le=1.0, description="顶边界坐标")
    x_max: float = Field(ge=0.0, le=1.0, description="右边界坐标")
    y_max: float = Field(ge=0.0, le=1.0, description="底边界坐标")


class ExtractedField(BaseModel):
    """带置信度与坐标溯源的字段封装容器"""
    raw_value: str = Field(description="原文提取的原始字符串")
    confidence: float = Field(ge=0.0, le=1.0, description="模型置信度")
    bbox: Optional[BoundingBox] = Field(default=None, description="原始坐标溯源")


# =====================================================================
# 2. 场景化提取契约 (Schemas for Invoice & Contract)
# =====================================================================

class InvoiceItem(BaseModel):
    """发票货物或应税劳务明细行"""
    name: str = Field(description="货物或应税劳务名称")
    specification: Optional[str] = Field(default=None, description="规格型号")
    unit: Optional[str] = Field(default=None, description="单位")
    quantity: Optional[Decimal] = Field(default=None, description="数量")
    unit_price: Optional[Decimal] = Field(default=None, description="单价(不含税)")
    amount: Decimal = Field(description="金额(不含税)")
    tax_rate: Decimal = Field(description="税率,如0.13表示13%")
    tax_amount: Decimal = Field(description="税额")


class VATInvoiceSchema(BaseModel):
    """增值税专用/普通发票结构化契约"""
    invoice_code: Optional[str] = Field(default=None, description="发票代码")
    invoice_number: str = Field(description="发票号码")
    invoice_date: str = Field(description="开票日期 YYYY-MM-DD")

    buyer_name: str = Field(description="购买方名称")
    buyer_tax_id: str = Field(description="购买方纳税人识别号")

    seller_name: str = Field(description="销售方名称")
    seller_tax_id: str = Field(description="销售方纳税人识别号")

    items: List[InvoiceItem] = Field(description="明细清单列表")

    subtotal_amount: Decimal = Field(description="合计金额(不含税)")
    total_tax_amount: Decimal = Field(description="合计税额")
    grand_total: Decimal = Field(description="价税合计(小写)")

    @field_validator("invoice_number")
    def validate_invoice_no(cls, v: str) -> str:
        clean_no = re.sub(r"\D", "", v)
        if len(clean_no) not in (8, 10, 20):  # 覆盖传统发票与数电发票
            raise ValueError(f"发票号码位数异常: {v}")
        return clean_no


class ContractRiskTerm(BaseModel):
    """合同风险条款结构化描述"""
    term_type: str = Field(description="条款类型:违约责任/解除权/知识产权/管辖权")
    description: str = Field(description="条款核心内容摘要")
    penalty_ratio: Optional[Decimal] = Field(default=None, description="违约金比例,如0.005")
    has_cap: bool = Field(default=False, description="是否包含赔偿金额上限")
    cap_limit_text: Optional[str] = Field(default=None, description="赔偿上限具体约定")


class CommercialContractSchema(BaseModel):
    """商业采购与合作合同结构化契约"""
    contract_title: str = Field(description="合同完整标题")
    contract_number: Optional[str] = Field(default=None, description="合同内部编号")
    signing_date: Optional[str] = Field(default=None, description="签约日期")
    effective_date: Optional[str] = Field(default=None, description="生效日期")
    expiration_date: Optional[str] = Field(default=None, description="失效或到期日期")

    party_a: str = Field(description="甲方名称")
    party_b: str = Field(description="乙方名称")

    total_amount: Optional[Decimal] = Field(default=None, description="合同总金额")
    currency: str = Field(default="CNY", description="币种")

    payment_terms: List[str] = Field(description="付款里程碑条款列表")
    risk_terms: List[ContractRiskTerm] = Field(description="关键风控条款")
    dispute_resolution: str = Field(description="争议解决方式与指定法院/仲裁委")


# =====================================================================
# 3. 确定性规则与数学勾稽校验器 (Deterministic Verification Engine)
# =====================================================================

class DocumentAuditResult(BaseModel):
    is_valid: bool = Field(description="是否完全通过确定性校验")
    error_messages: List[str] = Field(default_factory=list, description="阻断性错误列表")
    warning_messages: List[str] = Field(default_factory=list, description="警示性疑点列表")
    calculated_confidence: float = Field(description="综合健康度审计评分 (0-100)")


class DocumentVerifier:
    """脱离模型的纯确定性规则引擎,杜绝模型数学心算幻觉"""

    @staticmethod
    def verify_vat_invoice(invoice: VATInvoiceSchema) -> DocumentAuditResult:
        errors = []
        warnings = []

        # 1. 逐行明细数学核验
        computed_subtotal = Decimal("0.00")
        computed_tax = Decimal("0.00")

        for idx, item in enumerate(invoice.items, start=1):
            # 核验:数量 * 单价 = 金额
            if item.quantity is not None and item.unit_price is not None:
                expected_amount = round(item.quantity * item.unit_price, 2)
                diff = abs(expected_amount - item.amount)
                if diff > Decimal("0.02"):  # 允许两分钱以内的四舍五入尾差
                    warnings.append(
                        f"第{idx}行[{item.name}]数量*单价({expected_amount})与金额({item.amount})存在微差"
                    )

            # 核验:金额 * 税率 = 税额
            expected_tax = round(item.amount * item.tax_rate, 2)
            if abs(expected_tax - item.tax_amount) > Decimal("0.02"):
                errors.append(
                    f"第{idx}行[{item.name}]税额计算错误: 期望 {expected_tax}, 实际提取 {item.tax_amount}"
                )

            computed_subtotal += item.amount
            computed_tax += item.tax_amount

        # 2. 合计项勾稽关系核算
        if abs(computed_subtotal - invoice.subtotal_amount) > Decimal("0.05"):
            errors.append(
                f"明细金额累加和({computed_subtotal})与不含税合计({invoice.subtotal_amount})不符"
            )

        if abs(computed_tax - invoice.total_tax_amount) > Decimal("0.05"):
            errors.append(
                f"明细税额累加和({computed_tax})与合计税额({invoice.total_tax_amount})不符"
            )

        # 3. 价税总计校验
        expected_grand_total = invoice.subtotal_amount + invoice.total_tax_amount
        if abs(expected_grand_total - invoice.grand_total) > Decimal("0.02"):
            errors.append(
                f"价税合计验证失败: 不含税金额+税额={expected_grand_total}, 但提取值为={invoice.grand_total}"
            )

        # 4. 税号校验 (中国统一社会信用代码为18位)
        for party, tax_id in [("购买方", invoice.buyer_tax_id), ("销售方", invoice.seller_tax_id)]:
            if len(tax_id) != 18:
                warnings.append(f"{party}税号长度不是18位标准统一信用代码: {tax_id}")

        # 计算综合评分
        base_score = 100.0
        base_score -= len(errors) * 35.0
        base_score -= len(warnings) * 10.0
        final_score = max(0.0, min(100.0, base_score))

        return DocumentAuditResult(
            is_valid=(len(errors) == 0),
            error_messages=errors,
            warning_messages=warnings,
            calculated_confidence=final_score
        )

    @staticmethod
    def verify_commercial_contract(contract: CommercialContractSchema) -> DocumentAuditResult:
        errors = []
        warnings = []

        # 1. 主体核验
        if not contract.party_a.strip() or not contract.party_b.strip():
            errors.append("合同甲乙方主体存在缺失")
        if contract.party_a.strip() == contract.party_b.strip():
            errors.append("合同签署双方主体名称完全相同,疑似解析混淆")

        # 2. 日期逻辑合理性核验
        if contract.effective_date and contract.expiration_date:
            try:
                eff = date.fromisoformat(contract.effective_date)
                exp = date.fromisoformat(contract.expiration_date)
                if exp < eff:
                    errors.append(f"合同失效日期({contract.expiration_date})早于生效日期({contract.effective_date})")
            except ValueError:
                warnings.append("合同生效或失效日期格式非标准 ISO 格式,无法完成确定性比对")

        # 3. 风险条款审计
        has_penalty_clause = any(term.term_type == "违约责任" for term in contract.risk_terms)
        if not has_penalty_clause:
            warnings.append("未在合同中识别到明确的违约责任或违约金约束条款")

        base_score = 100.0
        base_score -= len(errors) * 40.0
        base_score -= len(warnings) * 15.0
        final_score = max(0.0, min(100.0, base_score))

        return DocumentAuditResult(
            is_valid=(len(errors) == 0),
            error_messages=errors,
            warning_messages=warnings,
            calculated_confidence=final_score
        )


# =====================================================================
# 4. 执行示范与模拟测试 (Demonstration)
# =====================================================================

if __name__ == "__main__":
    # 模拟一份抽取到的发票数据
    mock_invoice = VATInvoiceSchema(
        invoice_number="24312000000012345678",
        invoice_date="2026-11-08",
        buyer_name="某某智能科技股份有限公司",
        buyer_tax_id="91110108MA00000001",
        seller_name="某某云计算技术有限公司",
        seller_tax_id="91310000MA00000002",
        items=[
            InvoiceItem(
                name="*信息技术服务*云原生计算集群服务",
                specification="标准企业型",
                unit="月",
                quantity=Decimal("3.0"),
                unit_price=Decimal("10000.00"),
                amount=Decimal("30000.00"),
                tax_rate=Decimal("0.06"),
                tax_amount=Decimal("1800.00")
            ),
            InvoiceItem(
                name="*技术服务*企业级数据安全加固",
                specification="专享定制",
                unit="次",
                quantity=Decimal("1.0"),
                unit_price=Decimal("5000.00"),
                amount=Decimal("5000.00"),
                tax_rate=Decimal("0.06"),
                tax_amount=Decimal("300.00")
            )
        ],
        subtotal_amount=Decimal("35000.00"),
        total_tax_amount=Decimal("2100.00"),
        grand_total=Decimal("37100.00")
    )

    # 执行确定性规则验算
    audit_report = DocumentVerifier.verify_vat_invoice(mock_invoice)
    print("=== 发票自动化校验报告 ===")
    print(f"校验通过状态: {audit_report.is_valid}")
    print(f"健康度综合评分: {audit_report.calculated_confidence}/100")
    print(f"阻断性错误: {audit_report.error_messages}")
    print(f"警示性疑点: {audit_report.warning_messages}")
五、复杂场景攻坚:跨页文档与长表格抽取的关键技术
在真实业务场景中,最容易导致自动化流水线翻车的是跨页长文档。当一份财务报表或采购明细横跨 10 页以上时,传统的单页切片处理会面临严重的语义撕裂与表格断裂。
5.1 跨页长表格的表头丢失与行切片缝合
- 痛点:跨页表格通常在第一页包含完整的多级表头,但从第二页起直接以数据行开始,或者仅包含缩略表头。单页独立处理会导致后续页面的单元格丢失语义归属。
- 状态机解决方案:
- 跨页表格连通性检测:计算第 $N$ 页底部与第 $N+1$ 页顶部的表格边界坐标。如果两者的水平投影列对齐误差在阈值内,且第 $N$ 页底无总结行,状态机自动将其标记为连续表格。
- 表头继承与动态虚拟注入:在向模型发送第 $N+1$ 页图像时,将从第 $N$ 页提取的结构化表头上下文作为虚拟前缀拼接到请求中,确保模型明确知道每一列的业务定义。
- 单元格跨页拆分修复:对于被分页符硬性切成两半的文字描述单元格,利用下页首行的顶部空隙与对齐关系执行字符串拼接缝合。
5.2 跨页长合同的滑动窗口与指代消解
- 长上下文管理:几十页的商业合同如果一次性输入超大窗口模型,不仅 API 调用成本呈指数级上升,而且大模型普遍存在“中间信息丢失(Lost in the Middle)”的缺陷。
- 分层双通道抽取:
- 全局主干提取(Global Pass):前置只提取各级章节目录、主协议甲乙方、标的金额与签署页印章,建立合同的顶层骨架。
- 局部条款定向检索(Focused Window):针对违约责任、争议解决、保密义务等特定条款,使用向量检索(RAG)或语义切片准确定位相关自然段及其前后 200 字上下文,进行靶向深度抽取。
5.3 扫描件退化与印章遮挡的多通道容错
- 在真实的财务报销中,经常遇到手持手机拍摄的歪斜发票、低分辨率传真件或红色公章重叠覆盖核心文字。
- 通道分离技术:在预处理阶段,利用 HSV 颜色空间分离技术,将文档中的红色/蓝色印章层与黑色文字层分离为两个独立图层。
- 一方面让 OCR 与大模型专注于干净的文字层提取,消除印章条纹对阿拉伯数字(如将
8误认为0或3)的干扰;另一方面将独立的印章图层交由图像模型专职核验印章真伪与公章名称。
六、企业批量处理的性能、成本与高可用策略
当企业从“试点几份文件”走向“每天跑批数万份文件”时,API 调用成本与系统响应延迟将成为决定项目能否持续运转的核心指标。
6.1 成本压降三大杠杆
- 轻量版面分类器前置分流:绝不能让昂贵的多模态大模型做所有的粗活。使用端侧微型 CNN 或本地部署的轻量版面分析模型(推理耗时仅几十毫秒),先将文件精确分类为“标准发票”、“复杂报表”、“通用合同”。标准模板单据直接分流给传统高准确度模板引擎处理;仅有非结构化或复杂版式才上送到多模态大模型。
- Batch API 批量异步利用:多数主流模型服务商均提供 Batch API,承诺在 12 至 24 小时内完成非实时处理,价格通常比实时调用低 50%。对于夜间跑批的对账单、历史归档合同,全面走 Batch API 异步通道。
- 图像动态降采样与分块裁剪:原始单反拍摄的 4K 扫描图高达数十兆,直接上传会消耗巨量 Vision Token。在预处理阶段将图像自适应压缩至可辨识字迹的最小清晰分辨率(通常短边 1080px 即可满足绝大部分 OCR 需求),或仅对提取区域进行靶向切片送入。
6.2 幂等性与语义哈希缓存 (Semantic Cache)
- 企业内部往往存在大量反复流转的同类单据(如同一家供应商开出的数百张水电账单或办公用品清单)。
- 系统计算文档图像的感知哈希(pHash)以及版面几何签名。如果发现该单据的排版模板与系统中已收录的标准模板高度一致,直接复用既有的抽取规则坐标映射,省去大模型推理成本,且实现毫秒级响应。
6.3 异步分布式架构与状态机容灾
- 采用基于消息队列(如 Redis Stream 或 RabbitMQ)的生产者-消费者架构,解耦“文件上传”、“图像增强”、“模型抽取”、“确定性校验”与“系统回填”五个独立阶段。
- 明确状态流转:
$$\text{PENDING} \longrightarrow \text{PARSING} \longrightarrow \text{EXTRACTING} \longrightarrow \text{VERIFYING} \longrightarrow \text{COMPLETED} / \text{NEED_REVIEW}$$ - 单页解析超时或网络抖动绝不影响整个批次,系统支持在页级别实现“精确断点续抽”,避免整批文档因单页异常而全盘重跑。
七、企业落地文档 AI 的五大反模式与避坑指南
许多企业在引入文档 AI 项目时之所以陷入泥潭,往往并非因为技术选型落后,而是踩中了以下五个致命的工程反模式:
🚫 反模式一:直接将纯文本交给模型,期望大模型能够零幻觉理解复杂表格
- 表现:使用最基础的 PDF 提取库将文档直接 dump 出无排版的纯文本字符串,然后写一段长 Prompt 丢给纯文本大模型。
- 代价:多列排版的内容全部乱序穿插,表格中的跨列合并项彻底错位。模型在丢失二维空间几何拓扑后,极易通过“脑补”编造虚假的对应关系。
- 正确姿势:必须保留坐标元数据,利用多模态视觉模型或带 BBox 坐标的结构化格式输入。
🚫 反模式二:把数值求和、税额折算与平衡等式交给模型心算
- 表现:在 Prompt 中要求“请核对各行金额之和是否等于总额,并计算折让后实付价”。
- 代价:大语言模型在本质上是概率语言概率机,其符号数学推理天然存在微小浮动,在财务级零容忍场景中这是灾难性的。
- 正确姿势:模型只负责结构化提取,数学计算全部交给后置确定性代码(如 Python 的
Decimal运算模块)做百分之百的等式平衡检查。
🚫 反模式三:丢弃原始坐标,导致业务无法追溯验真与责任界定
- 表现:模型提取出的 JSON 只有纯键值对,没有任何关于“这个数字来自第几页、哪个坐标框”的元数据。
- 代价:当财务或审计人员发现录入系统的数据存疑时,必须重新肉眼通篇翻阅原始几百页的 PDF 进行比对,人机协同效率归零。
- 正确姿势:全流程强制携带 BBox 归一化坐标,实现点击字段秒级高亮原图对应切片。
🚫 反模式四:追求“100% 全自动无人值守”,缺乏人机协同工作台
- 表现:项目立项时制定了“必须达到 100% 自动入库,不允许任何人工参与”的脱离实际的目标。
- 代价:在边缘异常单据出现时,系统要么粗暴报错导致流程瘫痪,要么悄悄漏判导致重大商业损失。
- 正确姿势:将系统定位为“AI 完成 95% 繁琐机械录入,人工专注复核 5% 存疑异常点”,配备左右分屏联动的轻量化复核界面。
🚫 反模式五:未做前置隐私与合规脱敏,直接外发敏感数据
- 表现:直接将包含企业未公开核心财务数据、客户身份证正反面、高管个人私密签名的原件原封不动调用公有云 API。
- 代价:触犯数据合规与个人信息保护法律法规,面临严重的法务与声誉风险。
- 正确姿势:本地建立敏感数据过滤前哨,对敏感字段执行本地掩码替换,对于极端涉密核心文档采用企业私有化部署的开源多模态模型运行。
八、企业级文档智能处理系统 15 项生产上线自检清单
在将批量文档智能提取系统交付生产环境前,建议对照以下 15 项关键指标逐一自检:
| 序号 | 检查维度 | 核心检验项 | 验收达标标准 | 是否达标 |
|---|---|---|---|---|
| 1 | 数据准入 | 多格式与极端分辨率自适应 | 支持 PDF(矢量/扫描)、JPG、PNG、TIFF,支持 72dpi 至 600dpi 自适应缩放 | [ ] |
| 2 | 数据准入 | 图像方向与倾斜角度校正 | 对倒置、旋转 90/180/270 度及倾斜小于 15 度的扫描件实现毫秒级自动纠正 | [ ] |
| 3 | 安全合规 | 敏感信息(PII)本地前置脱敏 | 身份证号、个人银行账号在离开内网边界前完成正则识别与掩码处理 | [ ] |
| 4 | 版面解析 | 复杂多列排版阅读顺序还原 | 双栏与多栏布局不发生跨列横向串读,图文混排段落分块清晰 | [ ] |
| 5 | 版面解析 | 复杂及无线框表格拓扑重构 | 识别跨行跨列单元格合并,表格行列对齐准确率达到基准线以上 | [ ] |
| 6 | 模型抽取 | 结构化强类型契约约束 | 严格遵循 Pydantic/JSON Schema 约束,字段缺失时返回明确 null 而非幻觉补全 | [ ] |
| 7 | 模型抽取 | 坐标溯源(Grounding)覆盖率 | 所有核心数值与关键条款均能输出对应的页面索引与 BBox 坐标范围 | [ ] |
| 8 | 规则校验 | 财务发票确定性闭环校验 | 各行金额累加、税率折算、价税合计必须经由后端代码计算,误差绝对清零 | [ ] |
| 9 | 规则校验 | 合同周期与日期时序逻辑比对 | 生效日期早于到期日期,签约日期与履行起止节点符合常规时序逻辑 | [ ] |
| 10 | 工程性能 | 幂等性与语义哈希缓存命中 | 重复上传相同单据时实现 100% 幂等识别,标准高频单据实现毫秒级缓存直出 | [ ] |
| 11 | 工程性能 | 异步批量流水线削峰填谷 | 基于消息队列处理并发峰值,支持每分钟千页级稳定摄入,无内存泄漏 | [ ] |
| 12 | 高可用性 | 单页异常优雅降级与断点重跑 | 长文档中个别页面解析超时或损坏时不导致整批任务失败,支持断点补跑 | [ ] |
| 13 | 人机协同 | 左右联动双屏复核工作台 | 左侧原件像素级高亮聚焦,右侧表单字段联动,支持键盘快速 Tab 键审阅确认 | [ ] |
| 14 | 人机协同 | 异常分级智能告警与工单流转 | 校验不平衡或低置信度字段触发秒级标红告警,自动推入人工待办队列 | [ ] |
| 15 | 持续演进 | 人工纠偏数据的闭环飞轮 | 人工修改日志自动结构化沉淀,增量扩充 Few-Shot 样本库与系统回归测试集 | [ ] |
结语
从合同的法务条款核验,到成千上万张发票的税务合规审计,再到财务报表的严密勾稽平衡,文档处理的核心从来不是孤立的“文字识别”,而是“对业务规则的理解、对空间版面的尊重,以及对数据准确性的绝对敬畏”。
构建一套稳健的批量文档智能处理系统,真正的工程智慧在于“让模型做它最擅长的语义理解与模式识别,让确定性代码守住数学逻辑与数据合规的底线”。通过合理的分层架构、强类型输出契约、确定性规则审计与人机协同飞轮,企业才能将数以万计的纸质与电子文档真正转化为清晰、精准、即时可用的高质量业务资产。
如需进一步探讨复杂版面多模态处理方案、特定行业文档 Schema 深度定制,或了解企业级文档智能处理流水线的落地实践,欢迎随时通过 联系页面 与我们深入交流。