在生成式人工智能的快速演进中,开源大语言模型(Open-Source LLMs)已经完成了从“技术探索与追赶”到“在工业级业务中与专有商业模型分庭抗礼”的跨越式跃迁。两年前,企业搭建内部智能系统或垂直 Agent 时,几乎无一例外地依赖少数闭源商业 API;而今天,出于数据隐私安全合规、私有化机房本地部署、超高频调用成本控制、以及对核心业务认知资产完全掌控的诉求,越来越多的架构师与技术团队正在将主航道切换至开源模型生态。
然而,开源生态的繁荣也带来了极高的选型复杂度。当前市场上形成了三大不可忽视的主流技术阵营:以阿里云开源的 Qwen(通义千问) 系列为代表的中文全尺寸与全模态工业化旗舰;以深度求索开源的 DeepSeek(深度求索) 系列为代表的算法架构突破与极致能效推理先锋;以及以 Meta 开源的 Llama 系列为代表的全球开源事实标准与开发者社区基石。
面对不同架构特点、参数体量、显存开销与长板领域各异的候选模型,很多团队在落地时陷入纠结:
- 为什么在英文基准上表现抢眼的海外模型,放进中文企业公文润色或政企客服中却常常显得“词不达意”?
- 同样是宣称数十亿甚至上百亿参数,为什么有的模型在单张消费级显卡上跑得飞快,而有的模型在多卡服务器上依然频繁面临显存溢出(OOM)?
- 密集型架构(Dense)与混合专家架构(MoE)在实际私有化部署中究竟该如何权衡算力与内存带宽?
- 当业务需要代码生成、长文档知识库问答或严密的多步数学推理时,各大开源模型究竟孰优孰劣?
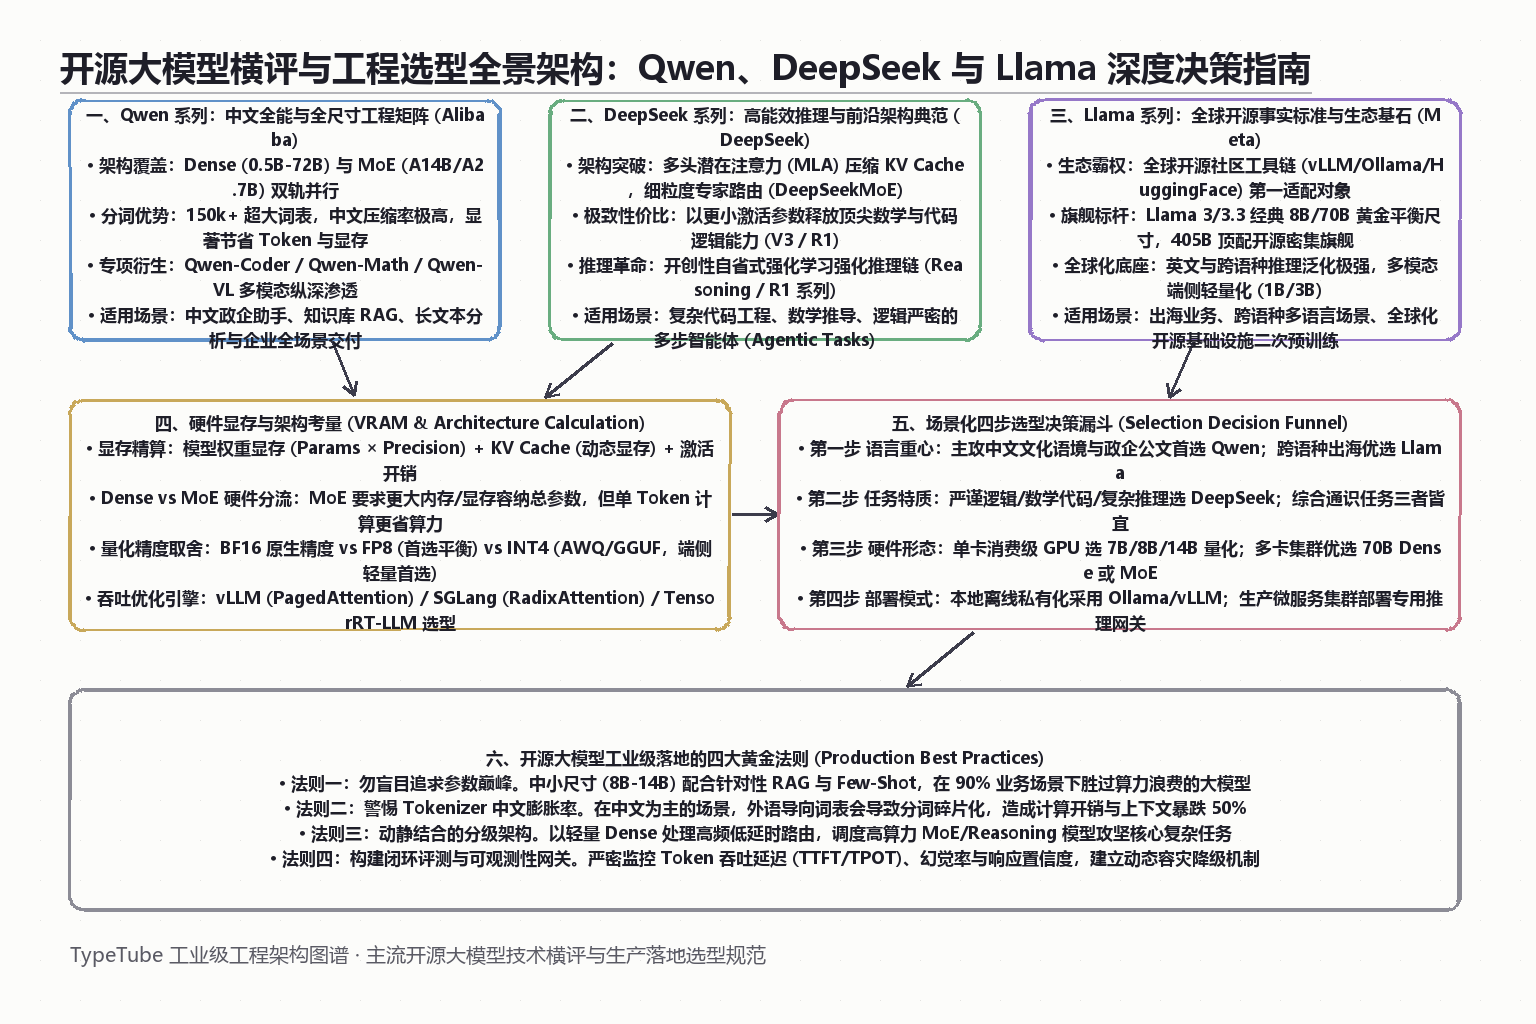
本文将跳出单纯跑分榜单的表面数据,从底层架构设计、分词编码效率、硬件显存精算、核心场景实测表现、工程化部署适配性等多个工程维度,对 Qwen、DeepSeek 与 Llama 三大开源系列展开深度横向评测,并提供一套可落地的多模型动态路由代码与 15 项企业级生产上线自检清单,帮助你在具体业务场景中做出最稳健的技术选型。
一、三大主流开源模型阵营全景剖析
任何模型选型的前提,是深刻理解其技术演进脉络、团队设计哲学与核心受众定位。
1. Qwen 系列:中文全场景与全尺寸工业化矩阵
阿里云开源的 Qwen(通义千问)系列(尤其是最新的 Qwen2.5 家族),在开源社区中以“型号完备、工业化程度极高、中文语境深厚”著称。
- 全尺寸阶梯覆盖:Qwen 提供了从 0.5B、1.5B、3B、7B、14B、32B 到 72B 的完整 Dense 密集模型阶梯,并在部分尺寸上布局了混合专家版本(如 Qwen2.5-14B-Instruct 与各类 MoE 版本)。这种细密的分级让架构师无论是在树莓派、移动端、单张消费级显卡(如 RTX 4090),还是在多卡数据中心集群,都能找到无需破坏性裁剪即可严丝合缝匹配的尺寸。
- 庞大的分词词表(Tokenizer):Qwen 采用了超过 15.2 万(约 152,064)词表的 Tiktoken 变体。这一设计让它在处理中文文本时具备极高的“字词压缩比”。相比传统外语主导模型一个汉字切分为 2 到 3 个 Token 的低效现象,Qwen 平均一个中文字符仅消耗约 0.6 至 0.8 个 Token,在中文长文档和高并发交互中直接节约了大量的计算量与显存开销。
- 专项垂直衍生深度演进:除了通用 Instruct 对齐版本,Qwen 官方推出了深度强化的专项版本:
- Qwen2.5-Coder:在海量高质量代码数据上二次预训练与对齐,被广泛认为是当前开源界最强且工具调用(Tool Calling / Function Calling)稳定性最高的代码模型之一。
- Qwen2.5-Math:针对数学公式推导与中英文几何/代数题目进行了极高强度的针对性训练。
- Qwen-VL:覆盖端到端视觉文档、图表理解与复杂 OCR 的多模态旗舰。
2. DeepSeek 系列:架构创新与高能效推理先锋
DeepSeek(深度求索)作为由顶尖量化对冲背景演化而来的技术驱动型 AI 实验室,其开源模型走了一条截然不同的“以顶层数学架构创新换取极致推理性价比”的路线。
- 多头潜在注意力机制(MLA - Multi-head Latent Attention):这是 DeepSeek 架构最核心的杀手锏之一。传统 Transformer 随着序列长度暴涨,KV Cache(键值缓存)会吞噬数十吉字节(GB)甚至数百吉字节显存,导致并发请求吞吐断崖式下跌。DeepSeek 创新性地在注意力机制中引入低秩潜在投影(Low-rank Compression),将推理阶段所需的 KV Cache 压缩到了常规多头注意力机制的约十分之一甚至更低,使得长文本和高并发场景的显存瓶颈得到极大缓解。
- 细粒度混合专家系统(DeepSeekMoE):与早期行业内“少量粗粒度大专家”的做法不同,DeepSeek 采用了“细粒度切分专家 + 共享常驻专家”的创新拓扑。模型将每个专家的参数规模缩小,同时大幅增加专家总数,并固定分配一部分共享专家用于保留全网通用先验知识。这使得模型在推理时每次激活的参数量极小(例如仅激活十几亿到两百多亿参数),却能迸发出远超同等激活计算量的密集模型表现。
- 自省式强化学习与推理革命(R1 路线):DeepSeek 开创性地探索了大模型“思考时间(Test-time Compute)扩展”机制。通过纯强化学习(RL)在没有大规模人工监督微调数据标注的情况下,引导模型自主涌现出反思、回溯、验证的“思维链(Chain of Thought)”,在数学推导、算法竞赛和高难度逻辑论证上取得了突破性成绩。
3. Llama 系列:全球开源事实标准与生态基石
由 Meta 主导开源的 Llama 系列(从最初的 Llama、Llama 2 到演进至成熟形态的 Llama 3、3.1、3.2 及 3.3),是推动当代开源 AI 浪潮的奠基者与事实标准。
- 无可撼动的生态位:全球绝大部分开源推理加速库(如 vLLM、SGLang、TGI、TensorRT-LLM)、端侧运行框架(Ollama、llama.cpp、MLC-LLM)、评估工具集(OpenCompass、lm-evaluation-harness)以及微调框架(Llama-Factory、Unsloth),在新功能发布时均优先以 Llama 的模型张量结构作为官方黄金验证基准。这意味着选择 Llama 拥有全行业最平滑的部署文档、最少踩坑的预编译算子库以及最丰富的社区衍生 LoRA 权重。
- 清晰稳固的产品线:Llama 3.x 家族形成了极其明晰的梯度布局:
- 8B:边缘计算、本地开发工作站与单卡轻量应用的性能标杆。
- 70B:在算力开销与企业复杂业务逻辑之间达到黄金平衡的绝对主力,几乎是全球各家云厂商开源托管服务的标配。
- 405B:首个跨越四千亿参数大关的开源顶级 Dense 旗舰,虽然对自建算力门槛极高,但为学术界和工业界提供了无需依赖闭源商业 API 的最强蒸馏教师模型(Teacher Model)。
- 1B / 3B(Llama 3.2):专门面向手机、嵌入式硬件与端侧纯本地运行的超轻量模型。
- 天然的国际化视野:由于预训练语料库以海量全球多语言及高质量英文为主,Llama 系列在英文语义理解、跨文化泛化、全球法规遵从以及西方技术栈文档处理上展现出极高的稳定性。
二、三大流派核心技术特性与架构横向对比
为了让架构师在方案设计时能够直观对比关键参数,我们将三大系列的核心架构指标整理为以下对照矩阵:
| 关键评估维度 | Qwen 2.5 系列 (Alibaba) | DeepSeek V2.5 / V3 / R1 (DeepSeek) | Llama 3.x 系列 (Meta) |
|---|---|---|---|
| 主流架构类型 | 稠密密集型 (Dense) 为主,兼有特定尺寸 MoE 版本 | 纯 MoE 架构(结合细粒度专家 + 共享专家) | 纯稠密密集型架构 (Dense) |
| 注意力机制设计 | 标配 GQA (Grouped Query Attention) | 独创 MLA (Multi-head Latent Attention),大幅压缩 KV Cache | 标配 GQA (Grouped Query Attention) |
| 词表容量 (Vocab Size) | ~152,064 (超大词表) | ~102,400 (标准大词表) | ~128,256 (扩展大词表) |
| 中文 Token 压缩比 | 极高(平均 0.6~0.8 Token / 中文字符) | 高(平均 0.9~1.1 Token / 中文字符) | 中等偏低(平均 1.3~1.6 Token / 中文字符) |
| 原生支持上下文窗口 | 原生 128K,长文本扩展能力强 | 原生 64K~128K(结合 MLA 显存极其友好) | 原生 128K(长距离衰减平缓) |
| 代码与工具调用支持 | Qwen2.5-Coder 极强,原生 JSON/Tool 对齐极佳 | 原生代码与数学极强,R1 推理链表现顶尖 | 70B/405B 工具调用成熟,小模型略有格式抖动 |
| 生态框架成熟度 | 极高(国内主流框架与国际主流工具全覆盖) | 快速上升(主流 vLLM/SGLang 已支持,量化需专属优化) | 行业最高(全球事实工业标准,零适配成本) |
| 开源商用许可约束 | 绝大多数尺寸支持商业授权,政策宽松友好 | 遵循宽松开源协议,支持商业使用与改动 | 允许商业使用,但月活超 7 亿用户需 Meta 特别许可 |
| 最适用的核心业务 | 中文政企助手、知识库 RAG、长文档提炼、轻量化本地端侧 | 复杂算法推导、代码工程重构、深层逻辑智能体 (Agent) | 全球化跨语种业务、英文技术文档解析、开源生态集成 |
三、分场景硬核实战评测与表现剖析
技术指标是骨架,实际业务场景的产出质量才是灵魂。在实际业务中,我们选取了企业最常面临的四大典型场景进行深度对比。
场景 1:中文日常问答、公文写作与文化语境理解
在涉及中文复杂句式、成语典故、政企机关公文格式规范、行业专业术语以及细微情感倾向的场景中:
- Qwen 2.5 系列表现(优异 ⭐⭐⭐⭐⭐):
Qwen 展现出了无可争议的母语级原生优势。它对中文行政公文(如会议纪要、工作汇报、党政公文排版规范)、行业合规用语的拿捏非常精准,完全没有“英翻中”的生硬翻译腔。在对古诗词解析、方言理解或歇后语推理时,Qwen 能够给出准确的文化背景解释。 - DeepSeek 系列表现(良好 ⭐⭐⭐⭐☆):
DeepSeek 的中文理解力同样极高,表达非常干练直白,尤其在逻辑陈述和技术型报告的撰写上逻辑清晰、废话极少。但在面对极度本土化的泛文学创作或特定机关文书的格式修辞时,偶尔略显偏向理工科学术风格。 - Llama 3.x 系列表现(可用 ⭐⭐⭐☆☆):
尽管 Llama 3.x 将词表扩充到了 128K 并大幅增加了多语言语料,但在中文复杂上下文下,依然时常暴露出“底层由英文思维主导”的痕迹。在长篇中文生成时,偶尔会出现语序倒装、生造词汇或翻译腔。此外,由于分词碎片化,在输出相同中文篇幅时,Llama 消耗的实际 Token 数量比 Qwen 显著高出 40% 到 60%,导致生成的端到端等待延迟明显拉长。
场景 2:代码工程、脚本编写与复杂 Agent 工具调用
现代 AI 系统越来越多地被用于自动化运维、代码重构以及多步骤工具调用(Function Calling):
- Qwen 2.5-Coder(顶级 ⭐⭐⭐⭐⭐):
在代码生成领域,Qwen2.5-Coder(尤其是 32B 与 7B 版本)在主流公开基准(如 HumanEval、MBPP、LiveCodeBench)以及多步 Bug 定位上均交出了极度惊艳的答卷。对于结构化 JSON 输出与 Tool Calling 的遵循率极高,很少出现“参数漏填”或“未按 Schema 格式返回”的错误。 - DeepSeek 系列(顶级 ⭐⭐⭐⭐⭐):
代码与数学推导是 DeepSeek 的传统优势领域。DeepSeek-Coder 无论是在算法实现、复杂 SQL 优化还是底层 C++/Python 架构设计上,代码可运行率与边缘边界处理(Edge Cases)都表现得异常扎实。在配合 R1 推理链时,它甚至能自主在内部模拟单元测试并推演极端输入,主动发现潜在的内存泄漏或死锁风险。 - Llama 3.x 系列(良好 ⭐⭐⭐⭐☆):
Llama 3 70B 和 405B 的代码能力属于业界一流水准,通用编程范式、主流框架(如 React、FastAPI、Spring Boot)的代码片段质量极高。然而在较小尺寸(如 8B)上,处理多参数嵌套工具调用或严格 JSON Schema 约束时,偶有格式溢出或语法微小错误的现象。
场景 3:复杂推理、数学计算与逻辑推导
针对金融风控决策、逻辑归因、数学竞赛级解题以及多跳推理任务:
- DeepSeek R1 / 推理流派(降维打击 ⭐⭐⭐⭐⭐):
DeepSeek 展现出了在开源界独特的“思考能力”。面对极其复杂的逻辑谜题或需要多步演算的数学应用题,模型会生成结构清晰的<think>过程,展开自我质疑、假设检验与步骤复核,在最终输出前修正初期的直觉性错误。这种思考时间的可扩展性使得它在硬核逻辑场景的命中率远超常规单次直接输出模型。 - Qwen 2.5 / Qwen 2.5-Math(优异 ⭐⭐⭐⭐☆):
Qwen 2.5-Math 在纯数学题目上成绩极其亮眼,配合代码解释器(Code Interpreter)能够实现极高精度的方程式求解与统计检验。通用版本的 72B 尺寸逻辑链条严密,但在面对非确定性逻辑陷阱题时,推理的自省能力略逊于引入专用强化学习思考机制的 R1。 - Llama 3.x 系列(优秀 ⭐⭐⭐⭐☆):
Llama 3 70B 在逻辑推理上表现非常稳重,遵循标准 CoT(思维链)时具备很高的准确率。不过对于中国特有的逻辑题目或本土业务业务逻辑(如特定税率与社保计算规则),有时需要额外的 Few-Shot 提示词进行背景对齐。
场景 4:超长文档分析与企业知识库 RAG(检索增强生成)
长文本与知识库召回是企业落地最高频的场景:
- Qwen 2.5 系列(优异 ⭐⭐⭐⭐⭐):
原生 128K 上下文支持,在“大海捞针”(Needle In A Haystack)测试中无论信息位于文档开头、中间还是末尾,均具备几乎 100% 的精准召回率。更关键的是,得益于超高中文压缩率,相同的 128K Token 窗口,Qwen 能容纳近 15 万字以上的中文原始材料,而 Llama 只能塞进约 8 至 9 万字。 - DeepSeek 系列(优异 ⭐⭐⭐⭐⭐):
在 MLA(多头潜在注意力)加持下,DeepSeek 在长文本推理时的显存占用优势无人能及。很多时候知识库问答面临的不是“能不能读完”,而是多用户并发提问时服务器显存瞬间被挤爆。DeepSeek 的低显存开销使得它成为高并发长文本知识库服务极具竞争力的底座。 - Llama 3.x 系列(良好 ⭐⭐⭐⭐☆):
虽然 Llama 3.1 起原生支持 128K,但在超长序列下注意力分散(Attention Dilution)和“中间迷失”(Lost in the Middle)现象相对更为敏感,需要配合精细的重排(Rerank)与更细颗粒度的分块(Chunking)策略。
四、工程化落地:显存算力开销公式与部署成本精算
在将开源模型推向私有化服务器或云端 GPU 实例时,架构师必须进行严格的显存与吞吐预算精算。
1. 显存估算黄金公式
运行一个大语言模型所需的 GPU 显存总量 $VRAM_{total}$,由四个核心部分构成:
$$VRAM_{total} = VRAM_{weights} + VRAM_{kv_cache} + VRAM_{activation} + VRAM_{cuda_overhead}$$
其中:
- 模型权重显存($VRAM_{weights}$):
$$VRAM_{weights} \approx P \times \frac{B}{8} \times 1.2$$- $P$ 为模型参数总量(如 7B、14B、70B)。
- $B$ 为量化位宽(FP16/BF16 为 16 位即 2 字节;FP8 为 8 位即 1 字节;INT4 为 4 位即 0.5 字节)。
- 乘以 1.2 是为了预留框架加载权重时的张量对齐与临时缓冲开销。
- KV Cache 显存($VRAM_{kv_cache}$):
对于标准 GQA 架构模型,每个 Token 的 KV 缓存开销计算如下:
$$Bytes_{per_token} = 2 \times L \times H_{kv} \times D_{head} \times Bytes_{dtype}$$- $L$ 为 Transformer 层数(Layers)。
- $H_{kv}$ 为 KV 注意力头数量(Key/Value Heads)。
- $D_{head}$ 为每个注意力头的维度。
- $Bytes_{dtype}$ 为缓存数据类型字节数(通常为 2 字节 FP16,或 1 字节 FP8)。
- 总 KV 显存为 $Bytes_{per_token} \times Context_Length \times Batch_Size$。
特别提示:而对于使用 MLA(Multi-head Latent Attention) 的 DeepSeek,其 KV Cache 将维度投影到极低的隐空间向量,单个 Token 所需的缓存字节数仅为传统 GQA 的约 $10% \sim 15%$,在高并发长上下文场景下能直接挽救数十 GB 显存!
2. 常见尺寸量化配置与推荐硬件规格对照表
| 模型规格与量化精度 | 纯权重显存开销 | 推荐最小单卡/多卡硬件配置 | 推荐吞吐加速引擎 | 典型适用场景 |
|---|---|---|---|---|
| Qwen 2.5 7B (BF16) | 约 15 GB | 单张 RTX 4090 (24GB) / A10 (24GB) | vLLM / Ollama | 部门级轻量知识库、本地代码审查 |
| Qwen 2.5 14B (FP8/INT4) | 约 9 ~ 15 GB | 单张 RTX 4090 (24GB) | vLLM / SGLang | 生产级性价比中枢、企业问答核心 |
| Qwen 2.5 32B (AWQ 4-bit) | 约 20 GB | 单张 RTX 4090 (24GB) / A5000 (24GB) | vLLM (AWQ 优化) | 高难度代码、复杂表格信息抽取 |
| Qwen 2.5 72B (FP8) | 约 76 GB | 2 张 A100 (80GB) 或 4 张 RTX 4090 | vLLM (Tensor Parallel=2/4) | 全功能企业大脑、跨语种复杂分析 |
| Llama 3.1 8B (BF16) | 约 16 GB | 单张 RTX 4090 (24GB) / T4 (双卡) | Ollama / vLLM | 边缘设备部署、英文场景助手 |
| Llama 3.3 70B (FP8) | 约 75 GB | 2 张 A100 (80GB) 或 2 张 H100 (80GB) | TensorRT-LLM / vLLM | 顶级英文语义分析、出海业务中台 |
| DeepSeek V3 / R1 (MoE 量化) | 需高显存集群支持 | 4~8 卡专业数据中心 GPU 集群 | SGLang / vLLM (MLA/MoE 加速) | 极限推理与数学攻坚、平台级私有服务 |
五、轻量实战:基于通用接口的开源多模型自适应路由网关
在真实的生产系统中,永远不要试图用一个模型搞定全公司的所有业务。最优雅且成本可控的工程架构,是搭建一个“自适应多模型路由网关”:将高频简单的意图分流至 7B/8B 轻量模型,将深度中文文档处理路由给 Qwen,将复杂算法与推理任务派发给 DeepSeek,将英文出海任务分派给 Llama。
以下提供一套生产级、带降级熔断与健康探测的自适应路由网关 Python 实现(基于标准 OpenAI 兼容协议),可无缝对接本地 Ollama、vLLM 或本地私有化集群:
import os
import time
import asyncio
from typing import List, Dict, Any, Optional
from pydantic import BaseModel, Field
import httpx

class ModelEndpoint(BaseModel):
    name: str
    base_url: str
    api_key: str = "EMPTY"
    model_identifier: str
    primary_category: str  # "chinese_general", "deep_reasoning", "coding", "english_overseas"
    max_context: int
    is_alive: bool = True
    consecutive_failures: int = 0

class RoutingDecision(BaseModel):
    selected_model: str
    reason: str
    estimated_tokens: int

class AdaptiveLLMRouter:
    """
    生产级开源多模型自适应分流与高可用降级网关
    支持:基于任务特征的意图分流、健康探针检测与自动故障转移 (Failover)
    """

    def __init__(self, endpoints: List[ModelEndpoint]):
        self.endpoints = {ep.name: ep for ep in endpoints}
        self.client = httpx.AsyncClient(timeout=60.0)

    def estimate_tokens(self, text: str) -> int:
        """简易混合分词估算:中文字符按 0.8 权重,英文字词按 1.3 权重估算"""
        chinese_chars = sum(1 for char in text if '\u4e00' <= char <= '\u9fff')
        other_chars = len(text) - chinese_chars
        return int(chinese_chars * 0.8 + (other_chars / 4) * 1.3)

    def decide_route(self, prompt: str, task_hint: Optional[str] = None) -> RoutingDecision:
        estimated_tokens = self.estimate_tokens(prompt)
        prompt_lower = prompt.lower()

        # 1. 深度推理与数学逻辑意图判定
        is_reasoning_task = any(kw in prompt_lower for kw in [
            "证明", "推导", "数学", "算法", "竞赛", "为什么", "逻辑链", "深度分析", "step by step"
        ]) or task_hint == "reasoning"

        # 2. 代码工程与工具调用意图判定
        is_coding_task = any(kw in prompt_lower for kw in [
            "def ", "class ", "function", "import ", "sql", "bug", "报错", "重构", "编写一段代码"
        ]) or task_hint == "coding"

        # 3. 语言倾向判定:判断是否为纯英文/出海语境
        chinese_count = sum(1 for char in prompt if '\u4e00' <= char <= '\u9fff')
        is_pure_english = len(prompt) > 50 and (chinese_count / len(prompt)) < 0.05

        # 路由仲裁决策
        if is_reasoning_task and "deepseek-r1" in self.endpoints and self.endpoints["deepseek-r1"].is_alive:
            return RoutingDecision(
                selected_model="deepseek-r1",
                reason="命中严密数学推导与深度逻辑分析特征,分流至具备思维链反思的模型",
                estimated_tokens=estimated_tokens
            )

        if is_coding_task and "qwen-coder" in self.endpoints and self.endpoints["qwen-coder"].is_alive:
            return RoutingDecision(
                selected_model="qwen-coder",
                reason="命中软件研发、代码重构与结构化输出特征,分流至专业编程模型",
                estimated_tokens=estimated_tokens
            )

        if is_pure_english and "llama-3" in self.endpoints and self.endpoints["llama-3"].is_alive:
            return RoutingDecision(
                selected_model="llama-3",
                reason="输入为纯英文语境,分流至具备全球开源生态基准的英文基底模型",
                estimated_tokens=estimated_tokens
            )

        # 默认兜底策略:中文综合首选 Qwen 家族
        fallback_name = "qwen-general" if self.endpoints.get("qwen-general", {}).is_alive else "llama-3"
        return RoutingDecision(
            selected_model=fallback_name,
            reason="综合中文理解与通用公文写作场景,分流至高压缩比全能底座",
            estimated_tokens=estimated_tokens
        )

    async def forward_completion(self, messages: List[Dict[str, str]], task_hint: Optional[str] = None) -> Dict[str, Any]:
        """执行端到端转发,集成重试与自动故障熔断"""
        last_user_message = next((m["content"] for m in reversed(messages) if m["role"] == "user"), "")
        decision = self.decide_route(last_user_message, task_hint)
        target = self.endpoints[decision.selected_model]

        # 构造 OpenAI 兼容请求
        payload = {
            "model": target.model_identifier,
            "messages": messages,
            "temperature": 0.2 if "coder" in target.name or "r1" in target.name else 0.7,
            "stream": False
        }
        headers = {"Authorization": f"Bearer {target.api_key}", "Content-Type": "application/json"}

        try:
            response = await self.client.post(
                f"{target.base_url}/chat/completions",
                json=payload,
                headers=headers,
                timeout=45.0
            )
            response.raise_for_status()
            target.consecutive_failures = 0
            res_data = response.json()
            res_data["_routing_metadata"] = decision.dict()
            return res_data
        except Exception as e:
            # 记录故障并尝试故障转移
            target.consecutive_failures += 1
            if target.consecutive_failures >= 3:
                target.is_alive = False

            # 紧急灾备降级
            backup_target = next((ep for ep in self.endpoints.values() if ep.is_alive and ep.name != target.name), None)
            if not backup_target:
                raise RuntimeError(f"所有模型节点均不可用,主节点错误: {str(e)}")

            payload["model"] = backup_target.model_identifier
            resp_fallback = await self.client.post(
                f"{backup_target.base_url}/chat/completions",
                json=payload,
                headers={"Authorization": f"Bearer {backup_target.api_key}", "Content-Type": "application/json"},
                timeout=45.0
            )
            resp_fallback.raise_for_status()
            res_json = resp_fallback.json()
            res_json["_routing_metadata"] = {
                "selected_model": backup_target.name,
                "reason": f"主节点 {target.name} 异常触发故障降级: {str(e)}",
                "estimated_tokens": decision.estimated_tokens
            }
            return res_json

    async def close(self):
        await self.client.aclose()
六、不同体量团队与业务场景的选型决策漏斗
为了在最短时间内协助团队达成共识,我们提炼出一套简单直接的“四问决策漏斗”:
         [业务需求启动]
                │
【第一问:语言分布是中文主导还是全球多语言?】
                ├── 中文/国内政企语境为主 ────► 【优先聚焦 Qwen 系列】
                └── 纯海外业务/出海跨语种 ────► 【优先聚焦 Llama 系列】
                │
【第二问:任务核心是深层数理/代码还是综合通识?】
                ├── 算法推导/竞赛/复杂链式思考 ──► 【选型 DeepSeek R1 / V3】
                ├── 生产级编码/工具调用/架构设计 ─► 【选型 Qwen2.5-Coder / DeepSeek-Coder】
                └── 知识问答/日常总结/多轮客服 ──► 【选型 Qwen 7B/14B / Llama 8B】
                │
【第三问:硬件基础设施能承受多大显存预算?】
                ├── 单张消费级 GPU (16G-24G) ───► 【7B/8B/14B 量化版本 (AWQ/GGUF)】
                ├── 双卡/四卡数据中心服务器 ────► 【32B/70B FP8 生产级部署】
                └── 算力充足的多节点云端集群 ──► 【MoE 架构顶级旗舰】
                │
【第四问:是否需要严格的本地离线与极低维护门槛?】
                ├── 极简一键运行/开发机本地测试 ─► 【Ollama + Llama/Qwen 黄金尺寸】
└── 高并发生产集群/动态路由调度 ─► 【vLLM/SGLang + 多模型分层接入网关】- 初创团队与独立开发者(单卡环境):
- 强烈推荐 Qwen 2.5 7B / 14B(中文及全场景)或 Llama 3.1 8B(英文海外)。在单张 24GB 显存显卡上采用 AWQ 4-bit 或 FP8 量化,即可同时获得极高的吞吐与极其出色的日常任务响应。
- 中大型企业内部数字中台(多卡私有化机房):
- 推荐构建“双核”标准架构:以 Qwen 2.5 32B / 72B(FP8) 作为主对话与知识库中枢,同时部署 Qwen 2.5-Coder 或接入 DeepSeek V3 / R1 作为复杂工具链调用与深度推理算力插件。
- 出海 SaaS 与跨国业务系统:
- 首选 Llama 3.3 70B 作为核心基础能力底座,借助其强大的多语言泛化与全球开发者社区生态,大幅降低与国际云厂商及外部工具集成的时间成本。
七、开源大模型落地常见的五大避坑反模式
在过去的实际生产落地辅导中,我们观察到技术团队最常踩中以下五大认知陷阱:
反模式 1:盲目追求“顶配最大尺寸”,导致服务吞吐与并发直接跑崩
很多团队在立项时执着于“必须上 70B 以上或数千亿参数大模型”,却忽略了并发请求下的 KV Cache 开销。结果两三个人并发上传长文档,显存瞬间耗尽,首字延迟(TTFT)拉长到十几秒。真正常态化的做法是:80% 的高频日常业务交给经过精调或 Few-Shot 的 7B~14B 模型,真正遇到需要深思熟虑的极难问题才分流给大尺寸旗舰。
反模式 2:忽视 Tokenizer 中文膨胀率,算力凭空浪费 50%
在纯中文业务场景下直接照搬外语主导的大模型。虽然模型本身能力不俗,但由于其词表未对中文汉字进行足够合并,一个汉字被切碎成多个 Token,导致上下文窗口无形中缩水一半、生成同样的回答耗时多出一倍。在中文为主的场景,词表压缩比是一个决定并发成本的生死指标。
反模式 3:无脑将所有模型量化至 4-bit 甚至更低
量化确实能大幅节省显存,但不同的能力对精度损失的敏感度截然不同。常识问答和泛文本润色在 INT4 下几乎看不出差别;然而对于多步数学推理、严格代码缩进与 JSON Schema 格式遵循,过于激进的 4-bit 量化经常导致逻辑断裂与括号闭合错误。涉及严密代码与逻辑任务时,建议至少保留 FP8 精度。
反模式 4:把开源模型当成“一次性黑盒”,缺乏评测回归基线
很多团队在本地部署好模型后就宣布上线,后续当底层推理引擎升级(例如升级 vLLM 版本或调整 Sampling 参数)时,缺乏一套包含历史 Bad Case 的自动化回归测试集,往往导致线上输出风格突变或幻觉率飙升而浑然不知。
反模式 5:忽视开源商业许可协议中的隐性条款
虽然开源模型允许商业使用,但各自协议中包含具体限定。例如部分许可要求二次分发衍生权重时必须标注原作者信息,有的协议针对超大规模月活应用(例如过亿月活)保留了专门授权审查要求。企业在将开源模型封装进商业化产品前,必须让合规与法务团队审阅具体的开源 License 协议全文。
八、生产级开源大模型选型与部署自检清单
在正式将开源大模型投入企业线上生产环境前,建议对照以下 15 项核心指标逐项复核:
- 1. 业务场景语言分布评估:已清晰界定系统输入输出中中文、英文及代码的比例。
- 2. 分词压缩比实测:已针对业务典型样本测试目标模型的 Token 消耗速率。
- 3. 硬件显存上限计算:不仅计算了权重显存,还精确预留了最大并发下的 KV Cache 开销。
- 4. 推理引擎选型:在 vLLM(通用高吞吐)、SGLang(复杂结构化推理)与 Ollama(本地简易运维)间完成基准压测。
- 5. 上下文长度硬边界配置:根据显存限制锁定了最大上下文长度(
max_model_len),防止超长异常输入导致 OOM 崩溃。 - 6. 结构化输出能力验证:已在目标尺寸上充分验证 JSON Mode / Function Calling 格式稳定性。
- 7. 量化精度与质量折衷验证:已确认所选量化等级(BF16 / FP8 / AWQ)未破坏核心数学与逻辑推理能力。
- 8. 动态路由与多模型兜底:已部署前置路由网关,具备主节点故障时的秒级降级能力。
- 9. 首字延迟 (TTFT) 与生成速度 (TPOT) 监控:已建立 P95 / P99 响应延迟的 Prometheus / Grafana 指标告警。
- 10. 知识库 RAG 召回精度复核:针对长文本是否具备完整的“大海捞针”与逆向溯源支撑。
- 11. 敏感词过滤与前置安全护栏:在输入与输出层部署了企业级合规校验与提示词注入防护。
- 12. 离线环境与依赖锁定:生产服务器完全断网环境下,模型权重、分词配置与推理镜像均能顺利冷启动。
- 13. 并发压力测试:在峰值 QPS 模拟下测试排队等待队列行为,确认无显存泄漏或僵死进程。
- 14. 开源协议法务审查:已核实所选开源模型商用条款与二次分发免责声明。
- 15. 自动化回归评测集:构建了至少 100 条涵盖典型业务边界的黄金自测数据集,用于版本迭代对照。
结语
在当下的技术浪潮中,大模型已经告别了“单一霸主通吃”的时代。Qwen 系列在中文工业化与全场景矩阵上的精耕细作、DeepSeek 在算法架构创新与推理能效上的惊艳突围、以及 Llama 系列在全球开源基础设施中的坚固底座,共同构成了一个充满生机的开源大模型黄金时代。
技术的终局不是盲目崇拜参数规模,而是在成本、性能、延迟与稳定性之间找到最优雅的平衡支点。希望本文的架构解析、量化算力模型与多模型路由设计,能为你正在构建的企业级智能系统提供切实可行的参考。
如果你在开源大模型私有化部署、量化微调、多模型网关搭建或企业级 RAG 架构设计中遇到了具体的性能瓶颈与工程挑战,欢迎随时与我们交流探讨:TypeTube 读者交流与技术咨询。