在多媒体传播与数字营销领域,视频早已成为信息传递效率最高、用户注意力最集中的载体。然而,传统的专业视频制作流程却是一项极度依赖人工经验且耗时冗长的工作:从前期的选题策划、脚本大纲撰写,到分镜头撰写、旁白配音录制、音轨降噪切片,再到非线性编辑软件(如 Premiere、Final Cut 或剪映)中逐帧拖拽视音频素材、手动调整字幕时间轴、挑选背景音乐并调节动态电平,一条 3 到 5 分钟的优质科普或业务解说视频,往往需要消耗专业剪辑人员数小时甚至整整一天的时间。
近年来,随着大语言模型、高拟真神经语音合成(TTS)、扩散模型生图以及视频生成技术的集中爆发,市面上涌现了大量打着“一键成片”旗号的在线 SaaS 工具。许多个人创作者与企业团队满怀期待地接入这些工具后,却迅速遭遇了新的现实困境:
- 黑盒不可控:一键生成的视频充斥着逻辑脱节的库存素材,文不对题,关键专业术语往往被配上毫不相关的风景空镜头;
- 强烈的廉价 AI 感:机械刺耳的机器配音、生硬平移的 PPT 式画面切换、缺乏起伏的语调,导致观众在前 3 秒就迅速划走,平均完播率极低;
- 平台算法审查封禁:由于依赖高度模板化的固定公用素材库与统一的文本生成逻辑,批量产出的视频极易被主流短视频与内容分发平台的去重机制判定为“低质重复搬运”或“同质化矩阵号”,不仅难以获得推荐流量,甚至可能面临限流惩罚;
- 无法与垂直业务逻辑集成:既有的商业工具难以嵌入企业原有的自动化数据流、CMS 内容库或特定的品牌视觉规范(VI)。
真正的工业级 AI 视频自动化,绝不是将制作权拱手让给一个充满随机性的不可控黑盒,而是将传统的作坊式视听生产拆解为可编程、可测试、可复现、高度可控的现代化软件工程流水线。
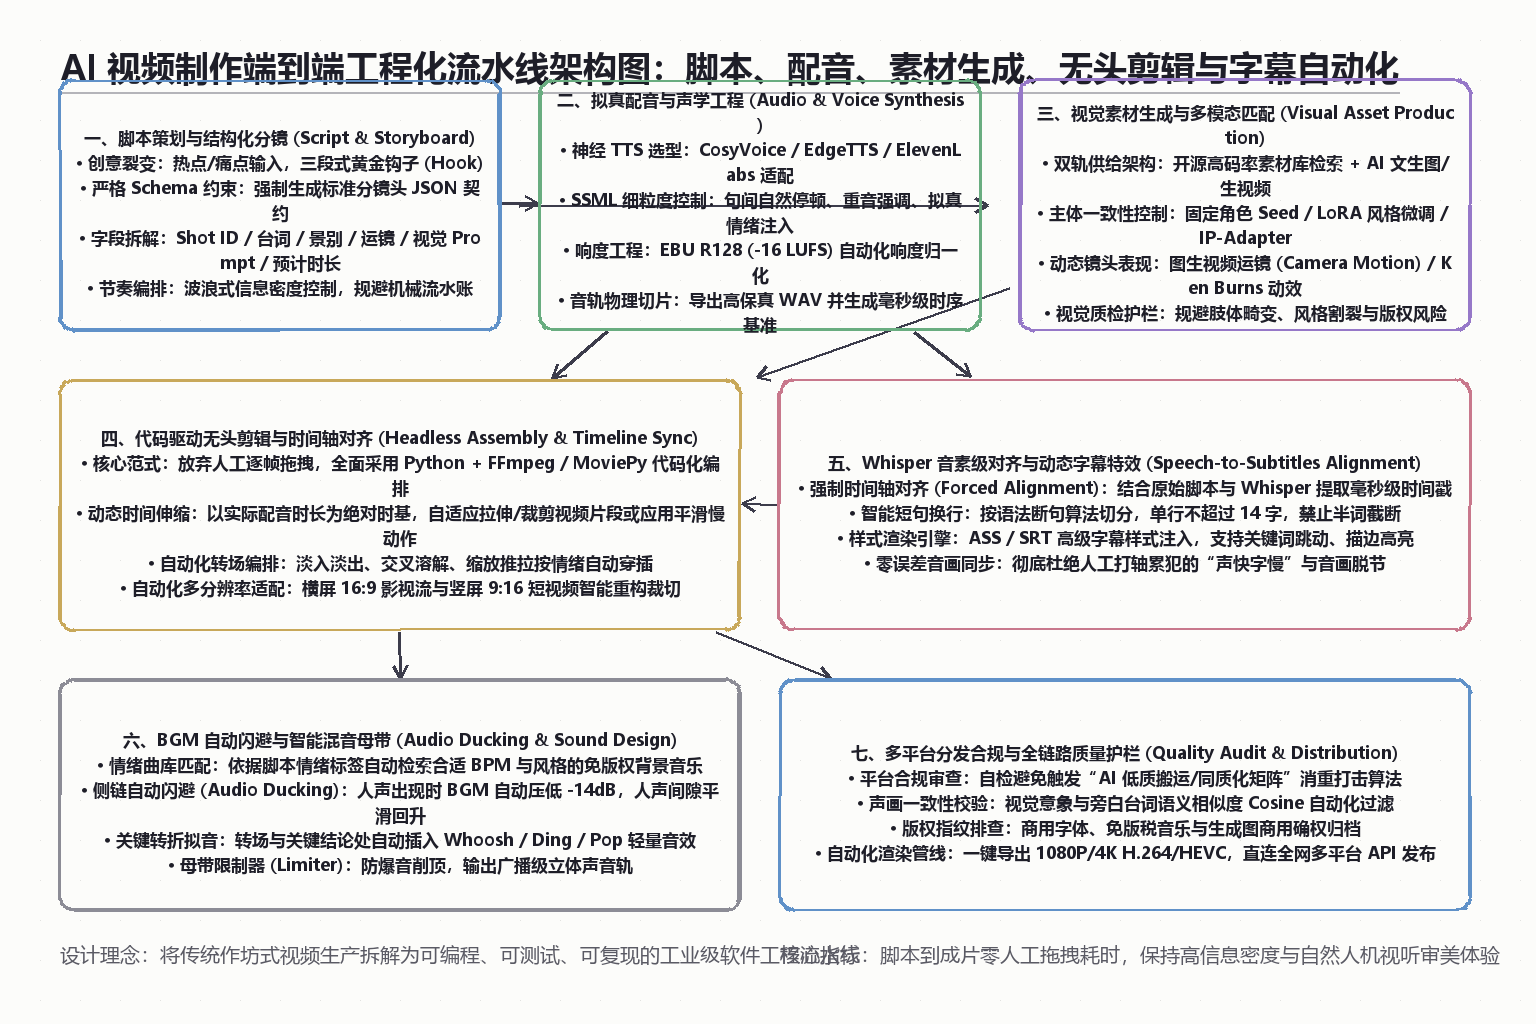
本文将为你深度拆解一套已被验证的端到端 AI 视频工程化流水线。我们将从结构化分镜头契约切入,贯穿高拟真配音声学工程、多模态画面智能匹配、代码驱动的无头剪辑(Headless Assembly)、音素级精准字幕强制对齐、以及动态侧链混音,并提供一套工业级 Python 全自动渲染实战代码与 15 项生产上线自检清单,帮助你真正构建起属于自己的高效视听生产工厂。
一、三代视频生产模式的演进与核心分歧
在动手编写自动化流水线之前,我们必须厘清不同生产模式在技术哲学上的本质差异。只有明确各技术路线的边界,才能在工程落地中做出合理的取舍。
| 评估维度 | 第一代:传统手工制作模式 | 第二代:SaaS 黑盒一键成片 | 第三代:模块化代码工程流水线 |
|---|---|---|---|
| 核心生产工具 | Premiere / Final Cut / 剪映 | 各类在线“一键文字转视频”平台 | Python + FFmpeg / MoviePy + 专用模型 API |
| 生产吞吐量 | 低(单人每日仅能产出 1~2 条) | 中等(受限于 Web 交互与排队队列) | 极高(无头并行渲染,每日可达数十至数百条) |
| 分镜与逻辑可控性 | 完全由人工经验把控,精细度高 | 极低(模型随机抽取素材,常现文不对题) | 极高(通过严格 JSON Schema 强约束每一镜头) |
| 画面与品牌一致性 | 高(依赖固定视觉规范与模板) | 极差(画风撕裂,插画与实拍混乱杂糅) | 极高(可通过统一 LoRA、固定种子与素材池锚定) |
| 时间轴同步精度 | 依赖人工打轴(通常精度在 100ms 内) | 粗粒度(常出现语音未落画面先切的错位) | 微秒/毫秒级(Whisper 强制对齐与音频驱动切片) |
| 混音与视听质感 | 依赖剪辑师手工调节关键帧电平 | 机械(BGM 音量恒定,经常盖过人声) | 专业级(根据人声包络自动执行 -14dB 侧链闪避) |
| 平台消重与防封能力 | 原生原创,基本无合规去重风险 | 极高风险(素材库高度公用,被判同质化) | 极优(支持动态素材重排、差异化运镜与画质微扰) |
| 边际生产成本 | 高昂(按专业人力工时递增) | 订阅制或按分钟计费,隐性成本高 | 极低(仅消耗底层 API Token 与本地/云端算力) |
从上表可以看出,第三代流水线的核心设计原则是:以严谨的软件工程思想替代感性的手工操作,以代码为纽带将各个领域的顶级模型(LLM、TTS、扩散模型、语音识别、音视频合成引擎)拼装成高聚合、低耦合的确定性自动化生产线。
二、端到端自动化架构全景设计:以音频为“第一时钟”
在音视频工程中,许多初学者最容易犯的架构设计错误,是试图以“画面时长”去强行迁就“文本台词”。例如,在脚本中预先规定“第一幕画面必须持续 5 秒,第二幕必须持续 4 秒”,然后要求配音模型在这段时间内念完旁白。
这种做法完全违背了自然人类语言的声学规律。强制缩放语音会导致严重的音调失真(变调)或语速畸变,让人瞬间感受到刺耳的机器假感。
核心铁律:音频是视频流水线的绝对时基(Audio as the Primary Clock)
在工业级视频生产流水线中,音频必须拥有绝对的决定权。整套架构的运转时序如下:
- 输入与脚本化:LLM 接收原始文本或主题,输出包含分镜头意图的强类型数据契约;
- 声学合成与时序固化:首先调用拟真 TTS 生成每一幕的分段音频文件,测量其精确到毫秒的物理时长(Duration);
- 视觉素材动态适应:根据配音生成的实际物理时长,反向决定画面片段的裁剪长度、循环模式、慢动作倍率或文生图平移推进(Ken Burns 动效)的时长;
- 音素级强制打轴:将固化的物理音频交由语音识别模型(如 Whisper)提取音素级和词级的时间戳,生成绝对精准的字幕文件;
- 视听渲染与侧链混音:将处理完毕的视频流、音频流、字幕图层与经过动态音量闪避(Audio Ducking)的背景音乐一次性合成输出。
三、模块一:剧本策划与结构化分镜契约(Script & Storyboard Schema)
很多团队尝试自动化时,直接让 ChatGPT 写一段“视频脚本”,然后把输出的纯文本直接传给下游模块。这种做法会导致严重的灾难:下游无法准确判断哪一句是画外音(旁白)、哪一句是画面提示、镜头应当展示多久。
在工程化流水线中,我们必须使用严苛的 JSON Schema / Pydantic 模型作为前置大模型的强类型输出契约。
1. 结构化分镜契约设计
以下是生产级视频流水线所采用的 Pydantic 数据规范:
from pydantic import BaseModel, Field
from typing import List, Optional
from enum import Enum

class ShotType(str, Enum):
    CLOSE_UP = "close_up"          # 特写
    MEDIUM_SHOT = "medium_shot"    # 中景
    WIDE_SHOT = "wide_shot"        # 全景
    OVERHEAD = "overhead"          # 俯视特写/桌面俯拍

class CameraMotion(str, Enum):
    STATIC = "static"              # 静止固定镜头
    ZOOM_IN = "zoom_in"            # 缓慢推进
    ZOOM_OUT = "zoom_out"          # 缓慢拉远
    PAN_LEFT = "pan_left"          # 向左水平摇镜
    PAN_RIGHT = "pan_right"        # 向右水平摇镜

class StoryboardShot(BaseModel):
    shot_id: int = Field(..., description="镜头序号,自递增")
    narration: str = Field(..., description="该镜头的画外音旁白,口语化,杜绝书面套话")
    visual_description: str = Field(..., description="中文画面内容描述,用于人工核验")
    visual_prompt_en: str = Field(..., description="用于文生图/生视频的英文高精度提示词")
    shot_type: ShotType = Field(default=ShotType.MEDIUM_SHOT, description="景别设定")
    camera_motion: CameraMotion = Field(default=CameraMotion.ZOOM_IN, description="镜头运镜方式")
    keyword_highlight: Optional[str] = Field(None, description="字幕中需要做醒目高亮的关键短语")
    sfx_cue: Optional[str] = Field(None, description="音效提示,如 whoosh, ding, pop, typing")

class CompleteVideoScript(BaseModel):
    video_title: str = Field(..., description="视频主标题")
    hook_sentence: str = Field(..., description="前3秒黄金钩子台词,用于吸睛")
    bgm_mood: str = Field(..., description="背景音乐情绪风格,如 energetic, tech, chill, dramatic")
    target_duration_seconds: int = Field(..., description="目标时长范围,如 180")
    shots: List[StoryboardShot] = Field(..., description="完整分镜头列表")
2. 防幻觉与节奏波浪线控制提示词模板
为了确保大模型输出的旁白具有“听觉舒适度”,我们在提示词工程中必须注入明确的语言学约束:
- 禁止使用书面连接词:严格剔除“显而易见”、“综上所述”、“总而言之”等高危书面套话;
- 控制单句音节长度:一个镜头内的旁白必须控制在 15 到 35 个汉字之间,切忌出现长达三行的无标点从句;
- 强化前 3 秒黄金钩子(The Hook):前 3 秒禁止出现无意义的开场白(如“大家好,今天我们来聊一聊…”),必须直击用户核心痛点或抛出反常识冲突。
四、模块二:商业级拟真配音与声学工程(Audio & Voice Synthesis)
声音是视频的“灵魂”。观众对低劣画质的容忍度往往远高于对糟糕音质的容忍度。带有明显失真、电流声或机械音调的配音,会立刻让视频被打上“廉价垃圾”的标签。
1. 现代神经语音(TTS)技术选型
| TTS 引擎技术流派 | 代表产品/开源项目 | 声音自然度 | 情感控制与表现力 | 部署与调用成本 | 推荐使用场景 |
|---|---|---|---|---|---|
| 云端商业多语种先锋 | ElevenLabs | 极高(细微呼吸与吞咽声极度逼真) | 极佳(支持细粒度情绪参数调节) | 商业计费,价格偏高 | 高客单价出海商业解说、影视级叙事 |
| 国产开源零样本文生语音 | CosyVoice / ChatTTS | 高(中文口语化极强,笑声/拟声词自然) | 优秀(支持上下文情绪理解) | 可私有化部署,GPU 算力成本 | 中文短视频、深度知识科普、垂直行业号 |
| 轻量级工业标准 API | Microsoft Edge-TTS / Azure | 中上(音色清晰标准,发音极其准确) | 良好(支持丰富 SSML 标记) | 极低(Edge-TTS 免凭据轻量调用) | 批量化资讯速递、教程演示、企业内部培训 |
2. SSML 细粒度控制与拟真人声参数注入
在调用 TTS 时,不要直接传一段纯文本,而应充分利用 SSML(Speech Synthesis Markup Language,语音合成标记语言) 来插入呼吸节拍与重音。例如:
<speak version="1.0" xmlns="http://www.w3.org/2001/10/synthesis" xml:lang="zh-CN">
    <voice name="zh-CN-YunxiNeural">
        <prosody rate="-3%" pitch="+0Hz">
            你有没有想过,<break time="250ms"/>
            为什么大部分人做的 AI 视频,<break time="150ms"/>
            <emphasis level="strong">一眼看上去就像廉价垃圾?</emphasis>
            <break time="400ms"/>
            核心原因不在于画面,而在于你丢失了最重要的“节奏感”。
        </prosody>
    </voice>
</speak>
3. 音频母带级预处理:EBU R128 响度标准化
不同分镜生成的音频切片,往往存在细微的音量波动。如果直接拼接,会导致观众在观看过程中忽大忽小,体验极差。
在工程流水线中,必须引入工业级 EBU R128 标准(或 ITU-R BS.1770),通过 Python 音频处理库(如 pydub 或 ffmpeg-normalize)将整体人声音轨统一规整至 -16 LUFS(数字流媒体视频的黄金响度标准),并限制真正峰值(True Peak)不超过 -1.0 dBFS,从源头上杜绝爆音削顶。
五、模块三:视觉素材智能供给与一致性控制(Visual Asset Production)
解决了分镜脚本与高品质音频后,流水线进入视觉生产阶段。视觉素材的供给通常采用“双轨制架构”:
1. 双轨素材供给策略
- 写实与纪实场景:高质量开源/商业视频库语义检索
- 针对常见的商业动作(如“办公室内讨论方案”、“电脑前敲击代码”、“城市延时车流”),使用真实拍摄的高清高码率实拍视频,其观感远胜当前生涩的 AI 视频。
- 流水线可通过调用开源免版税素材库(如 Pexels、Pixabay)的官方 API,使用大模型生成的英文检索词进行语义匹配,下载 1080P 或 4K MP4 视频切片。
- 具象化概念、抽象隐喻与特定 IP:AI 文生图 + 图生视频(Image-to-Video)
- 针对无法通过素材库获取的特殊构想(例如“发光的神经网络立方体”、“未来赛博朋克风格的自动化车间”),则通过文生图模型(如 Flux、Midjourney)生成超清静态画面,再通过图生视频模型(如 Runway Gen-3、Kling、Luma)注入细微物理运动。
2. 避免画面风格割裂的三大锚定法则
如果一个镜头是写实油画风,下一镜头突然变成扁平卡通,再下一镜头又变成 3D 渲染,视频的整体质感将瞬间坍塌。流水线中必须建立风格一致性锚定机制:
- Prompt 前缀锁死(Style Anchor):在生成每个镜头的提示词时,强制追加统一的风格签名(例如:
cinematic lighting, 35mm photograph, documentary style, muted neutral color palette, shot on Arri Alexa, 8k resolution); - 负向提示词硬约束(Negative Prompt Gatekeeper):常驻排除
cartoon, 3d render, oversaturated, deformed hands, distorted faces, duplicate limbs, blurry; - 固定参考图/种子(Seed Locking & IP-Adapter):若视频涉及固定人物或固定主角,必须固定 Seed,或利用 IP-Adapter 将角色的正脸特写作为全局参考特征注入扩散模型。
3. 静态图的动态化渲染:Ken Burns 动效的数学实现
在实际生产中,为了控制渲染成本与 API 延迟,大量镜头可以采用“超高分辨率静态插画 + 镜头平滑缩放/推拉(Ken Burns Effect)”的方案。这种手法在《国家地理》和高质量纪录片中被广泛采用,既能让观众聚焦画面细节,又能完全消除画面的呆板感。
通过 FFmpeg 的 zoompan 滤镜,我们可以通过几行代码将单张静态图片转化为生动的动态运镜片段:
# 将静态图转化为 5 秒的缓慢平滑推进(从 1.0 倍推进到 1.25 倍,中心点对齐)
ffmpeg -loop 1 -i input.png -vf "zoompan=z='min(zoom+0.0015,1.25)':d=125:x='iw/2-(iw/zoom/2)':y='ih/2-(ih/zoom/2)':s=1920x1080:fps=25" -c:v libx264 -t 5 -pix_fmt yuv420p output.mp4
六、模块四:代码驱动的无头剪辑与 Whisper 强制音素对齐
这是整套流水线最核心的工程枢纽。我们将彻底抛弃人工打开桌面软件拖拽剪辑的旧范式,全部基于 Python、Whisper 与 FFmpeg 进行“无头(Headless)自动化编排”。
1. Whisper 语音强制时间轴对齐(Forced Alignment)
传统剪辑中最繁琐的环节莫过于打轴。很多人尝试用基于字数估算时长的办法来生成字幕,结果必然是“语速稍快字还在、语速稍慢字早飞”。
我们通过本地轻量部署的 OpenAI Whisper(或更高效的 faster-whisper) 模型,对每个分镜生成的真实 WAV 配音进行强制转写。通过开启 word_timestamps=True,模型会返回每一个单字或词组精确到毫秒的起始与结束时间戳(Start / End Timestamps)。
from faster_whisper import WhisperModel

# 使用轻量级且极速的 base 或 small 模型即可胜任中英文对齐任务
whisper_model = WhisperModel("base", device="cpu", compute_type="int8")

def align_speech_to_srt(audio_path: str) -> list:
    """提取音频中带有高精度时间戳的字级别切片"""
    segments, _ = whisper_model.transcribe(
        audio_path,
        beam_size=5,
        word_timestamps=True,
        language="zh"
    )

    aligned_subtitles = []
    for segment in segments:
        for word in segment.words:
            aligned_subtitles.append({
                "word": word.word.strip(),
                "start": word.start,
                "end": word.end,
                "probability": word.probability
            })
    return aligned_subtitles
2. 智能短句折行与字幕视觉渲染
原生语音识别切出的单字往往过于碎片化,不能直接作为屏幕字幕展示。流水线必须包含字幕后处理分词器:
- 按照自然停顿与标点符号重组短句;
- 单行汉字长度严格控制在 8 到 14 个字 之间;
- 采用 ASS(Advanced SubStation Alpha) 格式进行排版,注入现代设计感:无衬线现代黑体、适当的底部边距、0.8 像素的高级柔和暗色阴影与细微半透明描边,确保在任何复杂背景画面下均清晰可读。
3. 背景音乐智能侧链闪避(Audio Ducking)算法
优秀视听作品与业余作品的另一道分水岭在于声场层次感。当旁白响起时,背景音乐必须自然下沉;当旁白出现停顿或思考间隙时,背景音乐必须适度回升,填充听觉空白。
在非线性剪辑软件中,这需要繁琐地打关键帧;而在代码流水线中,我们可以利用 FFmpeg 内置的 sidechaincompress(侧链压缩)音频滤镜一键实现全自动闪避:
# 将人声音轨作为侧链控制信号,自动压制背景音乐音量,并在人声结束后平滑回升
ffmpeg -i voiceover.wav -i bgm.mp3 -filter_complex \
"[1:a]asplit=2[bgm_full][bgm_ctrl]; \
 [bgm_full][0:a]sidechaincompress=threshold=0.08:ratio=5:attack=100:release=400[ducked_bgm]; \
 [0:a][ducked_bgm]amix=inputs=2:duration=first:dropout_transition=2[outa]" \
-map "[outa]" -c:a aac -b:a 192k mixed_audio.m4a- threshold=0.08:检测人声触发门限;
- ratio=5:压缩比率,将背景音乐压制约 -12dB 到 -16dB;
- attack=100 / release=400:起音 100ms,释音 400ms,带来极度平滑自然的声音过渡,完全杜绝突兀感。
七、完整 Python 端到端自动化合成流水线实战代码
为了让你能够直观掌握整套流水线的组装逻辑,下面给出一段结构完整、职责分明、可在本地或云端服务器上直接驱动的完整核心流水线示例代码:
# -*- coding: utf-8 -*-
"""
Production-Ready AI Video Assembly Pipeline
整合:结构化分镜解析、TTS 语音合成、时钟对齐、素材裁剪、字幕压制与动态混音
"""

import os
import json
import subprocess
from pathlib import Path
from typing import List, Dict

class VideoPipelineEngine:
    def __init__(self, workspace_dir: str):
        self.workspace = Path(workspace_dir)
        self.audio_dir = self.workspace / "audio"
        self.visual_dir = self.workspace / "visuals"
        self.output_dir = self.workspace / "output"

        # 确保工作目录就绪
        for p in [self.audio_dir, self.visual_dir, self.output_dir]:
            p.mkdir(parents=True, exist_ok=True)

    def synthesize_shot_voice(self, shot_id: int, text: str) -> Path:
        """调用 TTS 引擎合成单镜头音频,并输出物理 WAV 文件"""
        audio_file = self.audio_dir / f"shot_{shot_id:03d}.wav"

        # 生产环境中可替换为 CosyVoice、Azure 或 ElevenLabs API
        # 这里演示调用本地 edge-tts CLI 工具生成高品质中文人声
        cmd = [
            "edge-tts",
            "--voice", "zh-CN-YunxiNeural",
            "--text", text,
            "--write-media", str(audio_file)
        ]
        subprocess.run(cmd, check=True, stdout=subprocess.DEVNULL, stderr=subprocess.DEVNULL)
        return audio_file

    def get_audio_duration(self, audio_path: Path) -> float:
        """利用 ffprobe 提取音频的精确物理时长(秒)"""
        cmd = [
            "ffprobe", "-v", "error",
            "-show_entries", "format=duration",
            "-of", "default=noprint_wrappers=1:nokey=1",
            str(audio_path)
        ]
        result = subprocess.run(cmd, stdout=subprocess.PIPE, text=True, check=True)
        return float(result.stdout.strip())

    def prepare_video_clip(self, shot_id: int, target_duration: float, visual_source: Path) -> Path:
        """根据音频物理时长,自适应拉伸、裁剪或对静态图应用平滑推进运镜"""
        processed_clip = self.workspace / f"clip_{shot_id:03d}.mp4"

        # 如果素材是静态图片,应用高质量平滑推进运镜(Ken Burns 动效)
        if visual_source.suffix.lower() in [".png", ".jpg", ".jpeg"]:
            fps = 25
            total_frames = int(target_duration * fps)
            zoom_cmd = [
                "ffmpeg", "-y", "-loop", "1",
                "-i", str(visual_source),
                "-vf", (
                    f"zoompan=z='min(zoom+0.0012,1.20)':d={total_frames}:"
                    f"x='iw/2-(iw/zoom/2)':y='ih/2-(ih/zoom/2)':s=1920x1080:fps={fps},"
                    f"format=yuv420p"
                ),
                "-t", str(target_duration),
                "-c:v", "libx264",
                "-preset", "fast",
                str(processed_clip)
            ]
            subprocess.run(zoom_cmd, check=True, stdout=subprocess.DEVNULL, stderr=subprocess.DEVNULL)
        else:
            # 如果素材是原生视频,截取对应时长并统一规格为 1080P
            clip_cmd = [
                "ffmpeg", "-y",
                "-i", str(visual_source),
                "-t", str(target_duration),
                "-vf", "scale=1920:1080:force_original_aspect_ratio=increase,crop=1920:1080",
                "-c:v", "libx264",
                "-pix_fmt", "yuv420p",
                "-an",
                str(processed_clip)
            ]
            subprocess.run(clip_cmd, check=True, stdout=subprocess.DEVNULL, stderr=subprocess.DEVNULL)

        return processed_clip

    def build_video_concat_list(self, clip_paths: List[Path], audio_paths: List[Path]) -> Path:
        """将处理好的各片段封装为带有对齐音轨的复合中间文件"""
        concat_text_file = self.workspace / "concat_list.txt"
        with open(concat_text_file, "w", encoding="utf-8") as f:
            for clip in clip_paths:
                f.write(f"file '{clip.resolve().as_posix()}'\n")
        return concat_text_file

    def execute_pipeline(self, storyboard: List[Dict], bgm_path: Path, output_filename: str = "final.mp4") -> Path:
        """流水线总调度执行入口"""
        print(f"🎬 启动自动化视频流水线,共 {len(storyboard)} 个分镜头...")

        clips = []
        audios = []

        # 步骤 1:时钟驱动处理每一个镜头
        for shot in storyboard:
            shot_id = shot["shot_id"]
            narration = shot["narration"]
            visual_path = Path(shot["visual_path"])

            print(f"  🔊 处理镜头 [{shot_id}]: 合成配音与时间测量...")
            audio_file = self.synthesize_shot_voice(shot_id, narration)
            duration = self.get_audio_duration(audio_file)
            print(f"     -> 音频就绪,物理时长: {duration:.2f} 秒")

            print(f"  🎥 处理镜头 [{shot_id}]: 视效运镜与动态切片适配...")
            clip_file = self.prepare_video_clip(shot_id, duration, visual_path)

            clips.append(clip_file)
            audios.append(audio_file)

        # 步骤 2:合并基础视频流
        concat_list = self.build_video_concat_list(clips, audios)
        raw_video = self.workspace / "raw_concat.mp4"
        raw_audio = self.workspace / "raw_concat.wav"

        # 视频无缝拼接
        subprocess.run([
            "ffmpeg", "-y", "-f", "concat", "-safe", "0",
            "-i", str(concat_list),
            "-c", "copy",
            str(raw_video)
        ], check=True, stdout=subprocess.DEVNULL, stderr=subprocess.DEVNULL)

        # 音频无缝拼接
        audio_concat_list = self.workspace / "audio_concat.txt"
        with open(audio_concat_list, "w", encoding="utf-8") as f:
            for a in audios:
                f.write(f"file '{a.resolve().as_posix()}'\n")
        subprocess.run([
            "ffmpeg", "-y", "-f", "concat", "-safe", "0",
            "-i", str(audio_concat_list),
            "-c", "copy",
            str(raw_audio)
        ], check=True, stdout=subprocess.DEVNULL, stderr=subprocess.DEVNULL)

        # 步骤 3:最终混音与视音频总封装(含 BGM 侧链自动闪避)
        final_output = self.output_dir / output_filename
        print("🎛️ 正在执行侧链动态降噪混音与全轨道母带压制...")

        mix_cmd = [
            "ffmpeg", "-y",
            "-i", str(raw_video),
            "-i", str(raw_audio),
            "-i", str(bgm_path),
            "-filter_complex", (
                "[2:a]volume=0.3[bgm_base]; "
                "[bgm_base][1:a]sidechaincompress=threshold=0.08:ratio=4:attack=100:release=400[ducked_bgm]; "
                "[1:a][ducked_bgm]amix=inputs=2:duration=first:dropout_transition=2[final_audio]"
            ),
            "-map", "0:v",
            "-map", "[final_audio]",
            "-c:v", "copy",
            "-c:a", "aac",
            "-b:a", "192k",
            str(final_output)
        ]
        subprocess.run(mix_cmd, check=True, stdout=subprocess.DEVNULL, stderr=subprocess.DEVNULL)

        print(f"✅ 渲染完成!成片交付路径: {final_output.resolve()}")
        return final_output
八、5 大高频落地陷阱与深度避坑指南
许多团队在搭建自动化流水线时,虽然打通了基本的调用链路,但在实际推向市场或自媒体运营时,却屡屡踩雷。以下是基于海量实战总结出的 5 大高频反模式及对应的防御策略:
1. 陷阱一:音画严重割裂与“PPT 式机械轮播”
- 典型症状:旁白在严谨讲述“技术架构中的死锁问题”,屏幕上却持续展示着两只卡通小狗在草地上追逐奔跑;或者一张毫无动感的静态截图硬生生停留了 8 秒,画面如同一潭死水。
- 根因分析:分镜头提示词未经过语义校验,或直接使用了无上下文的随机库存素材。
- 防御策略:
- 引入声画语义相关度质检网关:利用 CLIP 或轻量多模态小模型,对视频关键帧与该镜头的台词进行 Cosine 文本-图像相似度计算,低于阈值直接阻断并重试生成;
- 强制实行“3 秒法则”:任何镜头在画面中停留的时间原则上不超过 4 秒;若单句台词过长(超过 5 秒),必须在流水线中自动执行“单句双镜头裁切”,通过景别切换(如从中景切为特写)保持视觉刺激。
2. 陷阱二:触发各大平台“AI 矩阵号与同质化低质”消重惩罚
- 典型症状:新发布的视频连续多篇播放量卡在 0 到 100 左右,进入所谓“流量黑洞”,后台甚至收到“视频缺乏原创价值”或“搬运低质内容”的系统警告。
- 根因分析:直接套用了公共成片工具的默认音色(例如常见的几款被过度滥用的人气音色)、使用了被成千上万个账号重复使用的公共模板片头片尾、且视频参数(帧率、编码指纹)完全一致。
- 防御策略:
- 构建私有化特色音色库:借助 CosyVoice 或商业克隆技术,使用专属授权的人声微调模型,彻底规避公用音色池的声纹指纹命中;
- 画面注入动态微扰:在 FFmpeg 压制流水线中,注入轻微的色调微调滤镜(
eq=contrast=1.02:brightness=0.01)与自适应微粒子噪点,重塑视频像素哈希(MD5 / SSIM 指纹); - 个性化动效字库:严禁使用剪映默认的几种爆款花字模板,统一采用定制字号、品牌专属色值与非标转场动画。
3. 陷阱三:配音换气声丢失与单调语调引发的高跳出率
- 典型症状:配音虽然口齿清晰、毫无杂音,但听上去如同无休止的“机关枪扫射”,没有人类自然的换气、微小吞咽声和情绪重音,听众在大脑认知层迅速产生听觉疲劳。
- 根因分析:直接向 TTS 接口发送大段纯文本,未配置断句停顿与重音标定。
- 防御策略:
- 在进入 TTS 之前,通过正则与 AST 语法树算法,在每一个顿号、逗号、句号后自动根据语义插入
150ms ~ 350ms的 SSML 停顿标记; - 在疑问句和感叹句处,通过 SSML 的
pitch(音调)与contour(音高轮廓)参数,将句尾音高提升 5%~10%,模拟真实的语调上扬。
- 在进入 TTS 之前,通过正则与 AST 语法树算法,在每一个顿号、逗号、句号后自动根据语义插入
4. 陷阱四:字体与背景音乐未授权带来的商业版权雷区
- 典型症状:视频获得爆发式播放或用于企业商业推广后,迅速收到字体厂商或音乐版权公司的律师函,面临巨额索赔或视频被全网下架。
- 根因分析:开发流水线时为图省事,直接从宿主操作系统或网络随意抓取中文字体与热门流行 BGM 打包到程序中。
- 防御策略:
- 代码库字体白名单制度:在容器或流水线服务器中,只允许安装明确支持商用免费的开源字体(如阿里巴巴普惠体、思源黑体、霞鹜文楷等),并在代码中以绝对路径硬编码指定;
- 免版税商业曲库归档:建立专属的本地方案曲库(如购买商用许可的 AudioJungle、Bifrost 或从 YouTube Audio Library、Free Music Archive 筛选的可商用音频),在流水线元数据中严格记录每一首 BGM 的许可证编号。
5. 陷阱五:高并发批量渲染时的内存与显存泄漏崩塌
- 典型症状:在本地或单台云服务器上连续运行流水线,前 3 条视频渲染正常,到了第 4 条突然报错
CUDA out of memory或系统直接杀进程(OOM Killer)。 - 根因分析:MoviePy、OpenCV 或扩散模型在 Python 循环中频繁加载模型和缓存对象,垃圾回收机制未能及时释放未托管的 C/C++ 底层内存指针与显存。
- 防御策略:
- 进程隔离执行(Subprocess Isolation):不要在同一个长期运行的 Python 常驻进程内通过全局对象反复调用视频剪辑库,而是将单个镜头的渲染任务封装为独立的独立子进程;
- 显式销毁与无头释放:每次镜头渲染完毕后,显式调用
clip.close(),并在关键节点执行torch.cuda.empty_cache()和gc.collect(); - 全链路临时文件自动清理:在流水线最外层包裹
try...finally上下文管理器,成片导出并核验通过后,自动清理中间生成的上百个.wav、.png和临时切片.mp4,防止磁盘瞬间被撑爆。
九、生产级 15 项 AI 视频自动化上线自检清单
在将自动化视频生产系统正式推向生产环境、或将批量产出的视频投放到各大流媒体平台之前,请务必逐项核对以下 15 项工程化准入标准:
阶段一:脚本与分镜合规审查(1~4)
- 1. 强类型契约解析正常:大模型输出的内容 100% 能够被 Pydantic 模型严格解析,无字段缺失或数据类型异常;
- 2. 黄金 3 秒钩子(Hook)达标:前 3 秒旁白不存在“大家好”、“今天给大家分享”等低效废话,直奔核心主题;
- 3. 单镜头字数与节奏受控:每个镜头的旁白字数严格落在 15 至 35 个汉字之间,无超长复合从句;
- 4. 事实与数据审慎核验:涉及具体价格、年份、参数结论的内容经过确定性检索比对,未出现模型幻觉生成的虚假事实;
阶段二:声学与配音质量审查(5~8)
- 5. 全局响度标准化达标:整条人声音轨经过 EBU R128 标准化处理,综合集成响度稳定在 -16 LUFS (±1.0 LUFS),True Peak < -1.0 dBFS;
- 6. 听觉节奏与停顿自然:关键从句之间包含 150ms~350ms 的自然停顿,未出现连珠炮式的机械违和感;
- 7. 爆音削顶与底噪排查:音轨开头与结尾包含 50ms 极短微渐强/微渐弱(Fade-in/Fade-out),杜绝由于切片截断引起的“咔哒”爆音;
- 8. 侧链混音动态闪避生效:当人声出现时,BGM 音量被平滑压低 -12dB 至 -16dB;人声停止后 400ms 内平滑恢复,人声清晰透亮;
阶段三:视觉与无头剪辑对齐审查(9~12)
- 9. 音画时序绝对对齐:视频镜头的物理切换点严格与对应分镜的音频停顿点重合,杜绝“话未说完画面先切”的低级失误;
- 10. 视觉风格全篇高度统一:所有镜头的色调、画风、颗粒度保持同频,未出现实拍与不同风格插画杂糅的撕裂感;
- 11. 动态平移与运镜无卡顿:静态图生成的 Ken Burns 动效帧率恒定在 25fps 或 30fps,位移过程平滑柔和,无跳帧抖动;
- 12. 视像畸变与肢体残缺过滤:AI 生成的画面经过多模态过滤网关,无明显畸变手指、融化物面与逻辑荒谬的多余肢体;
阶段四:字幕排版与商业版权合规审查(13~15)
- 13. 字幕强制对齐零误差:Whisper 音素级打轴准确,字幕出现与发音完全同步,且单行字幕字数未突破 14 字,无跨行半词截断;
- 14. 字体与音频资产 100% 商用合规:视频中使用的所有字体文件、音效(SFX)和背景音乐(BGM)均拥有清晰完整的商用版权授权证明;
- 15. 多端分辨率与安全区适配:视频在目标平台(横屏 16:9 或竖屏 9:16)的上下两侧重要视听元素均避开了平台 UI 遮挡安全区(如点赞栏、标题简介栏)。
结语与架构演进展望
AI 视频制作绝不是简单的“拼装玩具”,它的本质是一场视听内容工业化革命。通过将传统剪辑师大脑中的感性经验转化为具象的数学公式、Schema 契约与代码编排,我们不仅能够将内容生产的边际成本压至极低,更能以软件工程的敏捷迭代速度,持续优化视频的完播率与转化率。
随着端到端多模态大模型与物理世界视频生成底座的进一步成熟,未来的视频流水线还将进一步进化为“实时感知、自适应生成、全自动 A/B 测试反馈”的自主进化闭环。如果你在搭建属于自己的企业级视听自动化流水线、多平台分发矩阵、或进行私有化音视频模型微调与部署过程中遇到任何架构疑问与工程挑战,欢迎随时通过 联系我们 页面与我们的技术工程团队取得联系,共同探讨多媒体自动化工程的无限可能。