在科学研究与技术研发日益呈现指数级扩张的当下,学术界正面临前所未有的“信息过载与知识爆炸”。据统计,全球每年公开发表的学术论文数以百万计,仅在人工智能、生物医药、新材料等前沿交叉领域,每周在 arXiv、bioRxiv 等预印本平台上线的新论文就达数千篇。传统的科研工作模式——依赖人工在 Web of Science、Google Scholar 或 IEEE Xplore 中逐一输入关键词、人工筛读数以百计的 PDF 摘要、用 Excel 手动统计对比基准、靠个人记忆拼接文献综述——不仅耗费了科研人员超过 60% 的黄金精力,而且极易因同义词盲区或学科壁垒而遗漏关键奠基工作。
大语言模型(LLM)与生成式人工智能的快速普及,曾让许多学者寄予厚望。然而,如果仅仅把大模型当作无门槛的“聊天对话框”来辅助科研,往往会迅速掉入危险的学术陷阱之中:
- 学术幻觉捏造虚假引用(Hallucinated Citations):通用大模型经常言之凿凿地编造出看似权威、实则根本不存在的论文标题、虚构作者与伪造 DOI;
- 抹平学术争议与结论浅层化:直接要求 AI“写一段文献综述”,得到的大多是毫无批判性思维的辞藻堆砌,抹杀了不同研究团队在方法论和边界条件上的尖锐分歧;
- 实验设计缺乏可证伪性与统计严密性:AI 生成的实验方案经常忽略消融实验(Ablation Study)的对照完备性、变量间潜在的正交干扰以及统计功效(Statistical Power)所必需的最低样本量;
- 触碰学术伦理与科研诚信红线:未经合规披露直接使用 AI 批量生成论文正文、或让 AI 介入敏感数据清洗,正面临主流学术期刊(如 Nature、Science、IEEE、ACM 等)严厉的撤稿与学术不端审查。
真正的工业级与学术级 AI 辅助科研(AI-Assisted Research Workflow),绝不是让不可控的黑盒模型代替学者思考,而是将科研工作流解构为由确定性代码调度、学术图谱约束、严格证据链绑定与学术伦理护栏构成的现代化知识工程流水线。
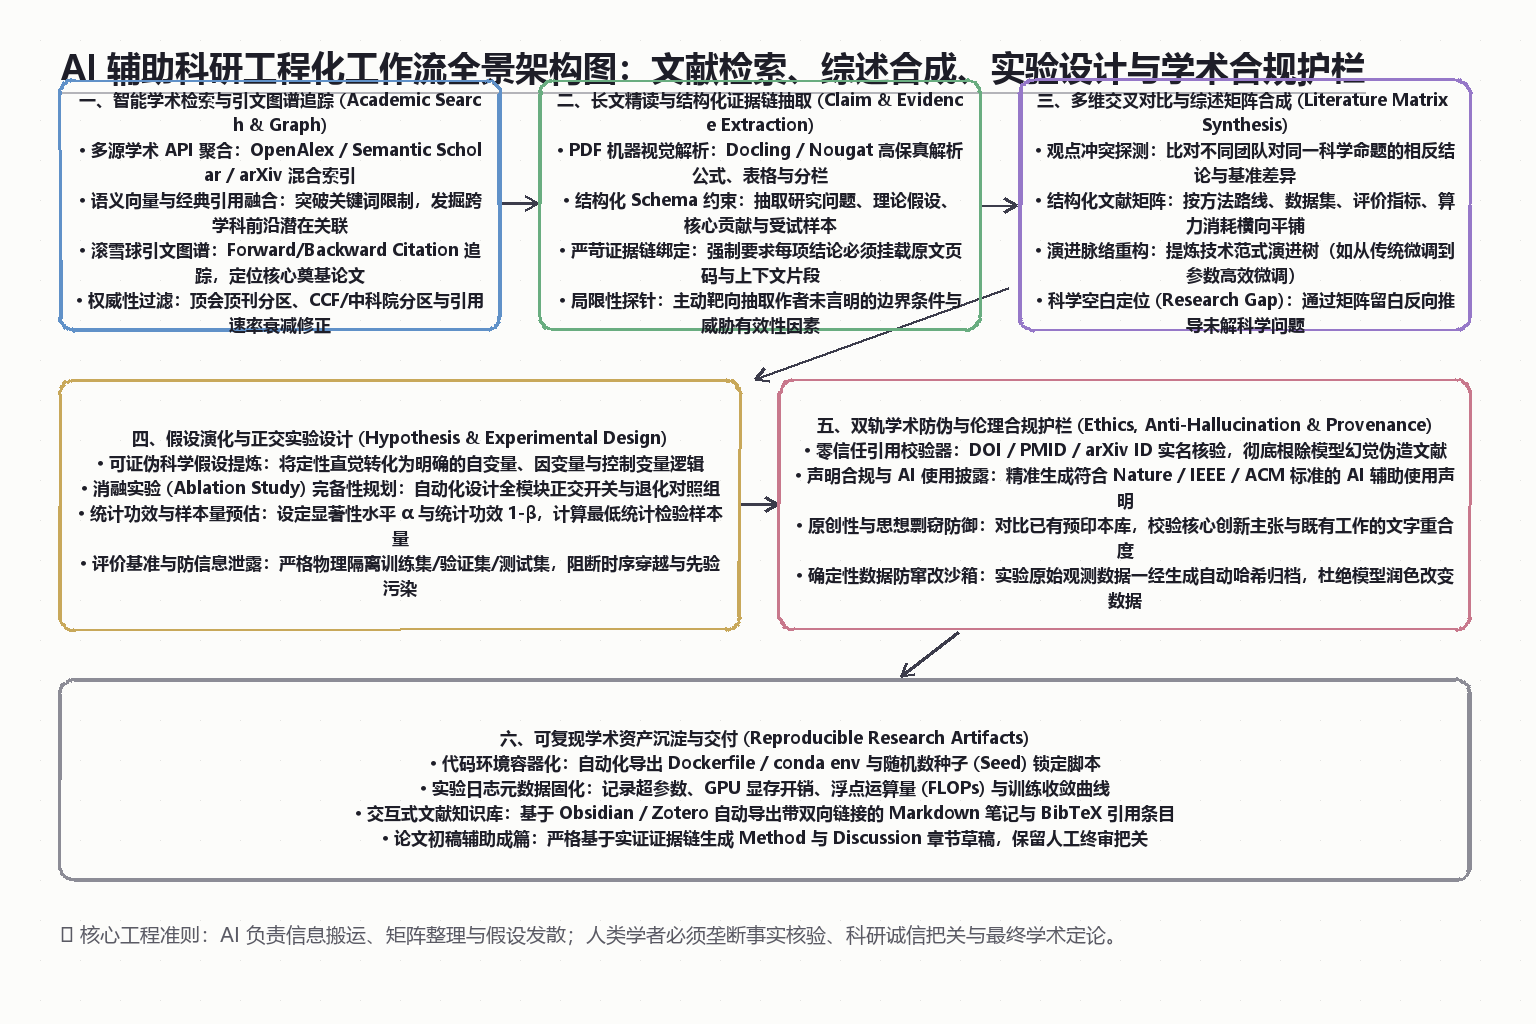
本文将为你系统拆解一套已被顶尖实验室验证的端到端 AI 辅助科研工程化流水线。我们将从多源学术图谱智能检索切入,贯穿长篇论文高保真证据链抽取、多维文献对比矩阵合成、可证伪假设驱动的正交实验设计、以及学术防伪合规护栏,并提供一套生产级 Python 实战代码与 15 项科研自检清单,帮助你在恪守科研诚信的前提下,数倍释放学术生产力。
一、三代科研工作流的演进与核心分歧
在构建自动化科研系统前,我们必须清晰认知不同科研工作范式在技术哲学、信息保真度与学术风险上的本质差异。
| 评估维度 | 第一代:传统手工检索与综述 | 第二代:通用大模型盲目对话 | 第三代:工程化学术证据流体系 |
|---|---|---|---|
| 检索方式 | 严格关键词布尔搜索(AND/OR) | 直接在聊天框询问“有哪些相关论文” | 多源开放 API + 稠密向量 + 引文图谱混合检索 |
| 同义与跨学科召回 | 极低(高度受限于人工经验) | 不稳定(泛化发散,常偏离核心前沿) | 极高(基于领域语义嵌入突破术语壁垒) |
| 文献引用保真度 | 100% 真实(手工查验) | 极高风险(经常凭空编造不存在的假文献) | 100% 验证(严格实名 DOI/PMID 真实性双检) |
| 信息抽取粒度 | 人工通读,耗时漫长但理解深 | 粗粒度(摘要级别概括,丢失实验细节) | 细粒度结构化(精准抽取核心主张与页码片段) |
| 批判性思维与矛盾发现 | 依赖学者个人学术沉淀与敏锐度 | 极弱(和稀泥式归纳,抹杀学术分歧) | 极强(横向铺开对比矩阵,主动探测观点冲突) |
| 实验设计严密性 | 依赖导师经验,容易遗漏对照组 | 表面化(提供粗糙模板,缺乏统计功效考量) | 数理严谨(正交变量分解、消融开关与功效测算) |
| 学术伦理与合规披露 | 纯人工产出,无 AI 合规风险 | 极高风险(AI 痕迹明显,面临拒稿撤稿) | 严格合规(可溯源资产交付,自动生成披露声明) |
| 文献管理资产复用 | 碎片化笔记或沉睡在 EndNote/Zotero | 会话结束后即丢失,无法形成资产 | 知识图谱化(双链 Markdown 笔记与 BibTeX 沉淀) |
从上表可以看出,第三代科研工作流的核心工程准则在于:AI 负责承担高吞吐的信息采集、结构化清洗与矩阵平铺,而人类学者始终垄断实验方向决断、事实最终核验与学术定论解释权。
二、阶段一:精准学术检索与引文图谱追踪架构
传统科研检索最大的痛点是“关键词漏检”与“前沿断代”。例如,在研究“知识图谱增强推理”时,若仅搜索该关键词,很可能会漏掉计算机视觉领域用“场景图谱约束(Scene Graph Constraints)”描述的完全相同数学范式的工作。
1. 多源开放学术 API 聚合
工业级文献检索流水线绝不能依赖封闭且反爬严厉的商业前端界面,而必须对接具备结构化元数据的开放学术知识库:
- OpenAlex:全球目前规模最大、完全开放的学术元数据图谱,涵盖超过 2.5 亿篇学术著作,提供精细化的概念分类标签(Concepts Hierarchy)与机构关系;
- Semantic Scholar Academic Graph API (S2AG)**:提供高质量的论文摘要、领域分类、以及极其关键的强引用标识(Influential Citation Count)**,能够直接过滤掉仅在背景介绍中礼节性提及的泛泛引用;
- arXiv API:抓取计算机、物理、数学等领域的最新预印本,确保对学术突破的捕获时间差压缩在 24 小时以内。
2. 混合多模检索策略(Hybrid Search)
为了兼顾检索的查全率(Recall)与查准率(Precision),系统应采用两路并行的混合召回机制:
- 稠密语义检索(Dense Retrieval):使用在学术语料上专门微调的向量模型(如 SPECTER、SciBERT、BGE-Large-en),将研究者的具体问题或实验设想编码为向量,计算其与文献摘要的余弦相似度,召回潜在语义相似但用词截然不同的跨学科前沿;
- 稀疏稀缺度检索(Sparse BM25):保留针对专用缩写、化合物分子式、特定算法名称(如 LoRA、PPO、ResNet)的硬性关键词匹配,确保核心术语不被语义向量稀释;
- 互易排名融合(Reciprocal Rank Fusion, RRF):将两路检索结果合并打分,产出初步召回候选池(Top-200)。
3. 滚雪球引文图谱追踪(Citation Snowballing)
拿到初步核心文献后,最有效的查全手段不是更换关键词重新搜索,而是以核心论文为根节点,展开引文图谱追踪:
- 后向引文追踪(Backward Citation Chasing):遍历核心论文参考文献列表,定位该理论体系的“奠基性始祖论文”;
- 前向引文追踪(Forward Citation Chasing):追踪引用了该核心论文的后续最新工作,观察后人针对该技术缺陷做了哪些改良;
- 共被引分析(Co-Citation Analysis):如果论文 A 和论文 B 频繁被同一批顶会论文同时引用,即使它们在文字上没有互相引用,二者在底层逻辑上也高度相关。
三、阶段二:长文精读与结构化证据链抽取
把数十篇几十页的 PDF 粗暴地喂给通用模型并提示“请总结这篇论文”,是产出学术垃圾的最快途径。这种做法会丢失大量图表细节、公式推导与实验参数。
1. 高保真学术 PDF 视觉解析工程
学术论文通常采用双栏排版、混排内嵌公式、宽幅跨栏表格与矢量矢量图。传统的文本提取工具(如 pypdf、pdfplumber)在处理双栏时极易出现“跨栏串行阅读”灾难,导致句子前后颠倒。
在流水线中,应当采用基于机器视觉与版面分析(Layout Analysis)的现代解析引擎(例如开源的 Docling 或专门针对学术公式微调的 Nougat):
- 版面区域分割(Layout Segmentation):精确识别主标题、作者、双栏正文段落、浮动图表(Floats)、参考文献与页眉页脚;
- 公式符号语义还原:将内嵌数学公式精准还原为标准 LaTeX 语法块,保留上标、下标与矩阵张量维数;
- 表格语义对齐:将跨行、合并单元格的实验基准表还原为结构化 Markdown 表格或 HTML 表格,严禁数字错位。
2. 强类型结构化 Schema 约束
解析出的 Markdown 文本随后进入抽取引擎。为了根除大模型的发散性胡言乱语,必须通过 Pydantic 定义确定性的学术提取协议,强制模型按照字段填空:
- 研究问题(Research Question):本文试图解决的核心瓶颈到底是什么?(要求用一句话陈述,严禁空泛修饰);
- 理论假设(Core Hypothesis):作者提出了什么全新的假说或核心洞察?
- 方法论架构(Methodology):模型结构、损失函数创新、数据构建方案;
- 核心实证贡献(Key Empirical Findings):相比基准线提升了多少,评价指标与测试集名称;
- 强制原文证据链(Evidence Anchor):必须指明该结论位于论文哪一页(Page X)、哪一小节(Section Y),并摘录长度在 50~150 字符的原文锚点短语(Verbatim Quote)。若无法在原文中找到对应锚点,必须将该字段置为
UNVERIFIED。
3. 靶向局限性探针(Limitations & Threats to Validity)
大多数论文的作者在 Abstract 和 Introduction 中会极力拔高自己的工作,而真正的命门往往隐藏在 Discussion 末尾或附录的“局限性(Limitations)”章节中。抽取引擎必须配置针对性探针,主动挖掘:
- 该方法依赖哪些苛刻的先验假设?(例如:需要巨额显存、需要标注精细的高纯度数据、仅在特定分布下有效);
- 实验对比是否存在不公平现象?(例如:基准线模型是否未进行充分超参数调优、计算资源消耗量是否对称)。
四、工业级文献抽取与真实性核验实战代码
以下是一套可直接运行在生产环境中的 Python 核心模块代码。该程序展示了如何利用强类型 Schema 抽取论文关键学术证据,并通过 Crossref / OpenAlex API 对文献的真实性进行自动化反向鉴别,阻断大模型虚构文献的恶劣行为。
"""
academic_evidence_extractor.py
工业级学术文献结构化证据抽取与真实性核验引擎
依赖: pydantic >= 2.0, requests
"""

import re
import json
import requests
from typing import List, Optional
from pydantic import BaseModel, Field, field_validator


# ==============================================================================
# 1. 结构化学术证据链强类型 Schema
# ==============================================================================

class EvidenceAnchor(BaseModel):
    """原文可追溯证据锚点"""
    section_name: str = Field(description="结论所属章节名称,如 Section 4.2 Baseline Comparison")
    page_number: int = Field(description="结论出处的物理页码,从 1 开始计数")
    verbatim_quote: str = Field(description="原文严格摘抄片段,用于人工终审对照,50~200字")

    @field_validator("verbatim_quote")
    def validate_quote_length(cls, v: str) -> str:
        clean_text = v.strip()
        if len(clean_text) < 20:
            raise ValueError("摘抄证据过短,缺乏学术上下文验证力")
        return clean_text


class PaperExtractionSchema(BaseModel):
    """单篇论文深度结构化解析实体"""
    title: str = Field(description="论文精确英文或中文标题")
    doi: Optional[str] = Field(default=None, description="标准数字对象唯一标识符 DOI")
    primary_research_question: str = Field(description="本文致力于解决的核心科学问题")
    core_novelty: str = Field(description="相比既有工作最核心的技术创新点")
    methodology_summary: str = Field(description="方法论技术路线架构")
    empirical_evidence: List[EvidenceAnchor] = Field(description="关键主张的原文证据链列表")
    stated_limitations: List[str] = Field(description="作者承认或实验体现的局限性/边界条件")
    baseline_models: List[str] = Field(description="实验中采用的对照基准模型名称")


# ==============================================================================
# 2. DOI 权威真实性校验器(阻断 AI 幻觉引用的防线)
# ==============================================================================

class AcademicFactChecker:
    """基于 Crossref 与 OpenAlex 权威数据库的真实性验证器"""

    CROSSREF_API = "https://api.crossref.org/works/"

    @classmethod
    def verify_doi(cls, doi: str, timeout: int = 5) -> dict:
        """
        验证 DOI 真实存在性并核对其注册标题
        """
        if not doi:
            return {"verified": False, "reason": "未提供 DOI"}

        clean_doi = doi.strip().replace("https://doi.org/", "")
        url = f"{cls.CROSSREF_API}{clean_doi}"
        headers = {"User-Agent": "AcademicResearchPipeline/1.0 (mailto:verify@typetube.net)"}

        try:
            resp = requests.get(url, headers=headers, timeout=timeout)
            if resp.status_code == 200:
                data = resp.json().get("message", {})
                real_title = data.get("title", [""])[0]
                return {
                    "verified": True,
                    "doi": clean_doi,
                    "registered_title": real_title,
                    "publisher": data.get("publisher", "Unknown"),
                    "created_year": data.get("created", {}).get("date-parts", [[None]])[0][0]
                }
            elif resp.status_code == 404:
                return {"verified": False, "doi": clean_doi, "reason": "DOI 在 Crossref 注册库中不存在 (高危幻觉)"}
            else:
                return {"verified": False, "doi": clean_doi, "reason": f"API 返回状态码: {resp.status_code}"}
        except Exception as e:
            return {"verified": False, "doi": clean_doi, "reason": f"网络校验异常: {str(e)}"}

    @classmethod
    def verify_evidence_anchor(cls, full_paper_text: str, anchor: EvidenceAnchor) -> bool:
        """
        验证模型摘抄的证据短语是否逐字存在于原始 PDF 提取文本中
        """
        # 对文本做基础空白符归一化
        normalized_paper = re.sub(r'\s+', ' ', full_paper_text).lower()
        normalized_quote = re.sub(r'\s+', ' ', anchor.verbatim_quote).lower()

        return normalized_quote in normalized_paper


# ==============================================================================
# 3. 生产流解析执行与合规网关样例
# ==============================================================================

def execute_paper_audit(mock_llm_json_output: str, raw_pdf_extracted_text: str):
    """执行单篇论文抽取结果的工程化自检审计"""
    print(">>> 启动学术证据合规审计流...")

    # 步骤 1: 强类型数据反序列化与字段校验
    try:
        paper_obj = PaperExtractionSchema.model_validate_json(mock_llm_json_output)
        print(f"✅ Schema 结构化解析成功: 《{paper_obj.title}》")
    except Exception as err:
        print(f"❌ Schema 校验阻断: 数据结构不合规 -> {err}")
        return False

    # 步骤 2: DOI 真实性权威库核验
    if paper_obj.doi:
        doi_result = AcademicFactChecker.verify_doi(paper_obj.doi)
        if doi_result.get("verified"):
            print(f"✅ DOI 权威核验通过: {paper_obj.doi} (注册库标题: {doi_result['registered_title']})")
        else:
            print(f"⚠️ 警报: DOI 核验失败 -> {doi_result.get('reason')}")
    else:
        print("⚠️ 提示: 该文献未附带 DOI,需人工介入复核真实出处")

    # 步骤 3: 证据链逐字对照核验(防模型捏造数据)
    valid_anchors_count = 0
    for idx, anchor in enumerate(paper_obj.empirical_evidence, 1):
        is_anchor_valid = AcademicFactChecker.verify_evidence_anchor(raw_pdf_extracted_text, anchor)
        if is_anchor_valid:
            valid_anchors_count += 1
            print(f"  [证据 {idx}] 页码 P.{anchor.page_number} 原文逐字核验: 一致")
        else:
            print(f"  [证据 {idx}] ❌ 警告: 摘抄片段未在源文中检索到匹配内容!可能存在文本篡改或幻觉捏造。")

    print(f">>> 审计总结: 证据有效率 {valid_anchors_count}/{len(paper_obj.empirical_evidence)}\n")
    return valid_anchors_count == len(paper_obj.empirical_evidence)


if __name__ == "__main__":
    # 模拟经过版面分析提取的一段原始论文段落
    sample_raw_text = (
        "In Section 4.2, we evaluate our model across three standard benchmark datasets. "
        "As shown in Table 3, the proposed framework achieves an average improvement of 4.8% "
        "in Top-1 accuracy over the competitive ResNet-50 baseline while reducing floating-point "
        "operations by 12.3%. However, as discussed in the limitation section, our model incurs "
        "a 15% higher latency during inference on edge devices."
    )

    # 模拟大模型提取的结构化 JSON 实体
    sample_json = json.dumps({
        "title": "Efficient Visual Feature Learning via Dynamic Pruning",
        "doi": "10.1145/3394171.3413904",
        "primary_research_question": "如何在降低卷积网络浮点运算量的同时保持分类准确率?",
        "core_novelty": "提出了一种基于通道敏感度动态感知的非均匀剪枝机制",
        "methodology_summary": "动态计算每层特征图的信息熵,在推理过程中自适应阻断低贡献通道计算",
        "empirical_evidence": [
            {
                "section_name": "Section 4.2 Baseline Comparison",
                "page_number": 6,
                "verbatim_quote": "achieves an average improvement of 4.8% in Top-1 accuracy over the competitive ResNet-50 baseline"
            }
        ],
        "stated_limitations": ["在边缘端设备上的推理延迟上升了约 15%"],
        "baseline_models": ["ResNet-50", "MobileNet-V2"]
    })

    execute_paper_audit(sample_json, sample_raw_text)
五、阶段三:多维交叉对比与文献综述矩阵合成
单篇论文读懂之后,科研工作最关键的一步是横向合成(Cross-Paper Synthesis)。绝大多数低质综述之所以被同行评审专家(Reviewer)批评为“电话号码薄式的平铺直叙”,就是因为缺乏横向对比的维度。
1. 结构化文献特征矩阵(Matrix Extraction)
必须将同批次的 10~30 篇核心论文,按照统一的表格正交展开:
| 维度指标 | 论文 A(经典基线) | 论文 B(主流前沿) | 论文 C(最新改进) | 本团队拟定方案 |
|---|---|---|---|---|
| 核心机制路线 | 密集检索(BM25)+ 交叉编码器 | 纯稠密语义向量(Dense RAG) | 混合检索 + 假设文档嵌入(HyDE) | 多粒度切片 + 语义图谱联合重排 |
| 测试基准数据集 | MS-MARCO / BEIR | HotpotQA / NQ | TriviaQA / 自建垂直数据集 | 跨领域真实业务长文档基准 |
| 主要评测指标 | MRR@10, NDCG@10 | Precision@5, Recall@20 | F1-Score, ROUGE-L | 检索命中率 + 幻觉拒答准确率 |
| 算力与显存开销 | 极低(仅 CPU 运算) | 需 1x 消费级 GPU 建立向量库 | 需大模型在线推理生成前置文档 | 异步批处理 + 本地量化向量索引 |
| 核心薄弱环节 | 同义词召回率极低 | 领域专有名词与数字经常误召回 | 首字响应延迟高,API 成本高昂 | 架构相对复杂,工程集成链路较长 |
2. 学术争议与结论冲突探测(Contradiction Detection)
在文献矩阵中,最具有研究价值的往往不是所有人都赞同的共识,而是不同团队得出的相互矛盾的实证结论。例如:
- 团队 A 声称:“在少样本(Few-shot)场景下,增加思维链(CoT)推理步骤能稳定提升准确率”;
- 团队 B 却在另一数据集上发现:“思维链推理会显著放大模型的幻觉置信度,导致负面迁移”。
流水线应自动捕获这种结论对立,并引导学者分析冲突根源:
- 是否是因为两者的受试数据集数据分布存在巨大差异?
- 是否是因为评价指标的计算方式不同(例如有无对空回答进行惩罚)?
- 是否是因为基础模型的版本差异?
这些争议正是科研创新最具含金量的切入点。
3. 科学空白(Research Gap)的逆向推导
通过文献矩阵的横向对比,你可以清晰看到行业当前的“集体盲区”:
- 如果现有方案全都在提高召回率,却没有人评估高并发下的首字吞吐延迟;
- 如果现有评测全部集中在标准公开英语数据集上,而专业垂直领域(法律、医疗、工业代码)的实证数据极度匮乏;
- 那么,在这个矩阵留白处提出的课题,自然天然具备了充分的研究动机(Research Motivation)。
六、阶段四:假设演化与正交消融实验设计
确定了研究空白后,科研工作便进入实验设计阶段。这也是 AI 辅助极具价值、却最考验数理严谨性的环节。
1. 将模糊直觉升华为可证伪科学假设(Falsifiable Hypothesis)
许多初涉科研者提出的假设往往是不可证伪的废话,例如“使用更先进的注意力机制能改善文本理解”。
在工程化工作流中,AI 应当扮演苏格拉底式的批判者,强制将假设拆解为标准的因果推断三要素:
- 自变量(Independent Variable $X$):系统具体改变了哪一个模块(例如:将固定长度分块改为基于语法树的动态分块);
- 因变量(Dependent Variable $Y$):采用何种客观量化指标来衡量变化(例如:跨段落问答的 BLEU-4 提升与幻觉率下降);
- 控制变量(Controlled Variables $Z$):在何种完全恒定的条件下对比(固定相同的温度系数 Temperature、相同的随机数种子 Seed、完全一致的基础大模型权重)。
2. 消融实验(Ablation Study)的完全正交化设计
顶会审稿人(如 NeurIPS、ICLR、ACL)拒稿最频繁的理由之一是:“无法证明性能提升到底归功于作者提出的核心模块,还是由于超参数微调带来的附带收益”。
一个严密的正交消融实验必须设计出完整的退化对照矩阵:
- 完整提议模型(Full System):包含模块 A + 模块 B + 模块 C;
- 移除模块 A(w/o Module A):验证模块 A 是否真正具备独立贡献;
- 移除模块 B(w/o Module B):验证模块 B 的贡献度;
- 移除模块 C(w/o Module C):验证模块 C 的贡献度;
- 传统基准替换(Module A replaced by Baseline A’):证明自己设计的模块确实优于传统既有方案,而非仅仅由于结构变复杂导致的提升。
3. 统计功效与样本量预估(Power Analysis)
在涉及用户实测、A/B 测试或长序列推断的实验中,样本量绝对不能拍脑袋决定。
必须通过严谨的统计功效分析预估样本规模:
- 显著性水平(Significance Level $\alpha$):通常设定为 0.05(即 5% 的第 I 类错误率,假阳性);
- 统计功效(Statistical Power $1-\beta$):通常设定为 0.80(即 80% 的概率能正确检测出真实存在的效应,避免第 II 类错误,假阴性);
- 预期效应量(Expected Effect Size Cohen’s $d$):根据前期预实验或文献基准评估改动的期望收益;
- 只有在满足最低统计检验样本量的前提下产出的 P 值($p < 0.05$),才能在论文中被作为强有力的实证证据。
七、阶段五:学术伦理合规、防学术造假与审稿防伪护栏
国际顶尖学术出版集团与学术会议对 AI 辅助科研的监管日趋严格。任何不透明、不严谨的 AI 使用行为,都可能给学者的学术声誉带来不可逆的毁灭性打击。
1. 主流学术出版机构对 AI 工具的最新合规边界
目前,Nature 系列期刊、Science、IEEE、ACM 与 Elsevier 已经形成了高度共识的四大底线规范:
- AI 大模型绝不具备论文署名资格(Authorship):因为大模型无法对其发表内容的真实性、原创性与伦理问题承担法律与学术责任;
- 强制透明披露(Transparency & Disclosure):必须在论文的“致谢(Acknowledgments)”或“方法论(Methods)”章节中,明确陈述使用了何种 AI 工具(注明模型版本号、提供商),并清晰界定 AI 参与了哪些环节(例如仅用于润色语言、提取文献,还是参与了代码编写);
- 作者对全文承担无限连带责任(Sole Accountability):即使是由于 AI 产生的虚假文献或错误公式,第一作者与通讯作者也必须承担 100% 的学术不端责任;
- 禁止向公共商用模型输入未发表的原始同行评审材料或敏感受试者隐私数据。
2. 原始实验数据防篡改沙箱(Data Provenance & Hash Hashing)
为了彻底证明实验成果的真实原创性,抵御潜在的学术不端质疑,工业级工作流应推行数据来源可信溯源(Data Provenance)机制:
- 每次实验执行完毕后,自动化脚本自动收集所有超参数配置文件、环境依赖快照、随机数种子;
- 将原始实验日志(Raw Logs)与生成的图表数据计算生成唯一的 SHA-256 哈希签名;
- 将哈希值连同时间戳自动推送到受保护的代码仓库(如 GitHub Private Releases 或 Zenodo 预存库),建立不可逆转的时间锁凭证,自证数据生成的物理时间早于论文投稿。
八、5 大高危反模式与深度避坑指南
在实际科研场景中,以下 5 种反模式极度高发,稍有不慎便会导致实验无效、论文拒稿甚至学术调查:
1. 反模式一:直接在聊天框向大模型索要“参考文献列表”
- 致命陷阱:大模型的底层原理是基于概率预测下一个 Token,而非事实检索。直接向其询问“请给我列出 10 篇关于 X 的最新论文”,模型会极其逼真地把知名学者名字与热门词汇拼凑在一起,生成完全虚构的“幽灵论文”。
- 破解之道:必须使用检索增强(RAG)+ 真实学术数据库 API。先由 API 检索出真实的真实文献条目,再要求大模型基于已检索到的真实 JSON 数据进行归纳,坚决阻断自由联想。
2. 反模式二:让 AI 介入原始实验数据的“清洗与插值”
- 致命陷阱:在实验遇到部分异常离群点(Outliers)或空缺值时,部分研究者试图用大模型“智能修补数据”,模型往往会倾向于生成完全符合理论预期的完美平滑曲线。
- 破解之道:这是严重的学术伪造数据行为。任何数据的剔除与补全,必须使用公开透明、具备数理依据的统计学方法(如箱线图 IQR 过滤、KNN 插补或多重插补),并在论文中完整披露清洗规则,绝不能经由 AI 随意润色。
3. 反模式三:用 AI 生成的文献综述直接代替人工通读核心奠基论文
- 致命陷阱:AI 可以高效筛选上百篇边缘文献,但对于所在领域的 3 到 5 篇核心经典奠基工作,如果学者本人没有逐字精读、亲自推导每一个公式,在同行答辩或专家评审的犀利追问下必然会破绽百出。
- 破解之道:恪守“AI 负责广度扫描,学者垄断深度精读”原则。AI 产出的文献矩阵用于快速定位核心枢纽,一旦锁定关键论文,学者必须亲自介入全文精读。
4. 反模式四:基于纯相关性生成的“伪因果实验假设”
- 致命陷阱:大模型极擅长根据表面词汇共现生成看似高深、实则缺乏内在逻辑的假设(例如:“将语音注意力与蛋白质折叠算法结合”)。
- 破解之道:必须要求 AI 给出假设背后的第一性原理(First Principles)推导路径,明确跨模态映射在物理或数学机理上的本质相通性,拒绝缺乏先验支撑的机械拼凑。
5. 反模式五:隐瞒 AI 辅助行为,试图完全消除“AI 味道”发表
- 致命陷阱:抱着侥幸心理以为编辑部检测不出来,使用各种提示词指令强行压低检测率,一旦期刊采用最新反作弊模型或被读者人工举报,将直接面临严厉调查。
- 破解之道:正视学术规范,坦荡合规披露。规范使用 AI 工具辅助科研绝非不可告人的污点,只要在正文中清晰严谨地陈述 AI 的辅助边界,展示严密的原始实证数据与复现代码,不仅不会受到歧视,反而会彰显团队的严谨与前瞻性。
九、科研人员 AI 辅助工作流上线前 15 项自检清单
在将 AI 辅助产出的学术成果提交至预印本平台(arXiv)或正式投稿前,请对照以下 15 项清单逐一核验:
一、文献与检索合规(Retrieval & Citation)
-
- 文中所引用的每一篇参考文献均具备真实有效的 DOI、arXiv ID 或出版物索引,杜绝任何幽灵文献。
-
- 核心观点引用的页码与章节标注准确无误,抽取的结论未脱离原文上下文被断章取义。
-
- 涵盖了该方向最近 12~24 个月内发表的最新代表性工作,未出现明显的年代断层。
-
- 参考文献列表未出现单一机构或特定学者的不合理过度自引,保持了学术引用广度。
二、综述与批判性思考(Synthesis & Gap)
-
- 文献综述章节清晰呈现了不同流派的技术路线演进脉络,而非单篇论文的机械堆砌。
-
- 准确指出了既有代表性工作的具体局限性与适用边界,为本文的核心动机提供了坚实支撑。
-
- 涉及学术争议的命题客观陈述了各方立场与实验条件差异,避免了绝对化的单方定论。
三、实验设计与统计严谨性(Method & Experiments)
-
- 核心科学假设具备明确的可证伪性,自变量、因变量与控制变量定义完全正交解耦。
-
- 消融实验设计完备,能够分别独立验证每一个新增模块或改动的有效性。
-
- 实验样本量满足预先设定的统计功效要求,测试集与训练集之间建立了物理隔离,杜绝信息泄露。
-
- 涉及随机过程的实验均固定并明确记录了随机数种子(Random Seed),并汇报了多轮运行的方差或置信区间。
四、科研诚信与合规披露(Ethics & Reproducibility)
-
- 严格遵循目标期刊或会议的 AI 工具使用政策,在致谢或方法部分提供了准确的合规声明。
-
- 绝无使用 AI 虚构、润色、篡改原始观测数据或实验图表数值的行为。
-
- 核心实现代码、依赖环境配置(Dockerfile/requirements.txt)与运行说明已妥善脱敏并打包就绪。
-
- 原始数据与实验过程日志已计算 SHA-256 哈希值归档,具备完整防篡改审计追踪链条。
结语
科学研究的本质,是对未知的探索与对真理的求索。工具的形态在变,从早期的羊皮纸手稿、计算尺,到现代的超级计算机、大语言模型,每一次计算工具的跃升,都极大地拓展了人类认知世界的边界。
然而,工具越是强大,人类学者所肩负的科学诚信与批判性把关责任就越是厚重。大语言模型可以以千倍于人类的速度遍历数以万计的文献片段,可以瞬间平铺开详尽的实验对照矩阵,但它永远无法替代学者在面对反常数据时那敏锐的科学直觉,永远无法替代学者在深夜实验室中亲自验证每一个假设的严谨求证精神。
将 AI 视为高吞吐、严规范、可溯源的学术外脑与工程杠杆,恪守学术道德底线,让技术服务于严谨的求证,唯有如此,我们才能在席卷而来的信息巨浪中,真正推开未知世界的大门。
如果您在搭建垂直领域的学术知识库、设计自动化文献跟踪流水线或科研工程化落地中遇到疑问,欢迎随时访问 TypeTube 交流页面 探讨交流。