近两年来,从初创团队到跨国企业,几乎所有组织都在不遗余力地采购大模型 API、为全员配备 AI 编程插件、搭建内部知识库与智能客服。然而,随着财务周期结算,越来越多的企业管理层与技术负责人开始陷入前所未有的“AI 生产力悖论(The AI Productivity Paradox)”:
- 财务侧困惑:AI 工具的账单每个月都在攀升,采购了数以百计的企业版账号,但业务部门的整体研发交付周期(Cycle Time)并没有按预期缩短 30% 甚至 50%,甚至研发预算和运维开销还在同步膨胀;
- 管理侧迷茫:一线员工在汇报时纷纷表示“日常工作感觉轻松了”、“写代码查资料变快了”,但最终反映在业务大盘上的新功能交付吞吐量(Throughput)与线上产品迭代节奏却几乎没有明显波澜;
- 技术侧焦虑:伴随 AI 生成代码的大规模倾泻,代码仓库的提交体积呈几何级数膨胀,但下游的 Code Review 耗时激增、偶发性线上缺陷增加、代码流失率(Code Churn)攀升,团队反而深陷技术债务泥潭。
出现这种困境的根本根源,在于绝大多数企业在引入 AI 时,仍然沿用着早已过时或严重畸变的度量指标:把“Token 消耗量”、“月活对话数”、“IDE 自动补全采纳率(Acceptance Rate)”或“代码生成行数(Lines of Code, LoC)”当作评估 AI 投资回报率(ROI)的核心依据。
一旦以这些虚荣指标为锚点,就会触发经典的古德哈特定律(Goodhart’s Law)——“当一个指标变成目标时,它就不再是一个好指标”。工程师为了迎合指标,会频繁无脑敲击 Tab 键接受 AI 生成的冗余逻辑,制造出海量缺乏深度设计的浅层代码,表面上“AI 渗透率 100%”,实质上严重破坏了系统架构与交付质量。
真正的 AI 效能度量与价值归因体系,绝不是统计单点的生成速度,而是构建一套贯穿端到端业务交付流转、质量与技术债务对冲、工程师深工作体验、以及扣除隐性返工成本后真实净财务回报的多维平衡度量网络。
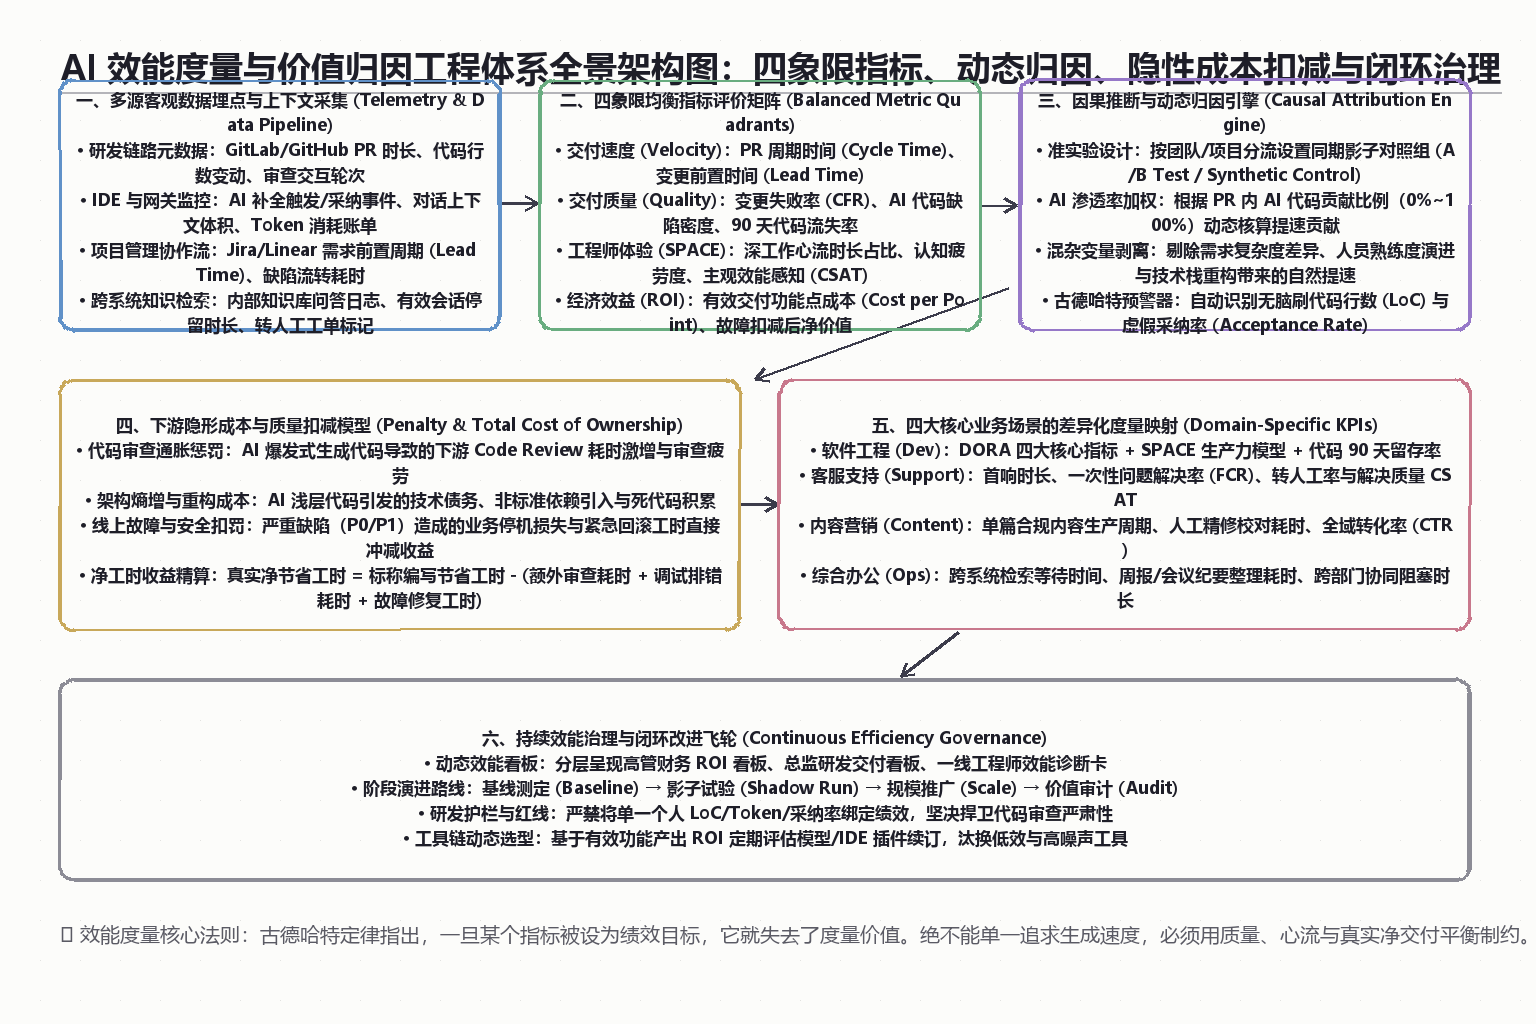
本文将为你深度拆解一套已被高绩效技术组织验证的可落地 AI 效能量化指标体系。我们将从传统度量模式的失效根源切入,详细阐述交付速度、质量韧性、SPACE 认知体验、经济净收益四大象限的指标矩阵,深入分析下游审查通胀与技术债务扣减模型,并提供一套生产级 Python 效能归因引擎实战代码与 15 项企业落地自检清单,帮助团队撕开虚荣指标的迷雾,精准评估并持续释放 AI 的真正生产力。
一、三代效能度量范式的演进与核心分歧
在设计具体的度量指标之前,我们必须清晰剖析不同效能度量范式在数据采集、归因逻辑、防作弊能力与业务相关性上的本质鸿沟。
| 评估维度 | 第一代:活动量虚荣度量 (Activity & Vanity) | 第二代:孤岛主观感知 (Subjective Perception) | 第三代:端到端全链路价值平衡度量 (Outcome-Driven Balanced System) |
|---|---|---|---|
| 典型代表指标 | Token 消耗量、活跃用户数 (DAU/MAU)、AI 补全采纳率、代码生成行数 (LoC) | 满意度问卷 (CSAT)、员工自评“感觉节省了 X 小时”、主观效能打分 | DORA 交付流转、SPACE 认知模型、90 天代码留存率、真实净 ROI |
| 数据采集方式 | 依赖供应商后台仪表盘或单点插件统计 | 周期性问卷调研、抽样访谈、口头汇报 | 研发/业务全链路元数据埋点(Git、Jira、CI/CD、线上监控、网关) |
| 古德哈特定律脆弱性 | 极度脆弱(极易引发刷量、滥用补全、堆砌冗余代码) | 较高(存在强烈的安慰剂效应、幸存者偏差与预期管理偏差) | 极低(通过速度、质量、成本多维相互制衡,作弊成本极高) |
| 下游审查与隐性成本 | 完全盲目(只看生成前段,不管下游审查与维护代价) | 难以量化(无法客观衡量审查者疲劳与返工代价) | 强制扣减(将下游 Code Review 耗时与故障修复成本纳入负向因子) |
| 因果归因严谨度 | 伪归因(将活跃等同于生产力提升) | 模糊归因(依赖受访者直觉估算) | 科学准实验归因(对照组切分、需求复杂度加权、AI 渗透率插值) |
| 业务价值相关性 | 弱相关甚至负相关(代码变多可能意味着架构劣化) | 中等偏弱(满意度高不代表商业吞吐量提升) | 强相关(直接挂钩需求交付周期、系统可用性与单位功能点成本) |
| 组织行为引导导向 | 激励无节制调用与浅层堆砌 | 鼓励形式主义汇报 | 引导工程整洁、专注深工作心流、持续收敛技术债务 |
从上表可以看出,第三代效能度量体系的核心哲学是:速度必须由质量来校验,个人效率必须由团队端到端流转来校准,标称节省工时必须扣除全生命周期的维护折旧与下游通胀。
二、维度一:交付流转与速度指标(Velocity & Flow Metrics)
在敏捷开发与数字化业务中,单点编写速度的加快并不等价于业务速度的提升。根据约束理论(Theory of Constraints),在一个由多个工序组成的流水线中,非瓶颈环节的局部提速不仅无法提升系统整体吞吐量,反而会导致在制品(WIP)堆积,造成整体流水线阻塞。
因此,速度维度的度量必须聚焦于端到端流转效率(Flow Efficiency)与周期耗时。
1. PR 周期时间(Pull Request Cycle Time)及其阶段切片
PR 周期时间是指从开发者提交第一个 Commit 开始,到该代码通过审查、合并进主干(Merged)并就绪发布的完整耗时。这是反映工程效能最敏感的脉搏。
工业级体系绝不看粗粒度的总时长,而是将其拆解为四大阶段切片:
- 编写耗时(Coding Time):从首次提交到发起 Pull Request / Merge Request。这是 AI 辅助编程最直接产生影响的区间。正常情况下,编写耗时应呈现下降趋势;
- 就绪等待耗时(Pickup / Wait Time):PR 发起后,等待审查者(Reviewer)开始介入的时间。若编写速度极快但等待时间拉长,说明流水线形成了“在制品堵塞”;
- 审查交互耗时(Review & Revision Time):Reviewer 提出修改建议与作者反复推敲修改的区间。这是监控 AI 负向效应的核心观察窗。如果 AI 生成的代码存在大量“幻觉逻辑”或风格不符,审查交互轮次(Review Iterations)和耗时会异常激增;
- CI/CD 与合流耗时(Merge / CI Time):自动化测试跑完至合入主干的时间。
2. 变更前置时间(Lead Time for Changes - DORA 核心指标)
从需求在管理平台(Jira / Linear / TAPD)被正式拉起、排期进入开发,到最终在生产环境(Production)对用户生效的完整时间跨度。
- 健康演进特征:随着 AI 的深入应用,中低复杂度需求(如标准化 CRUD、单元测试补齐、API 适配)的 Lead Time 呈现指数级收敛;
- 异常警报特征:编写时间缩短,但由于缺少自动化测试护栏,导致在测试环境徘徊反复,最终端到端 Lead Time 纹丝不动。
3. 有效交付吞吐量(Effective Throughput)
单位时间周期(如每两周双周迭代)内,成功交付到生产环境的有效业务功能点数(Story Points)或合格 PR 数量。
- 防作弊过滤规则:必须通过排除规则剔除“纯样式微调”、“依赖升级脚本刷出来的伪 PR”,只统计承载明确业务价值或高优架构重构的交付物。
三、维度二:质量、技术债务与隐性成本扣减(Quality & Tech Debt)
如果说速度指标衡量的是“油门踩得有多深”,那么质量与技术债务指标衡量的则是“刹车与轮胎磨损程度”。缺乏质量约束的速度度量是危险的数字游戏。
1. 90 天代码流失率(Code Churn / 90-Day Retention Rate)
代码流失率是指新代码合并入主干后,在接下来的 90 天内被修改、重写或直接删除的代码行数占比:
$$\text{Code Churn Rate} = \frac{\text{Lines Modified or Deleted within 90 Days}}{\text{Total Lines Added}} \times 100%$$
- 度量逻辑:高质量的工程代码具有极强的稳定性与架构契合度。若 AI 辅助编写的代码在合入仓库后,迅速因为边缘条件崩溃、接口设计不合理、逻辑冗长被后续开发者频繁推倒重写,则说明这部分“提速”实质上是提前透支了架构寿命的“虚假繁荣”。
- 健康基线:成熟团队的代码流失率通常稳定在 15%~25% 区间,若 AI 密集型模块的流失率超过 40%,必须立即启动架构审查。
2. 变更失败率(Change Failure Rate, CFR - DORA 核心指标)
发布到生产环境的代码变更中,导致严重服务降级、故障告警或触发紧急回滚(Rollback)与热修复(Hotfix)的比例。
- 度量逻辑:这是检验 AI 生成物稳健性的最终裁判。若引入 AI 插件后,团队代码提交量暴增 50%,但 CFR 从 3% 飙升至 8%,不仅所有节省的工时都会被线上救火抵消,还会造成恶劣的商业信誉损失。
3. AI 缺陷密度与严重度加权(Defect Density per KLoC)
每 1,000 行变更代码对应的线上与测试环境缺陷数量:
$$\text{Weighted Defect Density} = \frac{\sum (\text{Defects} \times \text{Severity Weight})}{\text{Merged KLoC}}$$
- 严重度权重分配建议:P0/P1(致命与严重)赋予 5
10 倍惩罚权重,P2/P3(一般与轻微)赋予 12 倍权重。
4. 隐形审查成本扣减模型(The Review Tax)
这是 AI 时代最具隐蔽性的效能杀手。传统度量往往只记录了“编写者省下了 20 分钟”,却忽略了下游审查者为了看懂这篇由 AI 拼凑出来的、看似工整实则缺乏架构设计的 500 行代码,多花了 40 分钟进行上下文溯源和逻辑验证。
真实净工时收益的计算公式必须强制引入扣减项:
$$\Delta T_{\text{net}} = T_{\text{saved_author}} - (\Delta T_{\text{review_overhead}} + \Delta T_{\text{debug_overhead}} + T_{\text{incident_remediation}})$$
其中:
- $T_{\text{saved_author}}$:作者在编码/草拟阶段相比历史基线的标称节省工时;
- $\Delta T_{\text{review_overhead}}$:下游审查者超出该类需求平均审查耗时的额外通胀工时;
- $\Delta T_{\text{debug_overhead}}$:联调与集成测试阶段用于排查隐晦边界错误的额外工时;
- $T_{\text{incident_remediation}}$:后续线上故障定位、紧急发版与事故复盘所消耗的总工时。
当 $\Delta T_{\text{net}} < 0$ 时,表明该工具或该开发范式正在产生负向生产力,必须立刻收紧准入标准。
四、维度三:工程师认知负荷与体验(SPACE 框架深度融合)
传统的泰勒制“工时与动作度量”在知识工作领域早已被证明是反生产力的。GitHub 与微软研究院联合提出的 SPACE 生产力框架,为评估工程师的真实状态提供了现代科学依据。
1. 满意度与心理健康(Satisfaction & Wellbeing)
- 工具信赖度指数(Trust Index):开发者是否敢于把核心架构逻辑交给 AI,还是仅将其视为主管强制摊派的任务?
- 认知枯竭与心智疲劳度:AI 带来的海量代码片段是降低了心智负担,还是迫使工程师整天处于“找茬纠错”的警惕与紧张中?通过季度匿名小问卷(轻量级 3 题,5 分制)持续监测。
2. 效能与心流状态(Efficiency & Flow State)
- 深工作时间占比(Deep Work Ratio):工程师一天中拥有超过 2 小时无中断连续聚焦编码与思考的时间块(Focus Blocks)比例。
- 心流中断频率(Interruption Rate):频繁的低质量补全弹窗提示,是否频繁打断开发者的宏观架构构思?一个优秀的 AI 工具应当在开发者深思时保持安静,在模式化输入时精准提供支持。
五、维度四:经济投入产出比(Economic ROI & Net Financial Return)
对于企业决策者与 CFO 而言,所有的工程指标最终都要收敛至财务视角:这笔 AI 投入到底给公司省了多少钱、创造了多少业务增量?
总拥有成本 (TCO)
├── 工具授权许可费 (SaaS 订阅 / 人头费)
├── 基础设施与 API 账单 (Token 消耗 / 私有化显卡与算力实例)
├── 治理与工程改造成本 (网关建设 / 规则配置 / 数据清洗)
└── 培训与工作流适配成本 (内部 SOP 建立 / 员工工时占用)

真实净商业价值 (Net Business Value)
├── 毛节省工时折现 = 经质量校准的净节省工时 × 标准人均综合时薪
├── 交付提速带来的业务机会收益 (Time-to-Market Opportunity Gain)
├── 扣减:技术债务治理专项工时折算
└── 扣减:重大生产事故业务损失与违约赔偿
真实净投资回报率的测算公式如下:
$$\text{Net ROI} = \frac{\text{Net Business Value} - \text{TCO}}{\text{TCO}} \times 100%$$
如果一家企业声称引入 AI 工具后 ROI 高达 500%,但计算时分子只算“名义节省工时”,分母只算“SaaS 订阅费”,完全忽略了私有算力折旧、审查通胀与事故损失,这种汇报在财务审计面前是不堪一击的。
六、四大核心业务场景的差异化度量实践
不同的业务职能,其交付物形态与价值杠杆截然不同。严禁在全公司推行一刀切的统一 KPI,必须因地制宜设计场景化指标。
| 业务场景 | 核心瓶颈与痛点 | 推荐核心指标(主攻) | 负向约束指标(防御) | 禁忌反模式指标 |
|---|---|---|---|---|
| 软件研发 (Software Eng) | 复杂业务逻辑抽象、跨服务依赖联调、系统稳定性保障 | • DORA PR Cycle Time • 90天代码留存率 • 深工作时长占比 |
• 变更失败率 (CFR) • PR 审查交互轮次 • 缺陷逃逸率 |
• 代码生成行数 (LoC) • IDE 补全采纳率 (Acceptance Rate) |
| 客户服务 (Customer Support) | 重复问题咨询量大、疑难复杂问题响应不及时、客服流失率高 | • 一次性解决率 (FCR) • 首响时长 (First Response Time) • 平均处理时长 (AHT) |
• 转人工申诉率 • 用户重问率 (72小时内再次发起) • CSAT 真实满意度 |
• 单纯看 AI 对话拦截量(导致机器人答非所问、用户陷入死循环) |
| 内容营销 (Marketing & Content) | 选题灵感枯竭、多渠道排版耗时、长文撰写周期漫长 | • 单篇合格内容生产总周期 • 全渠道资产分发吞吐量 • 首稿完成耗时 |
• 人工校对精修耗时比 • 内容同质化率 (查重系数) • 真实转化率 (CTR/留资) |
• 纯生成文章篇数(导致互联网充斥毫无转化价值的 AI 垃圾文章) |
| 综合办公与知识管理 (Ops & HR) | 跨系统跨文档查阅困难、信息碎片化严重、会议冗长 | • 跨知识库检索定位时长 • 纪要/报表结构化归档周期 • 跨部门协作阻塞等待时长 |
• 信息准确率 (事实核验抽检) • 跨系统数据越权拦截率 |
• 提问总轮次(提问多可能因为知识库答不准、用户反复试探) |
七、工业级实战:Python 效能度量与动态归因引擎
为了帮助工程团队从概念走向落地,下面提供一套生产级单文件 Python 实战代码:ProductivityMetricsEngine。
该引擎实现了核心的度量逻辑:
- 建立 Git PR、审查互动、线上故障事件的强类型数据契约;
- 计算端到端 PR 周期各阶段切片;
- 基于 AI 渗透率与需求复杂度进行归因加权;
- 强制执行下游审查通胀与故障损失扣除,精算真实净节省工时;
- 内置古德哈特刷量预警探针(识别低质量高行数刷量)。
# -*- coding: utf-8 -*-
"""
AI 研发效能度量与净价值归因引擎 (ProductivityMetricsEngine)
功能:
1. 周期切片计算 (Coding, Pickup, Review, Merge)
2. 下游隐性成本扣减与真实净工时精算
3. 代码流失率 (Code Churn) 追踪
4. 古德哈特刷量反模式预警
"""
from dataclasses import dataclass, field
from datetime import datetime, timedelta
from typing import List, Dict, Optional

@dataclass
class PullRequestEvent:
    pr_id: str
    author_id: str
    created_at: datetime
    first_review_at: Optional[datetime]
    approved_at: Optional[datetime]
    merged_at: Optional[datetime]
    lines_added: int
    lines_deleted: int
    ai_generated_ratio: float  # 0.0 ~ 1.0 (AI贡献比例)
    review_comments_count: int
    rework_lines_90d: int      # 90天内被再次修改/删除的代码行数
    is_hotfix_or_rollback: bool = False
    incident_cost_hours: float = 0.0 # 若引发事故,对应的修复工时

@dataclass
class TeamBaseline:
    avg_coding_hours_per_kloc: float = 24.0      # 传统每千行编写耗时基准(小时)
    avg_review_hours_per_kloc: float = 6.0       # 传统每千行审查耗时基准(小时)
    standard_hourly_rate: float = 60.0           # 综合时薪(美元/小时,折算基准)

class ProductivityMetricsEngine:
    def __init__(self, baseline: TeamBaseline):
        self.baseline = baseline

    def calculate_cycle_slices(self, pr: PullRequestEvent) -> Dict[str, float]:
        """计算 PR 各阶段耗时(小时)"""
        if not pr.merged_at:
            return {"status": "unmerged"}

        # 1. 编写等待首次审查 (Pickup Time)
        pickup_hours = 0.0
        if pr.first_review_at:
            pickup_hours = max(0.0, (pr.first_review_at - pr.created_at).total_seconds() / 3600.0)

        # 2. 审查交互耗时 (Review Time)
        review_hours = 0.0
        start_rev = pr.first_review_at or pr.created_at
        end_rev = pr.approved_at or pr.merged_at
        if end_rev > start_rev:
            review_hours = (end_rev - start_rev).total_seconds() / 3600.0

        # 3. 批准到合流耗时 (Merge CI Time)
        merge_hours = 0.0
        if pr.approved_at:
            merge_hours = max(0.0, (pr.merged_at - pr.approved_at).total_seconds() / 3600.0)

        total_hours = (pr.merged_at - pr.created_at).total_seconds() / 3600.0

        return {
            "pickup_hours": round(pickup_hours, 2),
            "review_hours": round(review_hours, 2),
            "merge_hours": round(merge_hours, 2),
            "total_cycle_hours": round(total_hours, 2)
        }

    def evaluate_net_productivity(self, pr: PullRequestEvent) -> Dict[str, any]:
        """
        计算单 PR 的真实净工时收益与经济价值(扣除审查通胀与质量惩罚)
        """
        kloc = max(0.05, (pr.lines_added + pr.lines_deleted) / 1000.0)

        # 标称编写节省工时 (根据 AI 渗透率加权,假定理想最大提速 40%)
        max_speedup_ratio = 0.40
        nominal_saved_hours = (kloc * self.baseline.avg_coding_hours_per_kloc) * (pr.ai_generated_ratio * max_speedup_ratio)

        # 计算审查阶段的隐性开销 (Review Tax)
        slices = self.calculate_cycle_slices(pr)
        actual_review_hours = slices.get("review_hours", 0.0)
        expected_review_hours = kloc * self.baseline.avg_review_hours_per_kloc

        # 额外审查通胀(超出基准的部分)
        review_overhead = max(0.0, actual_review_hours - expected_review_hours)

        # 90天代码流失惩罚(流失率超过 20% 的部分折算返工工时)
        churn_rate = (pr.rework_lines_90d / max(1, pr.lines_added))
        churn_penalty_hours = 0.0
        if churn_rate > 0.20:
            excess_churn_lines = pr.rework_lines_90d - (pr.lines_added * 0.20)
            churn_penalty_hours = (excess_churn_lines / 1000.0) * self.baseline.avg_coding_hours_per_kloc

        # 事故与回滚直接惩罚
        incident_penalty = pr.incident_cost_hours
        if pr.is_hotfix_or_rollback:
            incident_penalty += 8.0 # 紧急回滚与发版固定扣减 8 小时

        # 真实净节省工时 (Net Saved Hours)
        net_saved_hours = nominal_saved_hours - (review_overhead + churn_penalty_hours + incident_penalty)
        net_economic_value = net_saved_hours * self.baseline.standard_hourly_rate

        # 古德哈特刷量检测逻辑
        anti_pattern_flags = []
        if pr.lines_added > 800 and pr.ai_generated_ratio > 0.8 and pr.review_comments_count == 0:
            anti_pattern_flags.append("HIGH_RISK_RUBBER_STAMP: 大体积AI代码未经有效审查秒合入")
        if churn_rate > 0.45:
            anti_pattern_flags.append("HIGH_CHURN_RATE: 90天流失率过高,存在浅层垃圾代码嫌疑")
        if actual_review_hours > expected_review_hours * 2.5:
            anti_pattern_flags.append("REVIEWER_FATIGUE: 下游审查严重受阻,可能存在逻辑晦涩或幻觉")

        return {
            "pr_id": pr.pr_id,
            "nominal_saved_hours": round(nominal_saved_hours, 2),
            "review_overhead_hours": round(review_overhead, 2),
            "churn_penalty_hours": round(churn_penalty_hours, 2),
            "incident_penalty_hours": round(incident_penalty, 2),
            "net_saved_hours": round(net_saved_hours, 2),
            "net_economic_value_usd": round(net_economic_value, 2),
            "churn_rate_pct": round(churn_rate * 100, 1),
            "flags": anti_pattern_flags,
            "is_net_positive": net_saved_hours > 0
        }

# ================= 演示与测试用例 =================
if __name__ == "__main__":
    baseline = TeamBaseline()
    engine = ProductivityMetricsEngine(baseline)

    now = datetime.now()

    # 案例 A: 高质量小步快跑的 AI 辅助交付
    good_pr = PullRequestEvent(
        pr_id="PR-101",
        author_id="dev_alice",
        created_at=now - timedelta(hours=6),
        first_review_at=now - timedelta(hours=5),
        approved_at=now - timedelta(hours=3),
        merged_at=now - timedelta(hours=2),
        lines_added=220,
        lines_deleted=40,
        ai_generated_ratio=0.6,
        review_comments_count=3,
        rework_lines_90d=15, # 极低流失
        is_hotfix_or_rollback=False,
        incident_cost_hours=0.0
    )

    # 案例 B: 表面高产、实则带来严重审查通胀与线上事故的伪提速
    bad_pr = PullRequestEvent(
        pr_id="PR-102",
        author_id="dev_bob",
        created_at=now - timedelta(hours=28),
        first_review_at=now - timedelta(hours=26),
        approved_at=now - timedelta(hours=8),
        merged_at=now - timedelta(hours=6),
        lines_added=1200,    # 大量生成
        lines_deleted=100,
        ai_generated_ratio=0.9,
        review_comments_count=18, # 反复拉扯
        rework_lines_90d=650, # 超过 50% 流失
        is_hotfix_or_rollback=True,
        incident_cost_hours=12.0 # 引发线上事故救火
    )

    print("=== 案例 A: 健康交付评估 ===")
    res_a = engine.evaluate_net_productivity(good_pr)
    print(f"标称节省: {res_a['nominal_saved_hours']}h | 净节省: {res_a['net_saved_hours']}h | 净收益: ${res_a['net_economic_value_usd']}")
    print(f"告警标识: {res_a['flags']}\n")

    print("=== 案例 B: 质量崩塌与负向价值评估 ===")
    res_b = engine.evaluate_net_productivity(bad_pr)
    print(f"标称节省: {res_b['nominal_saved_hours']}h | 净节省: {res_b['net_saved_hours']}h | 净收益: ${res_b['net_economic_value_usd']}")
    print(f"告警标识: {res_b['flags']}")
八、实施 AI 效能度量的 5 大致命反模式与避坑指南
在许多企业推进效能度量的历程中,不当的指标设计往往比缺乏度量更加有害。以下是业界血泪总结的五大反模式:
1. 致命反模式一:把“AI 采纳率”写入部门或个人 KPI
- 病灶表现:管理层要求各业务团队“Copilot 代码采纳率不低于 35%”,达不到就扣绩效。
- 灾难后果:工程师会在敲代码时不断按下 Tab,随后再手动删除多余逻辑,或者故意拆散简单逻辑促使补全触发。采纳率轻松刷到 45%,但代码库充斥垃圾代码,真正核心的架构设计全面倒退。
- 正解:采纳率只能作为产品可用性反馈指标(供工具评估团队判断插件好不好用),绝对不可作为绩效考核指标。
2. 致命反模式二:只看“个人编写快慢”,忽视“全局流动瓶颈”
- 病灶表现:通过桌面录屏或自报工具,得出“程序员编码速度提升了 40%”,然而产品的月度发布计划毫无变化。
- 灾难后果:现代研发的真正瓶颈往往在需求澄清、安全合规审计、跨系统依赖排期、灰度发布验证。盲目加速代码生成,只会导致未测试的 PR 在代码库大排长龙,加剧团队认知负荷。
- 正解:使用 DORA 的 Lead Time for Changes,从端到端流水线找瓶颈,把 AI 优先部署在最堵塞的工序(如自动化测试用例生成、API 文档同步生成)。
3. 致命反模式三:形式主义代码审查(Rubber Stamp Review)
- 病灶表现:AI 生成的 PR 体积越来越大(从平均 200 行攀升至 800 行),审查者感到心力交瘁,索性看都不看直接点击“Approve”。
- 灾难后果:代码防线彻底失守,逻辑漏洞长驱直入生产环境,系统稳定性全面崩塌。
- 正解:设立单 PR 最大行数硬性门禁(如建议不超过 300 行);超过阈值的强制拆分;在审查环节引入 AI 差异总结与敏感调用高亮,给审查者赋能而非施压。
4. 致命反模式四:在缺乏历史基线(Baseline)的情况下盲目归因
- 病灶表现:引入 AI 后的首个季度,业务交付了 50 个需求,管理层立刻声称“这全归功于 AI 赋能”。
- 灾难后果:未扣除当期业务需求复杂度降低、团队招募熟练工、或者技术栈升级等自然提速因素,导致对 AI 工具价值做出过高误判,引发后续预算失控。
- 正解:在推进前至少采集过去 3~6 个月的历史 DORA 基线数据;有条件的团队采用“分批试点对照组”进行差异对比分析。
5. 致命反模式五:在探索型架构创新中强行追求线性效能
- 病灶表现:要求从事前沿架构预研、底层协议重构的高级专家必须使用 AI 并汇报工时节省。
- 灾难后果:AI 擅长的是已有模式的插值与搬运,而在解决 0 到 1 的未知架构问题时,盲目使用 AI 反而会带偏思路、制造认知干扰。
- 正解:区分业务开发(Exploitation,高复用性,适合大力推行指标度量)与技术探索(Exploration,高不确定性,以突破性成果而非日常工时度量)。
九、企业落地与持续治理:15 项生产上线自检清单与演进路线图
为了确保企业能够平稳推进 AI 效能度量,避免走入死胡同,建议按照四阶段演进路线稳妥落地:
第一阶段:基线测定 (0 - 30 天)
├── 全链路元数据静默采集 (Git / Jira / CI-CD)
└── 锁定研发与业务团队过去 3-6 个月的基础交付指标基线

第二阶段:准实验影子运行 (30 - 60 天)
├── 圈定 2-3 个代表性试点项目组(搭配同期对照组)
└── 跑通四象限指标与下游隐性成本扣减模型

第三阶段:看板落地与多维制衡 (60 - 90 天)
├── 建设分层效能仪表盘(高管财务层 / 总监交付层 / 一线体验层)
└── 建立古德哈特反作弊告警与代码留存率追踪

第四阶段:持续治理与工具优胜劣汰 (90 天以后)
├── 季度审计真实净 ROI 与单位功能点成本
└── 基于有效产出数据,动态调整工具订阅与算力资源分配
生产上线 15 项效能度量落地自检清单
| 序号 | 检查维度 | 具体检查项 | 达标标准 | 状态 |
|---|---|---|---|---|
| 1 | 基线准备 | 是否已拉取引入 AI 前至少 90 天的真实 DORA 指标? | 拥有清晰的 Lead Time、Cycle Time、CFR 历史均值与方差 | [ ] |
| 2 | 数据采集 | 研发与协作元数据是否实现全自动客观抓取? | 无需工程师手工填写工时,全部基于 Git/Jira API 自动解析 | [ ] |
| 3 | 指标隔离 | 是否严禁将单点补全采纳率与 Token 消耗绑定绩效? | 官方绩效规约中明确禁止将单点虚荣指标列为考核 KPI | [ ] |
| 4 | 流转拆解 | PR 周期是否能够精准切片出 Coding、Pickup、Review 各阶段? | 能够精确定位瓶颈是在作者编码还是下游等待审查 | [ ] |
| 5 | 质量制约 | 是否将变更失败率 (CFR) 与线上缺陷列为一票否决指标? | 交付速度提升的前提是变更失败率不出现统计学显著升高 | [ ] |
| 6 | 代码留存 | 是否建立了 90 天代码流失率 (Code Churn) 追踪机制? | 能够定期甄别合入后被快速推倒重写的低质浅层代码 | [ ] |
| 7 | 审查防线 | 是否设定了单 PR 代码体积上限与反形式主义审查警报? | 杜绝超大体积 AI 代码秒级合入,保护 Reviewer 心智资源 | [ ] |
| 8 | 扣减模型 | 测算节省工时时,是否强制扣减了审查通胀与故障处理开销? | 采用真实净节省工时计算公式,杜绝名义毛利自嗨 | [ ] |
| 9 | 认知体验 | 是否引入了 SPACE 框架中的深工作时长与心流健康监测? | 关注工程师注意力碎片化问题,每季度进行匿名体验抽检 | [ ] |
| 10 | 财务真实 | 财务 ROI 核算是否包含算力、网关治理与工时折旧全口径? | TCO 计算完备,不遗漏私有部署算力与隐性维护成本 | [ ] |
| 11 | 场景映射 | 客服、研发、运营各部门是否采用差异化度量方案? | 客服看一次解决率与转人工,研发看 DORA 与代码质量 | [ ] |
| 12 | 作弊防护 | 系统是否内置针对恶意刷 PR、刷行数的自动化过滤机制? | 自动剔除纯注释增减、格式化脚本等无效提交 | [ ] |
| 13 | 看板分层 | 效能仪表盘是否针对决策层、管理者与工程师进行视角分层? | 决策者看财务 ROI,总监看流转瓶颈,一线看个人心流诊断 | [ ] |
| 14 | 动态淘汰 | 是否具备基于度量结果的工具订阅动态退订与优选机制? | 对连续两个季度产生负向净收益的工具果断下线或替换 | [ ] |
| 15 | 组织文化 | 度量结果是否用于“发现系统阻碍”而非“惩罚个别员工”? | 树立良性的工程改进文化,严禁将度量变为内卷工具 | [ ] |
结语
在人工智能加速渗透企业日常生产的时代,“如何度量”决定了“走向何方”。如果我们继续沉溺于统计代码行数与对话频次的工业时代思维,AI 带来的就绝非真正的生产力飞跃,而是由海量技术债务、审查瘫痪与架构熵增堆砌而成的沉重包袱。
唯有建立起以真实业务流转为核心、以交付质量与技术韧性为红线、以工程师心流体验为依托、以全口径净财务回报为裁判的现代化度量网络,我们才能看清泡沫与价值的边界,让 AI 真正成为驱动组织长期核心竞争力的确定性杠杆。
如果在效能量化体系搭建、指标埋点治理或工具选型评估过程中遇到具体挑战,欢迎通过 联系我们 页面与技术顾问交流探讨。