在大模型技术深入业务系统的过程中,几乎每一个技术团队都会经历一段典型的认知摇摆:
项目初期,团队倾向于认为“只要 Prompt 写得足够精妙,加点 Few-Shot,再挂一个向量数据库(RAG),就能解决一切业务需求”。然而,当系统真正进入复杂生产场景——例如严苛的金融风控提取、专属代码 DSL 生成、高度定制的行业话术风格、或是每秒数百次的高并发轻量推理时,基于超长 Prompt 的方案往往会暴露出上下文开销爆炸、延迟高企、以及不可预测的格式漂移。
这时,团队很容易走向另一个极端:“我们需要微调自己的私有大模型”。于是匆忙采购高规格算力卡,盲目爬取数万条未清洗的业务数据,启动全参数或粗放的微调流程。几周后发现,训练出来的模型虽然在特定测试用例上看似有模有样,但通用推理能力急剧衰退(俗称“变傻”),甚至连基础的逻辑指令都无法遵循,最终项目只能草草收场。
大模型微调(Fine-Tuning)绝不是提示词工程的简单升级替代品,而是一项具有完全不同技术杠杆、工程成本与风险特性的系统工程。微调的核心价值,从来不是为了让模型像维基百科一样背诵新知识,而是为了在模型底层塑造特定的行为习惯、输出契约与专业推理链路。
本文将从工程落地的第一视角出发,系统梳理提示词工程、RAG 与微调的适用边界,拆解决定微调成败的数据工程与配比原则,详解以 LoRA/QLoRA 为代表的高效参数微调机制与算力估算公式,提供生产级的训练代码与评测门禁,并总结企业落地微调必须恪守的反模式与自检清单。
1. 路线选型:Prompt vs RAG vs Fine-Tuning 适用边界全景
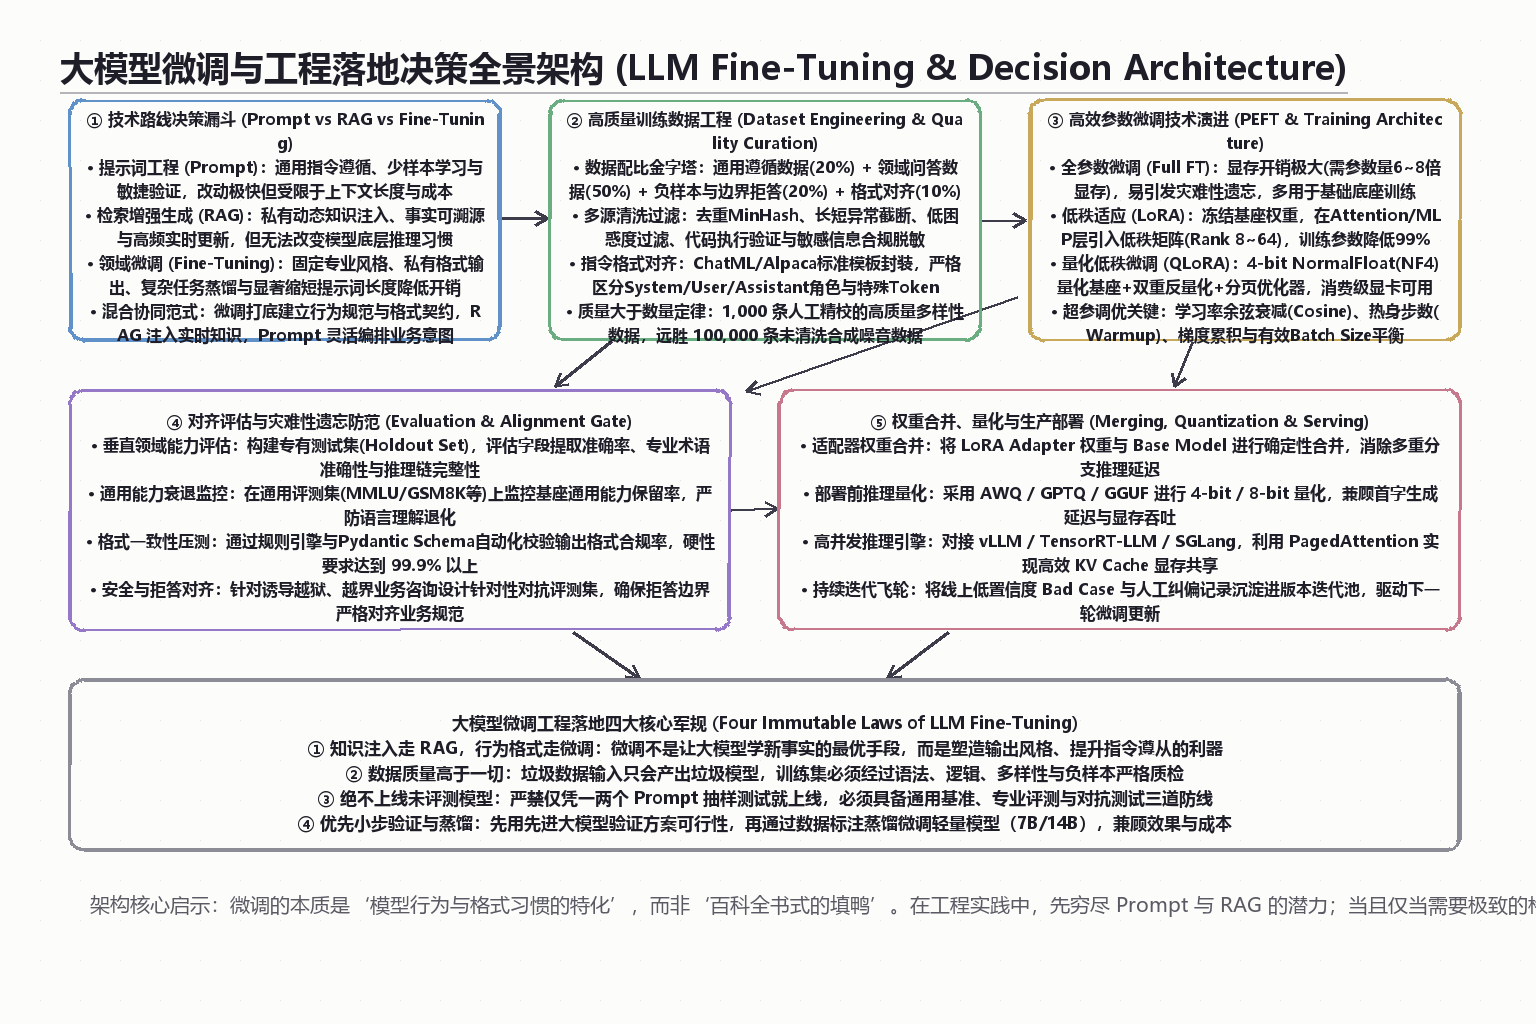
在决定敲下第一行训练脚本之前,首先必须搞清楚三项主流技术在架构中所处的位置。工程决策的核心在于:用最低的系统复杂度去满足业务的确定性要求。
1.1 三大路线的多维对比
| 评估维度 | 提示词工程 (Prompt Engineering) | 检索增强生成 (RAG) | 监督微调 (Supervised Fine-Tuning, SFT) |
|---|---|---|---|
| 核心解决的问题 | 快速验证意图、少样本引导、通用推理 | 私有动态知识检索、事实可溯源、知识库实时更新 | 固定输出格式、专业领域语气/风格、复杂任务指令蒸馏 |
| 知识更新频率 | 即时(修改 Prompt 即可生效) | 秒级/分钟级(文档分块入库即可检索) | 静态(需重新准备数据并训练迭代周期) |
| 知识注入能力 | 弱(受限于 Context Window 长度) | 极强(支持百万量级外挂私有知识库) | 极差(模型参数难以精准记忆孤立事实) |
| 输出格式确定性 | 中等(易受偶发长尾随机性扰动) | 依赖 Prompt 约束,存在格式漂移风险 | 极高(可将 Schema 习惯内化至模型权重中) |
| 单次推理 Token 成本 | 高(需携带长 System Prompt 与 Examples) | 极高(需拼接多段召回 Context 片段) | 极低(可用极简 Prompt 唤醒微调后的专门技能) |
| 工程启动门槛 | 极低(业务人员与工程师均可编写) | 中等(需维护向量库、分块、重排流水线) | 高(需数据标注清洗、GPU 算力栈、评估门禁) |
| 幻觉归因透明度 | 高(可审查 Prompt 本身) | 极高(可直接比对召回片段与生成结果) | 极低(黑盒权重更新,无法精准定位单个权重影响) |
1.2 三问决策漏斗
在团队讨论“要不要微调”时,建议使用以下三问漏斗进行快速否决与定性:
第一问:你的核心诉求是注入“高频更新的动态事实”,还是固化“长期稳定的行为范式”?
- 如果业务要求模型准确回答“昨天发布的最新采购政策”、“某用户的实时账户余额”、“上周更新的产品手册”,坚决不要用微调。大模型通过微调记忆新事实的效率极低,且极易产生虚假记忆;此时必须采用 RAG。
- 如果业务要求模型无论面对何种输入,都必须输出符合严格 RFC 规范的 JSON 数据、使用某种晦涩但严谨的内部 DSL 语言、或者统一使用带有特定专业修辞的客服风格,此时微调是最具确定性的解法。
第二问:你是否穷尽了 Prompt 优化、Few-Shot 与结构化输出(Structured Outputs)的潜力?
- 很多团队在微调前,连基础的提示词分层(System Role、任务边界、防幻觉约束、2~3 个精心设计的 Few-Shot 反例)都没有做扎实,就归咎于“通用模型不够聪明”。
- 现代前沿大模型具备强大的上下文学习(In-Context Learning)能力。如果用 5 个典型样例在最强模型上都无法得到稳定结果,说明任务本身的定义存在歧义,微调大概率只会把这种歧义固化放大。
第三问:你的业务量是否足够大,以至于微调带来的“推理成本节省”与“延迟降低”能覆盖训练成本?
- 微调可以将原本需要 3000 Token 上下文描述的业务规范,压缩到无需任何外部提示词,仅凭极简指令即可唤醒。如果系统每天有数百万次调用,长提示词带来的网络延迟与 Token 账单是惊人的。此时通过蒸馏与微调将任务固化到一个 7B 或 14B 的轻量开源模型上,经济收益将非常巨大。
2. 数据工程:决定微调上限的核心 80%
在学术界和工业界的共识中:微调的效果,80% 取决于训练数据的质量与配比,剩下的 20% 才取决于算法与超参数。
2023 年 Meta 发布的著名论文《LIMA: Less Is More for Alignment》证明了一个核心定理:仅使用 1,000 条高质量、精心编写的指令微调数据,就能训练出足以匹敌使用数万条未清洗数据微调的模型。输入垃圾数据,不仅无法提升模型性能,反而会迅速破坏模型的泛化与常识判断能力。
2.1 训练数据配比金字塔
一个健康的业务微调数据集,绝对不能只有单一任务的“用户提问-模型回答”,而应该呈现出科学的配比结构:
      [ 10% 格式与Schema硬约束数据 ]   --> 强校验、极端边缘输入下的确定性格式输出
    [ 20% 负样本与边界拒答数据 ]       --> 诱导越界、非业务范围内问题的礼貌拒答
  [ 50% 垂直领域核心业务正例数据 ]     --> 覆盖多样的真实业务场景与复杂推理链路
[ 20% 通用指令遵循与多轮对话数据 ] --> 防范灾难性遗忘,保留基础常识与语言逻辑- 通用指令遵循数据(约 20%):引入高质量的通用对话数据(如经过严格清洗的通用问答集)。这部分数据不产生垂直价值,但它是模型的“保鲜剂”,能有效防止模型在微调过程中丢失基本的语言理解和通用遵循能力。
- 领域核心业务正例(约 50%):覆盖核心业务场景。重点在于样本的多样性(Diversity),而非重复冗余。同一类问题由不同语气、不同语法结构表达,答案应当包含完整的思维推理过程(CoT),而不仅仅是单薄的结论。
- 负样本与边界拒答(约 20%):这是生产级微调与玩具项目的分水岭。如果只给正例,模型会被训练成“迎合型讨好者”,面对错误前提或攻击性 Prompt 依然胡乱作答。必须加入类似“用户询问非本公司产品”、“输入数据格式缺损无法解析”、“诱导模型发表违法违规言论”的样本,教导模型准确判断何时该返回错误码或拒答话术。
- 格式严格对齐数据(约 10%):针对极端长度、嵌套复杂列表、包含特殊字符的场景,训练模型对 JSON、XML 或特定标点符号的绝对遵从度。
2.2 数据清洗的四道工序
- 精确与模糊去重(Deduplication):
- 业务日志中往往存在大量重复提问。必须先通过 MD5 精确去重,再通过 MinHash + LSH(局部敏感哈希)进行语义相似度去重,去除相似度高于 0.85 的冗余样例,防止模型对高频短语产生病态过拟合。
- 长度分布与截断清洗:
- 统计 Prompt 与 Response 的 Token 长度分布。剔除过短的无意义回复(如“好的”、“收到”),对超长样本进行合理截断或重写,避免在训练批处理中因个别超长样本导致 Padding 空间过大、浪费显存算力。
- 基于困惑度(Perplexity)的质量过滤:
- 利用小模型对样本计算困惑度,自动筛除乱码、语法严重不通顺、机械机翻痕迹严重的低质文本。
- 敏感信息脱敏与合规脱钩:
- 通过正则表达式结合命名实体识别(NER),对真实业务数据中的手机号、身份证、银行卡、内部密码及商业机密进行不可逆脱敏替换。
2.3 标注模板规范:ChatML 结构与 Loss Masking
在构建 SFT 数据集时,必须遵循标准化的对话标记模板(如 ChatML),严格区分角色:
[
  {
    "messages": [
      {"role": "system", "content": "你是由专业机构认证的智能税务合规审查助手,负责按中国现行税法审查发票与报销凭证。"},
      {"role": "user", "content": "这张报销发票的税率为 6%,项目名称是‘信息技术服务’,但发票开具日期是周日,是否属于异常凭证?"},
      {"role": "assistant", "content": "根据现行增值税管理规范与企业报销合规通则,开票日期为周六或周日并不直接构成税务异常凭据,增值税开票系统全天候运行允许正常开具。但建议重点核实两个业务实质点:1. 实际技术服务交付记录与验收单周期是否与开票时间匹配;2. 开票方纳税人信用评级与经营状态是否正常。若实质合规,则凭证有效。"}
    ]
  }
]
必须注意的工程底线:Loss Masking(损失掩码)。在计算训练 Loss 时,只对 assistant 角色的输出计算交叉熵损失,绝对不能对 system 和 user 部分计算 Loss。如果对用户输入也计算损失,模型就会学着去预测用户的错别字和提问习惯,不仅极大地浪费模型容量,还会导致模型在推理时频繁模仿用户的提问风格,无法输出客观答案。
3. 高效参数微调演进:全参数 vs LoRA vs QLoRA
在参数量达到 7B、14B 乃至更大规模的今天,微调算法的工程权衡几乎完全围绕“显存与计算效率”展开。
3.1 全参数微调的显存开销解构
全参数微调(Full Fine-Tuning)需要更新模型的全部参数。在训练过程中,GPU 显存不仅仅用来存放模型参数本身:
对于一个拥有 $\Phi$ 个参数的模型,在采用最主流的 16 位混合精度(FP16/BF16)和 AdamW 优化器进行全参数训练时,显存构成如下:
- 模型权重(Weights):$2 \times \Phi$ 字节(FP16/BF16)
- 梯度(Gradients):$2 \times \Phi$ 字节(FP16/BF16)
- AdamW 优化器状态(Optimizer States):包含 FP32 权重副本(4 字节)+ 一阶动量 Momentum(4 字节)+ 二阶动量 Variance(4 字节)= $12 \times \Phi$ 字节
- 合计静态显存:仅参数与优化器就需要 $16 \times \Phi$ 字节。
对于一个 7B 参数的模型,静态显存开销高达 $7 \times 16 \text{ GB} = 112 \text{ GB}$;加上上下文激活值(Activation Memory),全参数微调至少需要 2 到 4 张 80GB 显存的高规格 GPU。这对于普通企业而言成本门槛极高。此外,全参数更新极易重写原有的注意力权重分布,造成严重的通用能力遗忘。
3.2 LoRA:低秩适应的数学精髓与超参法则
微软提出的 LoRA (Low-Rank Adaptation) 彻底改变了这一格局。
核心数学原理
LoRA 基于一个深刻的经验假设:大模型权重矩阵在执行特定下游任务微调时,其参数更新的内在秩(Intrinsic Rank)远小于全维度空间。
对于一个预训练权重矩阵 $W_0 \in \mathbb{R}^{d \times k}$,LoRA 将其参数更新量 $\Delta W$ 分解为两个极低维度的低秩矩阵乘积:
$$\Delta W = B \times A$$
其中 $A \in \mathbb{R}^{r \times k}$,$B \in \mathbb{R}^{d \times r}$,秩 $r \ll \min(d, k)$。
 [ 原始权重 W0 (冻结,无梯度) ]
             │
x ───────────┼───────────> (+) ───> y = W0*x + (α/r)*B*A*x
             │              ▲
             └───[ 矩阵 A ]─┘ (降维: k -> r, 高斯初始化)
                       │
[ 矩阵 B ] (升维: r -> d, 全零初始化)- 在训练开始时,矩阵 $A$ 采用高斯随机初始化,矩阵 $B$ 采用全零初始化。这保证了在第 0 步时 $B \times A = 0$,模型的初始输出与未经微调的基座完全一致。
- 基座权重 $W_0$ 全程被冻结,不计算梯度,也不需要为它们分配 AdamW 的优化器状态。
- 最终实际参数变化通过可调缩放系数进行缩放:$W_{\text{final}} = W_0 + \frac{\alpha}{r} (B \times A)$。
关键超参数的选择法则
- 秩(Rank, $r$):通常在 $8$ 到 $64$ 之间选择。
- 对于格式规范、对话风格等简单结构任务,$r=8$ 或 $r=16$ 即可提供足够的表达能力;
- 对于涉及特定行业逻辑推理(如代码、数学、医疗诊断),建议设为 $r=32$ 或 $r=64$。
- 盲目增大 $r$(如设为 128 或 256)通常不会带来显著收益,反而会大幅增加训练时间,增加过拟合风险。
- 缩放系数(Alpha, $\alpha$):业界经验通常设定为 $\alpha = 2 \times r$ 或 $\alpha = r$。一旦固定了 $\alpha/r$ 的比值,可以在调整 $r$ 时保持学习率尺度的相对稳定。
- 目标模块(Target Modules):早期 LoRA 仅微调 Attention 模块中的 $q_proj$ 与 $v_proj$。但实践表明,将 LoRA 挂载到所有线性投影层($q, k, v, o, gate, up, down_proj$),虽然参数量略微增加,但收敛速度和最终表现显著优于局部挂载。
3.3 QLoRA:消费级显卡的工业奇迹
华盛顿大学提出的 QLoRA (Quantized Low-Rank Adaptation) 在 LoRA 基础上引入了三项关键技术,使得在单张主流消费级显卡(例如 16GB/24GB 显存)上微调 7B~14B 模型成为现实:
- 4-bit NormalFloat (NF4) 数据类型:
- 针对正态分布的模型权重设计的最优信息论量化类型。相比普通的 4-bit 整数(FP4/INT4),NF4 能最大程度保留 FP16 权重的精度,几乎不产生量化失真。
- 双重反量化(Double Quantization):
- 对量化时产生的常量常数(Quantization Constants)再进行一次 8-bit 量化,使得每个参数平均仅占用 0.127 字节的额外量化元数据。
- 分页优化器(Paged Optimizers):
- 利用统一内存技术,当显存因为超长样本出现瞬时峰值时,自动将优化器状态逐页交换到系统内存(CPU RAM)中,彻底避免 CUDA Out of Memory (OOM) 崩溃。
3.4 方案选型与显存对照矩阵
| 微调方案 | 适用模型尺寸 | 训练参数占比 | 7B 模型训练所需显存 | 14B 模型训练所需显存 | 性能保留度 | 适用场景 |
|---|---|---|---|---|---|---|
| 全参数微调 | 任意(需多卡并行) | 100% | 80GB ~ 120GB+ | 160GB ~ 240GB+ | 理论上限最高,但极易遗忘 | 底座基座预训练、拥有海量算力的大厂 |
| 标准 LoRA (FP16) | 7B ~ 70B+ | 0.1% ~ 1% | 20GB ~ 28GB | 36GB ~ 48GB | 接近全参数(98%+) | 拥有企业级 GPU(A100/H800/L40S)的生产训练 |
| QLoRA (4-bit) | 7B ~ 70B+ | 0.1% ~ 1% | 10GB ~ 14GB | 16GB ~ 22GB | 极其接近 LoRA(96%+) | 预算受限团队、单卡消费级 GPU 快速验证与迭代 |
4. 工业级微调工程实战:代码架构与核心流水线
下面提供一套基于现代开源微调技术栈(**Hugging Face transformers + peft + trl**)的工业级微调参考代码。该代码采用 QLoRA 4-bit 方案,集成了完整的数据格式化、LoRA 参数声明、余弦退火学习率以及 Checkpoint 管理。
# -*- coding: utf-8 -*-
"""
LLM Fine-Tuning Pipeline: Production-Ready QLoRA Implementation
依赖库: pip install torch transformers peft trl datasets bitsandbytes accelerate
"""

import os
import torch
from datasets import load_dataset
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    BitsAndBytesConfig,
    TrainingArguments
)
from peft import (
    LoraConfig,
    get_peft_model,
    prepare_model_for_kbit_training
)
from trl import SFTTrainer, SFTConfig

def run_fine_tuning(
    model_name_or_path: str = "Qwen/Qwen2.5-7B-Instruct",
    dataset_file: str = "data/business_sft_dataset.jsonl",
    output_dir: str = "output/qwen2.5_lora_adapter",
):
    print(f"[*] 正在初始化微调任务,基座模型: {model_name_or_path}")

    # 1. 声明 4-bit NormalFloat (NF4) 量化配置
    bnb_config = BitsAndBytesConfig(
        load_in_4bit=True,
        bnb_4bit_quant_type="nf4",
        bnb_4bit_compute_dtype=torch.bfloat16,
        bnb_4bit_use_double_quant=True,
    )

    # 2. 加载分词器并对齐 Padding 规则
    tokenizer = AutoTokenizer.from_pretrained(
        model_name_or_path,
        trust_remote_code=True,
        use_fast=True
    )
    if tokenizer.pad_token is None:
        tokenizer.pad_token = tokenizer.eos_token
    tokenizer.padding_side = "right"  # 因因果LM要求避免自回归生成时受左侧影响

    # 3. 加载量化基座模型
    model = AutoModelForCausalLM.from_pretrained(
        model_name_or_path,
        quantization_config=bnb_config,
        device_map="auto",
        trust_remote_code=True,
        torch_dtype=torch.bfloat16,
    )

    # 4. 准备 k-bit 训练并声明 LoRA 配置
    model = prepare_model_for_kbit_training(model)

    peft_config = LoraConfig(
        r=16,                         # 秩大小
        lora_alpha=32,                # 缩放因子
        lora_dropout=0.05,            # 防止小样本过拟合
        bias="none",
        task_type="CAUSAL_LM",
        target_modules=[              # 挂载至全部线性层以获取最佳泛化效果
            "q_proj", "k_proj", "v_proj", "o_proj",
            "gate_proj", "up_proj", "down_proj"
        ]
    )

    model = get_peft_model(model, peft_config)
    model.print_trainable_parameters()

    # 5. 加载数据并定义格式化映射
    dataset = load_dataset("json", data_files=dataset_file)["train"]

    def formatting_prompts_func(example):
        """
        利用分词器内置的 ChatML 模板统一将 messages 转换为包含正确 Special Tokens 的纯文本
        """
        text = tokenizer.apply_chat_template(
            example["messages"],
            tokenize=False,
            add_generation_prompt=False
        )
        return {"text": text}

    formatted_dataset = dataset.map(formatting_prompts_func)

    # 6. 配置训练参数
    training_args = SFTConfig(
        output_dir=output_dir,
        num_train_epochs=3,
        per_device_train_batch_size=4,
        gradient_accumulation_steps=4,  # 等效 Batch Size = 4 * 4 = 16
        optim="paged_adamw_8bit",       # 使用分页 8 位优化器,极限压缩显存
        save_strategy="steps",
        save_steps=100,
        logging_steps=10,
        learning_rate=2e-4,             # LoRA 标准学习率通常在 1e-4 到 3e-4 之间
        lr_scheduler_type="cosine",     # 余弦退火调度
        warmup_ratio=0.03,              # 3% 的热身步数
        weight_decay=0.01,
        fp16=False,
        bf16=True,                      # 现代显卡优先使用 bf16 避免梯度溢出
        max_seq_length=2048,            # 设定合理的上下文截断长度
        dataset_text_field="text",
        report_to="none"                # 生产环境可对接 wandb 或 tensorboard
    )

    # 7. 启动训练
    trainer = SFTTrainer(
        model=model,
        train_dataset=formatted_dataset,
        peft_config=peft_config,
        args=training_args,
    )

    print("[*] 开始执行 SFT 训练流程...")
    trainer.train()

    # 8. 保存训练完毕的 LoRA Adapter 权重
    print(f"[*] 训练完成,正在持久化 Adapter 权重至: {output_dir}")
    trainer.model.save_pretrained(output_dir)
    tokenizer.save_pretrained(output_dir)
    print("[✔] 微调流水线执行完毕。")

if __name__ == "__main__":
    # 执行前请确保已准备好 data/business_sft_dataset.jsonl 文件
    # run_fine_tuning()
    pass
关键工程技巧要点
- Gradient Accumulation(梯度累加):
- 很多开发者在单卡显存不足时,将
batch_size设为 1 或 2,导致梯度估算噪音极大、损失曲线剧烈震荡无法收敛。通过设置gradient_accumulation_steps=4或更大,可以在不增加显存消耗的前提下,模拟出 16 或 32 的有效 Batch Size,保证模型平稳收敛。
- 很多开发者在单卡显存不足时,将
- Flash Attention 2 集成:
- 如果硬件支持(Ampere 架构及以上),务必开启
attn_implementation="flash_attention_2"。这能将长文本注意力的内存复杂度从 $O(N^2)$ 降低为线性显存占用,训练吞吐量可提升 2~3 倍。
- 如果硬件支持(Ampere 架构及以上),务必开启
- 分词器对齐(Tokenizer Consistency):
- 微调所使用的分词器特殊 Token(如
<|im_start|>,<|im_end|>等),必须与推理部署阶段使用的分词器完全一致。任何特殊 Token 索引的微小错位,都会导致微调后的模型在推理阶段输出乱码。
- 微调所使用的分词器特殊 Token(如
5. 对齐评估与灾难性遗忘防范体系
没有科学量化评测的微调,就像闭着眼睛在悬崖边开车。
行业中常见的反面教材是:工程师训完模型后,在 Web 界面随手输入两道业务问题,看模型回答得很流畅,就兴奋地宣称“微调成功,准备上线”。上线后才发现,模型面对稍微变形的问题就输出格式崩溃,或者连基本的加减乘除都无法算对。
生产级微调必须建立严格的三层评估门禁(Evaluation Gate):
[ 线上发布准入门禁 ]
       ▲
       ├── 门禁 1: 垂直任务表现 (Holdout Set 准确率 ≥ 92%)
       ├── 门禁 2: 输出格式契约 (Pydantic Schema 解析率 ≥ 99.9%)
       └── 门禁 3: 通用能力衰退 (通用基准 MMLU/GSM8K 衰退率 ≤ 3%)
5.1 门禁 1:垂直任务黄金测试集(Holdout Dataset)
- 数据绝对隔离:在数据准备阶段,必须提前预留 10%~15% 的测试样本,绝对严禁将这部分数据参与任何形式的训练与调参。
- 全自动化客观指标:
- 分类/提取类任务:计算 Precision, Recall, F1-Score;
- 自由文本生成类任务:不要依赖易受表面词汇影响的 ROUGE/BLEU,建议采用先进大模型充当裁判(LLM-as-a-Judge),按照标准五维打分卡(事实准确性、完整性、修辞风格、无冗余度、安全边界)进行双盲打分。
5.2 门禁 2:输出格式契约自动化压测
如果微调目标是输出结构化数据(如 JSON/YAML/SQL),必须编写自动化测试脚本,抽取 1,000 个未见过的输入案例让模型生成结果,并立即通过强类型校验库(如 Pydantic)进行解析断言:
import json
from pydantic import BaseModel, Field, ValidationError

class BusinessAuditResult(BaseModel):
    risk_level: str = Field(pattern="^(LOW|MEDIUM|HIGH|CRITICAL)$")
    risk_factors: list[str]
    compliance_score: int = Field(ge=0, le=100)
    suggested_action: str

def verify_format_compliance(model_outputs: list[str]) -> float:
    success_count = 0
    for raw_text in model_outputs:
        try:
            # 清理可能的 markdown 代码块标记
            clean_json = raw_text.strip().removeprefix("```json").removesuffix("```").strip()
            data = json.loads(clean_json)
            BusinessAuditResult(**data)
            success_count += 1
        except (json.JSONDecodeError, ValidationError):
            continue
    compliance_rate = success_count / len(model_outputs)
return compliance_rate在工业级流水线中,Schema 解析合规率达不到 99.9% 坚决不允许上线。
5.3 门禁 3:灾难性遗忘监控(Catastrophic Forgetting Audit)
所谓“灾难性遗忘”,是指模型在学好新任务的同时,原有的常识逻辑、数学推理和通用阅读理解能力发生不可逆的退化。
防范与监控手段:
- 基线监控:在微调前,在通用公共基准(如 MMLU 语言理解、GSM8K 数学推理、HumanEval 代码能力)的子集上对基座模型打分,记录基线分数 $S_{\text{base}}$。
- 衰退红线:微调后再次运行相同评测,计算衰退比例 $\Delta = \frac{S_{\text{base}} - S_{\text{tuned}}}{S_{\text{base}}}$。如果 $\Delta > 3%$,说明微调破坏了底层通用能力,必须退回排查。
- 应对良方:如果发生遗忘,最有效的解决策略不是调小学习率,而是在训练集混合 15%~25% 的通用多领域对话数据(Data Replay)。通用数据犹如给模型提供了锚点,能有效抵消特定领域微调带来的表征漂移。
6. 权重合并、推理量化与生产部署
微调完成后产出的通常是一批几百兆字节的 LoRA Adapter 权重(即低秩矩阵 $A$ 与 $B$)。在上线服务阶段,如何高效部署决定了端到端的系统延迟。
6.1 适配器权重确定性合并(Merge and Unload)
在生产环境中,不要在推理服务中动态挂载 LoRA 分支。动态计算 $W_0 \cdot x + \frac{\alpha}{r} B \cdot A \cdot x$ 会引入额外的矩阵乘法算子与 Kernel Launch 开销,导致首字延迟(TTFT)显著增加。
标准做法是在发布前,将 LoRA 权重离线永久融合回基座权重中:
from transformers import AutoModelForCausalLM, AutoTokenizer
from peft import PeftModel
import torch

def export_merged_model(
    base_model_path: str,
    adapter_path: str,
    export_dir: str
):
    print("[*] 正在加载基座与 Adapter 权重...")
    # 必须以 FP16/BF16 全精度加载基座模型进行权重融合
    base_model = AutoModelForCausalLM.from_pretrained(
        base_model_path,
        torch_dtype=torch.bfloat16,
        device_map="cpu",  # 在 CPU 或单卡均可操作
        trust_remote_code=True
    )
    tokenizer = AutoTokenizer.from_pretrained(base_model_path, trust_remote_code=True)

    # 挂载 LoRA 并执行确定性合并
    model = PeftModel.from_pretrained(base_model, adapter_path)
    merged_model = model.merge_and_unload()
    print("[*] 权重合并完毕,正在保存融合后的独立完整模型...")

    merged_model.save_pretrained(export_dir, max_shard_size="4GB")
    tokenizer.save_pretrained(export_dir)
    print(f"[✔] 独立模型已就绪,保存至: {export_dir}")
融合后的模型变成了一个标准架构的独立模型,没有任何额外的计算分支,下游推理引擎可以将其视作普通开源模型直接接管。
6.2 推理引擎与量化选型
合并后的模型进入部署流水线,此时应根据性能指标要求选择合适的推理方案:
- 部署引擎选择:
- 现代生产环境严禁使用 Hugging Face 原生
pipeline进行并发推理。 - 推荐使用 vLLM 或 TensorRT-LLM。以 vLLM 为例,其核心的 PagedAttention 技术彻底消除了 KV Cache 的显存碎片化,使得并发处理吞吐量能够提升 5 到 10 倍。
- 现代生产环境严禁使用 Hugging Face 原生
- 推理量化算法选型:
- **AWQ (Activation-aware Weight Quantization)**:目前工业界首推的 4-bit 量化方案。AWQ 会保护那 1% 极具语义价值的显著权重(Salient Weights)不做过度量化,在 4-bit 下几乎保持了与 FP16 相同的困惑度,显存减半且推理吞吐大幅提升。
- GPTQ:成熟稳定的 4-bit 量化方案,在各类开源推理生态中兼容性最佳。
- GGUF / llama.cpp:针对 CPU 与端侧设备(Edge Devices)量化的标准格式,适合轻量级私有化边缘部署。
7. 大模型微调 5 大高危反模式避坑指南
许多团队在微调踩坑,往往不是因为代码写错了,而是因为触犯了认知层面的反模式。以下总结了生产中最容易导致灾难的 5 大误区:
反模式 1:把微调当成外挂知识库(知识填鸭陷阱)
- 错误表现:公司上线了新业务规章制度,整理了 500 页内部 PDF,直接切成问答对拿去微调模型,试图让模型把所有政策条款死记硬背下来。
- 后果:大模型微调吸收孤立事实知识的效率极低。模型不仅无法做到精准引用,反而会在被问及条款细节时,自信地将第 3 条与第 18 条杂糅在一起胡编乱造,产生极其隐蔽的“幻觉”。
- 正确姿势:“记忆知识走 RAG,规约行为走微调”。将政策原文放入向量库和全文搜索引擎,让模型通过检索召回事实片段;微调仅用来教模型“如何根据参考材料提取结论”、“如何以公司标准公文格式回答”。
反模式 2:全量输入计算损失(Loss 计算未做 Mask)
- 错误表现:在准备 SFT 训练代码时,直接将整段对话拼接后作为标签传入模型,使模型对 Prompt 和 Response 同时计算 Loss。
- 后果:模型把大量的参数容量浪费在“拟合用户的提问语气”上。如果训练集中用户的提问口语化严重、带有拼写错误或情绪化词汇,微调后的模型在推理阶段会不可控地出现反问、自言自语甚至模仿用户的语气失控。
- 正确姿势:严格使用 Data Collator 将 User Prompt 部分的 Label 替换为
-100(PyTorch 交叉熵损失函数默认忽略-100),强制模型仅针对 Assistant 输出部分反向传播梯度。
反模式 3:过拟合单一 Prompt 模板(脆弱泛化陷阱)
- 错误表现:训练集里的 5,000 条样本,全部使用一字不差的 System Prompt,或者 User 提问开头全部都是“请帮我分析以下发票:”。
- 后果:模型对这一串特定字符形成了强烈的模式识别依赖。一旦上线后真实用户少输入了一个字,或者换了一个开场白(例如“这张发票你看下合规吗”),模型的性能发生断崖式下跌,完全无法触发预期的微调能力。
- 正确姿势:在数据预处理阶段执行 Prompt 扰动与多样化数据增强。为同一个任务设计 10 种以上不同的 System Prompt 模板,并对 User 输入引入同义词替换、语法结构倒装和多轮对话混搭,迫使模型学会理解任务实质而非机械记忆模板前缀。
反模式 4:盲目追求大 Rank(参数贪婪陷阱)
- 错误表现:认为“Rank 设得越大模型越聪明”,在微调一个简单的格式抽取任务时,直接把 LoRA 的 $r$ 设为 128 甚至 256。
- 后果:过大的 Rank 引入了过量的可训练参数,在样本量有限的情况下极其容易引发过拟合;同时显存占用剧增,训练吞吐降低,且最终泛化表现往往不如 $r=16$。
- 正确姿势:始终秉持“先小后大、从紧原则”。普通业务格式与行为对齐,优先从 $r=8$ 或 $r=16$ 开始;只有当评测集上的指标确实因容量受限无法上升时,再尝试递增到 $r=32$。
反模式 5:完全缺失负样本与拒答样本(好好先生陷阱)
- 错误表现:训练集全是“完美的业务问答”,没有一条针对越权访问、缺失参数、恶意越狱或非业务范围的负例。
- 后果:模型丧失了业务边界感。当用户传入一段完全损坏的报销单据时,模型依然硬着头皮编造合规结论;当用户试图用提示注入技巧刺探模型后台时,模型有问必答,引发严重的安全风控事故。
- 正确姿势:在训练集中硬性分配 15%~20% 的负样本、异常数据及合规拒答示例,培养模型“在必要时礼貌拒答并输出标准错误码”的工程自觉。
8. 企业级大模型微调 15 项生产上线自检清单
在将微调后的模型发布到生产集群之前,请技术负责人和架构师逐项核对以下 15 项核心指标:
一、数据工程与合法性合规
- 1. 数据去重与多样性:训练集是否通过 MinHash 进行了语义去重,且没有出现单一提问模板占比超过 5% 的情况?
- 2. 负样本与拒答覆盖:数据集是否包含了至少 15% 的边界测试用例、格式错误输入及合规拒答样本?
- 3. 敏感数据不可逆脱敏:所有真实业务样本是否已彻底剥离 PII(个人身份信息)、商业机密与鉴权凭据?
- 4. 损失掩码严格执行:数据 Collator 是否对 User 与 System 提示词完全执行了
-100的 Loss Masking,确保只对 Assistant 计算梯度?
二、训练稳定性与参数配置
- 5. 特殊 Token 对齐校验:训练时所用的 Chat 模板及特殊标记(BOS/EOS/Pad)是否与目标推理框架完全一致?
- 6. 批大小与学习率匹配:是否配置了合理的梯度累加步长(有效 Batch Size ≥ 16),避免小 Batch 导致的梯度噪声震荡?
- 7. 精度规范与防溢出:是否全程使用
bf16(而非容易下溢的fp16)进行计算,并配置了梯度裁剪(Gradient Clipping ≤ 1.0)?
三、评测门禁与防遗忘验证
- 8. 独立测试集绝对隔离:是否使用从未参与训练的 Holdout 测试集进行了客观量化评测?
- 9. 输出 Schema 严格解析压测:在 1,000+ 随机测试样本下,Pydantic / 结构化解析成功率是否稳定达到 99.9% 以上?
- 10. 通用能力衰退审计:在通用语言与推理评测基准上,微调模型的性能相对基座模型的衰退率是否严格控制在 3% 以内?
四、权重处理与部署架构
- 11. 离线合并完成:LoRA 适配器权重是否已通过
merge_and_unload()彻底融合回基座,避免在线分支计算开销? - 12. 推理量化无损验证:若采用了 AWQ/GPTQ 4-bit 量化,是否在领域评测集上复测了量化前后的输出一致性?
- 13. 高性能推理引擎接入:服务是否已接入基于 PagedAttention 的高性能框架(如 vLLM/TensorRT-LLM),并完成了并发压力测试?
五、安全防护与数据飞轮
- 14. 提示注入对抗测试:模型是否经过常见的越狱与系统提示词窃取攻击测试,且表现出足够的防护韧性?
- 15. 线上 Bad Case 收集闭环:生产环境是否具备对低置信度、用户点踩、格式解析失败请求的自动化归档通道,以便纳入下一期版本迭代?
结语:让技术回到解决业务问题的原点
大模型微调不是炫耀算法复杂度的橱窗,而是一柄锋利却极其考验刀法的双刃剑。
盲目追求微调,往往会在无尽的数据清洗、GPU 算力耗费和灾难性遗忘中消耗团队的耐心;而过度迷信单纯的 Prompt,又容易在严苛的商业化场景中受制于延迟与偶发漂移。
真正成熟的 AI 架构,懂得在三者之间构建优雅的协同闭环:用微调打底,塑造一个懂行话、守规矩、输出格式严谨且低延迟的轻量核心底盘;用 RAG 注入新鲜血液,让系统在不重训模型的前提下敏捷同步海量业务事实;用精心设计的提示词作为前线调度官,灵活编排用户的瞬时意图。
唯有如此,AI 系统才能真正摆脱 Demo 阶段的脆弱,蜕变成为企业业务中坚不可摧的工程化生产力。
如果您在企业大模型私有化部署、微调数据工程、RAG 检索流水线优化或高并发推理落地中遇到具体的架构挑战,欢迎前往 TypeTube 读者交流与技术咨询 页面与我们展开深入探讨。