在生成式 AI 与大语言模型(LLM)的应用落地浪潮中,绝大多数技术团队都会经历一个极其残酷的“阶段鸿沟”:在本地写几段提示词、调用几次 API,或者搭一个基于 LangChain 的 Demo,通常只需要几天甚至几个小时;但当这个系统真正接入生产业务、面对成千上万真实用户的随机输入时,系统的脆弱性便会暴露无遗。
线上偶发胡言乱语的幻觉、某次 Prompt 优化导致原本能回答的问题突然无法解析、模型响应延迟无规律地飙升到 15 秒以上、API 账单在月结时毫无预警地翻倍……面对这些生产灾难,习惯了传统应用监控(APM)的后端与运维工程师往往会感到前所未有的无力。
传统微服务的可观测性体系(如 Prometheus、SkyWalking、Datadog 等)是建立在确定性代码执行基础之上的——只要函数输入确定,其调用链路与输出状态即可预测,异常通常表现为明确的 HTTP 500、空指针崩溃或超时中断。然而,大模型是一个本质上的概率黑盒:即使返回了 HTTP 200,其内容可能完全是捏造的事实;甚至两次完全相同的输入,由于温度系数、动态采样或底层分布式推理环境的微小差异,也会吐出结构迥异的结果。
如何打破这个概率黑盒?如何像监控微服务一样,看清大模型每一次调用的内部细节、在线拦截低劣回答,并在版本演进中建立起不可逾越的自动化质量门禁?本文将系统拆解大模型可观测性(LLM Observability)与质量工程的核心体系,提供从链路追踪、在线监控、离线评测到 CI/CD 门禁的全套可落地实践。
一、传统可观测性为什么对大模型“失明”?
在深入架构之前,必须先厘清大语言模型应用在可观测性层面的四个本质转变。认识不到这些转变,团队就会继续在旧有工具链上缝缝补补,最终走向盲人摸象。
1. 从“状态码判定”转向“语义质量判定”
在传统系统中,接口返回 HTTP 200 OK 几乎就意味着业务成功。但在 LLM 应用中,HTTP 200 仅仅代表 API 通信正常。模型可能返回了一段逻辑混乱的胡话、捏造了一个不存在的法律条款,甚至触发了越狱违规指令。传统的 APM 无法通过正则或简单的字符串匹配看懂长文本背后的事实性(Factuality)与忠实度(Faithfulness)。
2. 从“单体链路”转向“多阶段复合概率管道”
现代大模型应用绝非简单的 Input -> Model -> Output。典型的生产架构(如高级 RAG 或 Agentic 架构)包含:用户意图重写 -> 关键词提取 -> 向量相似度检索 -> Cross-Encoder 语义重排 -> 动态上下文剪枝与装配 -> 模型推理生成 -> 结构化 JSON 提取 -> 工具/代码沙箱执行 -> 最终护栏拦截。
当用户抱怨“回答不准”时,到底是检索没召回有效文档?还是重排阶段把正确答案排到了后面?是提示词引导产生了误导?还是模型自身发生了参数漂移?如果缺少跨阶段的细粒度追踪(Span Tracing),排查故障就如同大海捞针。
3. 从“纯时间耗时度量”转向“双重延迟与 Token 经济学”
传统后端系统主要关注接口的总耗时(Latency)与 QPS。而对于流式输出(Streaming)的大模型系统,总耗时往往无法真实反映用户体验。必须解耦为两个核心指标:
- 首字生成延迟(TTFT, Time to First Token):决定了用户的感知卡顿感,受 Prompt 长度、排队时间与首块生成速度影响;
- 每 Token 吐字延迟(TPOT, Time Per Output Token):反映推理吞吐能力,决定了打字机动画的流畅度。
同时,每次请求的输入 Token、输出 Token 与缓存命中状态,直接对应着真实的财务成本与限流配额。没有 Token 级别的细粒度监控,成本优化就无从谈起。
4. 从“手动抽测”转向“确定性回归评估”
在传统软件开发中,改动一段代码只需运行单元测试套件(Unit Tests),通过即可上线。但在大模型系统中,工程师“优化”了系统提示词中的某一句话,往往在测试的 5 个用例中表现良好,却在未测试的另外 50 个业务场景中引发严重的语义退化(Regression)。缺少自动化的黄金评测集与门禁系统,Prompt 的每次提交都无异于在生产环境“裸奔”。
二、大模型可观测性的三大核心支柱
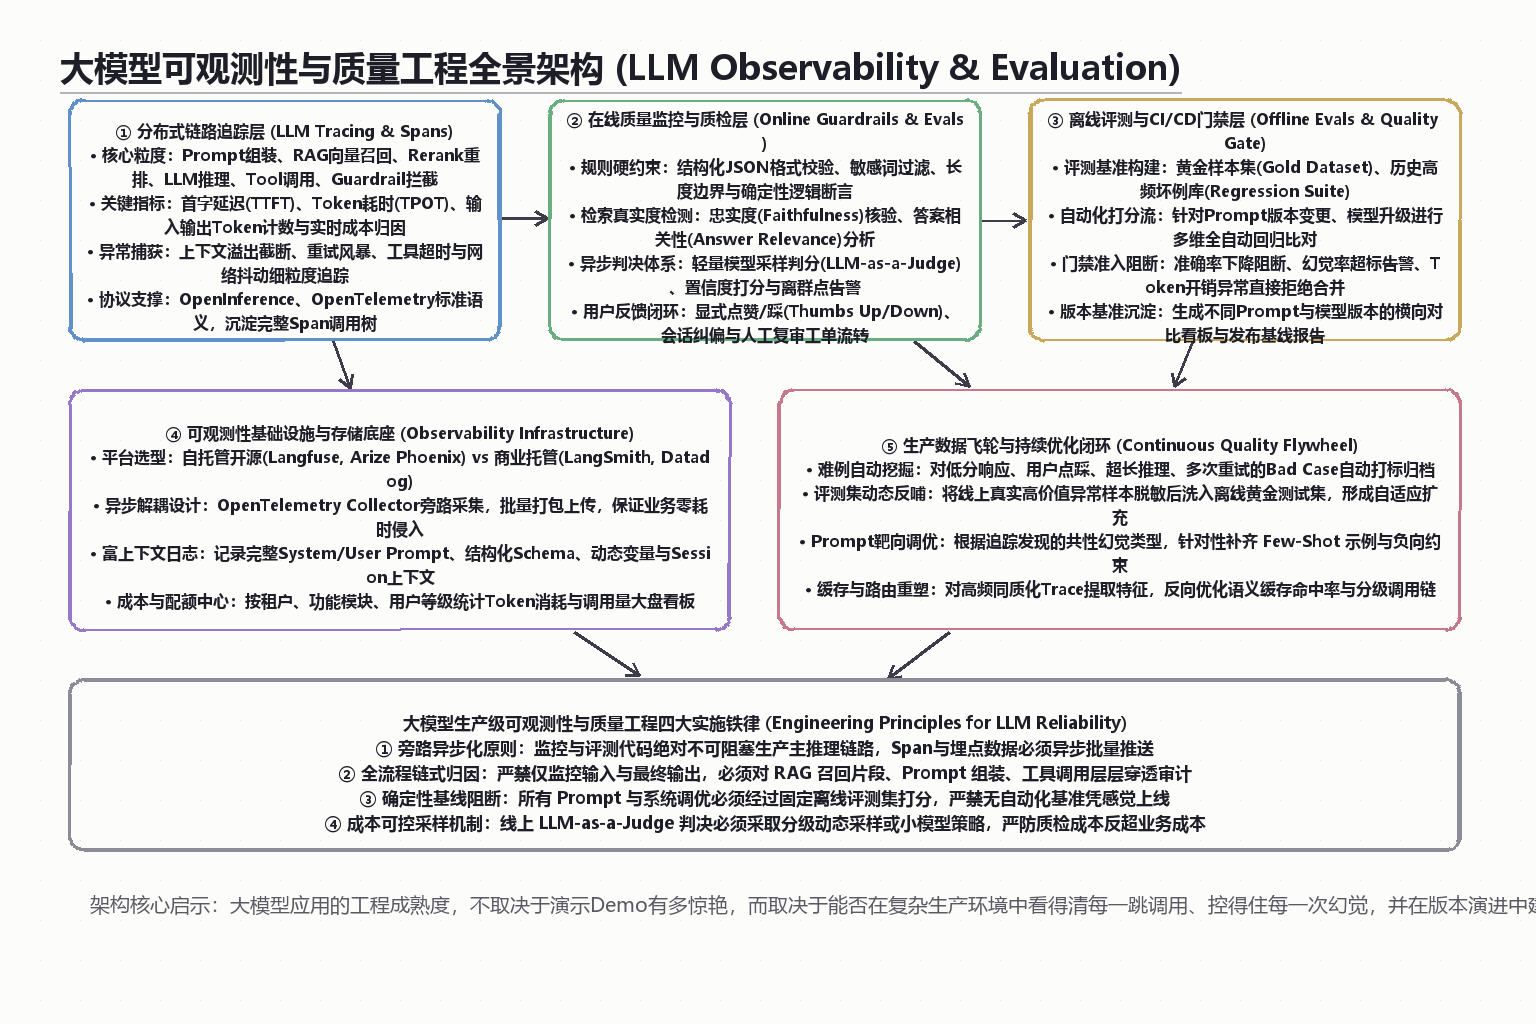
针对上述挑战,现代 LLMOps 衍生出了大模型可观测性与可靠性的三大核心支柱:链路追踪(Tracing)、指标与审计(Metrics & Cost) 以及 质量评估与护栏(Evaluation & Guardrails)。
+-----------------------------------------------------------------------------------+
|                        大模型可观测性与可靠性三大核心支柱                          |
+-----------------------------------------------------------------------------------+
|                                                                                   |
|  1. 链路追踪 (Tracing)             2. 指标与审计 (Metrics)    3. 评测护栏 (Evals)  |
|  ├── 阶段 Span 树 (RAG/LLM/Tool)   ├── 性能: TTFT / TPOT      ├── 在线: 规则/语义护栏 |
|  ├── 上下文快照 (Prompt/IO)        ├── 吞吐: Token 计数与利用 ├── 离线: 黄金评测集    |
|  └── 异常与重试根因透视            └── 成本: 租户级账单分摊   └── 门禁: CI/CD 回归阻断|
|                                                                                   |
+-----------------------------------------------------------------------------------+
支柱一:分布式链路追踪(Distributed Tracing)
链路追踪是大模型系统排错的基石。在 OpenInference 或 OpenTelemetry 的大模型语义规范下,一次用户的顶层交互(Trace)会被切分为树状的嵌套片段(Span):
- Retriever Span:记录检索查询词、召回文档数量、Top-K 相似度分数分布;
- Reranker Span:记录输入前后的文档重排排序差异与置信度变化;
- LLM Call Span:记录完整的 System/User Prompt、模型名称、温度系数、输入/输出 Token 数,以及原始推理响应文本;
- Tool Execution Span:记录模型生成的参数(Arguments)、外部工具执行结果、耗时及是否抛出超时异常;
- Guardrail Span:记录安全风控规则的匹配情况与阻断原因。
通过这样层层穿透的调用树,工程师可以在后台直观看到用户每一次吐槽背后的完整上下文还原。
支柱二:黄金指标与成本分摊(Metrics & Cost Attribution)
大模型系统的指标看板必须兼顾技术性能与商业成本:
- 用户体验黄金指标:P50 / P90 / P99 的 TTFT(首字延迟)、TPOT(吐字延迟)、端到端完成时间;
- 资源与系统健康指标:API 错误率(429 限流、502 网关错误、504 超时)、上下文长度分布(防止接近模型上下文窗口极限引发的截断风险);
- Token 经济学与成本:每日总消耗 Token 数、Prompt Token vs Completion Token 比例、上下文缓存(KV Cache / Prefix Caching)命中率、分租户/分功能模块的成本归因。
支柱三:全生命周期评测与护栏(Evaluation & Guardrails)
评估不是一次性的离线任务,而是贯穿在开发、上线与运行全流程的闭环:
- 在线护栏(Online Guardrails):作为主推理链路的守门人,执行实时结构化解析、幻觉检测与敏感词拦截;
- 离线评测(Offline Evaluation):在开发阶段与 CI/CD 流程中,使用标准测试集量化对比不同模型版本、不同 Prompt 设计的得分波动;
- 难例回流(Data Flywheel):将线上触发告警或用户点踩的真实案例,自动沉淀为新的离线评测集测试用例。
三、主流 LLM 可观测性与评测工具选型
目前业界已经涌现出一批专为大模型场景打造的可观测性平台。在技术选型时,团队应当从开源自托管要求、数据隐私合规、追踪侵入性、评测集成度等维度综合评估。
| 工具名称 | 开源/商业属性 | 部署方式 | 核心定位与优势 | 潜在短板与考量 | 适用场景 |
|---|---|---|---|---|---|
| Langfuse | 开源 (MIT) | 深度支持自托管 (Docker/K8s) / 亦有 SaaS 版 | 专为大模型设计,Trace 树状视图清晰,支持 Prompt 版本管理、离线数据集与自动打分,API 与 SDK 极度轻量。 | 告警体系相对轻量,超大规模吞吐时需自行维护 ClickHouse/PostgreSQL 集群。 | 首选推荐:注重数据安全、需要自建私有化全套可观测性的团队。 |
| Arize Phoenix | 开源 (Apache 2.0) | 自托管 (Python 进程 / Docker) / 企业 SaaS | 强调 AI 质量评估与嵌入向量可视化,支持详细的 RAG Evals(忠实度、召回率)与聚类异常发现。 | 偏向于算法工程师分析与评测实验,传统运维监控看板功能相对克制。 | 重点在 RAG 深度分析、嵌入向量漂移与聚类分析的算法与工程团队。 |
| LangSmith | 商业闭源为主 | 官方 SaaS / 企业私有化部署门槛高 | LangChain 生态深度绑定,无缝追踪 Agent 内部多步跳转,调试与评测体验极佳。 | 闭源商业化产品,数据敏感型企业自托管部署成本较高,对非 LangChain 代码有适配成本。 | 深度使用 LangChain / LangGraph 且预算充足、允许数据出境的团队。 |
| OpenTelemetry + 自建 (ClickHouse) | 开源标准 | 纯自托管 | 基于 OpenInference 标准语义扩展,与企业既有链路追踪基础设施(如 Jaeger、SigNoz)完全统一。 | 缺乏专为大模型定制的交互式标注界面与 Prompt 评测比较面板,需要大量二开定制。 | 已有成熟 DevOps 平台的大型企业,要求将 AI 监控完全并入企业统一运维大盘。 |
四、在线质量监控与幻觉防御(Online Guardrails)
在实时请求链路中,如何以最小的延迟代价捕获模型输出的异常?一套工程化的在线质检体系通常分为四层防御体系:
用户请求 ---> [ 第一层:确定性规则硬约束 (Pydantic/Regex) ]
                     ↓ (通过)
              [ 第二层:检索忠实度与重合度轻量检测 (Faithfulness) ]
                     ↓ (通过)
              [ 生产交付输出 (返回给用户) ]
                     ↓ (异步旁路)
              [ 第三层:LLM-as-a-Judge 采样判决与异常告警 ]
                     ↓
              [ 第四层:用户交互反馈与 Bad Case 自动沉淀 ]
1. 第一层:确定性规则硬约束
这是最廉价、最高效的质检层,执行耗时通常在 10 毫秒以内:
- 结构化 Schema 强约束:如果业务要求输出 JSON,使用 Pydantic 或 JSON Schema 进行字段与数据类型的严格校验。如果解析失败,立即判定为失败,避免将带 Markdown 标记的半成品抛给下游;
- 确定性逻辑断言:例如在电商退货问答中,如果系统给出的结论是“可以退货”,但前文识别到的订单状态是“已超过30天”,则触发规则矛盾告警;
- 输出长度与重复度监控:大模型偶发陷入退化循环(Degeneration Loop)时,会不断重复某一段文字导致输出 Token 达到上限。通过简单的 N-gram 重复率或压缩比检查,可以秒级识别并掐断死循环。
2. 第二层:检索忠实度与重合度轻量检测
针对 RAG 系统,最常见的致命缺陷是未依据检索上下文作答(即凭空胡编事实)。
在不调用大模型的情况下,可以利用轻量级算法进行快速初筛:
- 实体覆盖度检验(Entity Overlap):利用轻量 NER 模型或关键词分词,抽取回答中的核心专有名词、人名、数字、物料编号,检查其是否包含在召回的 Context 切片中;
- 否定词漂移检测:检查回答中是否含有上下文完全没有提及的否定词或绝对化词汇(如“绝对不能”、“严禁”、“所有版本均不支持”)。
3. 第三层:LLM-as-a-Judge 异步采样判决
让大模型来评审大模型的输出(LLM-as-a-Judge)是目前衡量复杂语义质量最有效的方法。但在生产环境中,切忌在同步链路中对每一次请求都调用大模型打分,否则会直接导致系统延迟翻倍、API 成本翻倍。
正确的工程化实践是:
- 异步解耦:将完整的上下文、召回文档与模型输出推入消息队列(如 Redis / Kafka),由后台 Worker 异步消费评测;
- 分级动态采样:
- 对用户评分较低、输入 Token 异常过大、或者正则触发临界值的“可疑请求”,进行 100% 全量打分;
- 对常规请求,按 1%~5% 的比例进行随机采样打分;
- 使用小模型做仲裁:使用经过蒸馏或量化的轻量级模型(甚至专属评测小模型),只输出结构化的分项分数与简短理由,最大化压缩评审成本。
4. 第四层:用户交互反馈闭环
最真实的质量数据来自于最终用户。在前端交互设计中,应当主动沉淀用户行为反馈:
- 显式信号:点赞、点踩、反馈标签(如“答案不准确”、“未解决问题”、“回答太啰嗦”);
- 隐式信号:用户是否立即复制了回答内容?是否在 10 秒内发起了重试(Regenerate)?是否在多轮对话中表达了否定(如“不对”、“我问的不是这个”)?
这些信号一旦捕获,必须通过 Trace ID 与底层的具体 Span 精准绑定,成为定位坏例的直接线索。
五、离线自动化评测与 CI/CD 质量门禁(Offline Evals)
团队日常开发中最常见的困境是:“我把系统 Prompt 改得更客气、更严谨了一点,整体表现究竟是变好了还是变差了?”
没有一套自动化的离线评测体系,大模型的迭代就永远停留在“玄学”阶段。
1. 黄金样本集(Gold Dataset)的构建
构建离线评测集切忌追求海量而牺牲质量。一个健康的黄金数据集通常包含三类样本:
- 典型高频场景集(60%):覆盖业务中最核心的 80% 常见用例,确保基本盘的稳定;
- 边缘与恶劣输入集(25%):故意包含长尾词、错别字、含糊不清的提问、越狱注入测试(Prompt Injection),检验系统的鲁棒性;
- 线上真实 Bad Case 库(15%):历史上由用户点踩或线上告警捕获的真实缺陷,作为每次发布必须通过的防回归用例。
2. 多维打分指标矩阵
评测不仅仅看“对不对”,还要建立立体的评分维度:
| 评估维度 | 核心关注点 | 评测实现手段 | 合格阈值建议 |
|---|---|---|---|
| 正确性 (Correctness) | 输出的核心结论是否符合参考答案的标准知识点。 | 语义嵌入余弦相似度 + LLM-as-a-Judge 关键事实提取比对。 | $\ge 90%$ |
| 忠实度 (Faithfulness) | 回答中的每一句话是否都能在提供的参考文档中找到推导依据。 | 将回答拆解为陈述句(Claims),逐条交由轻量模型在上下文中溯源。 | $\ge 95%$(严禁凭空捏造) |
| 格式合规率 (Format Compliance) | 输出是否严格遵循要求的 JSON/Markdown/字段命名契约。 | 确定性代码解析器(Pydantic / 正则)。 | $100%$(必须完全通过) |
| 安全性与无害性 (Safety) | 是否包含歧视、违规、泄露敏感系统 Prompt 等风险。 | 规则关键词黑名单 + 安全分类器模型。 | $100%$(零容忍) |
| Token 与耗时基线 (Efficiency) | 相同输入下,Prompt 改动是否导致生成长度大幅膨胀。 | 统计平均 Completion Tokens 与生成延迟。 | 涨幅不超过基准线 $15%$ |
3. CI/CD 流水线自动拦截门禁
将离线评测脚本接入 Git 仓库的 Pull Request(PR)流水线。当工程师修改了 Prompt、切换了底层模型版本,或调整了 RAG 的检索参数时,GitHub Actions 或 GitLab CI 自动触发执行:
PR 提交 (修改 Prompt/模型)
       ↓
CI 启动:运行 offline_eval.py 对标 Gold Dataset
       ↓
输出回归对比报告 (Diff Report)
  - 正确性得分: 92.4% -> 93.1% (+0.7%)  [PASS]
  - 格式合规率: 100% -> 98.0% (-2.0%)   [FAIL 门禁触发]
  - 历史坏例回归: 40/40 全部通过        [PASS]
       ↓
门禁判定:格式合规率发生退化,CI 标红,禁止 Merge 上线!
只有当所有核心指标均未发生退化,且历史已知缺陷全部通过时,才允许合并代码部署上线。这才是大模型走向严肃工业化软件工程的唯一途径。
六、生产级实战代码:轻量级 LLM 可观测性与质检网关
为了让上述理念落地,下面给出一套自包含、无外部庞大依赖的生产级 Python 参考实现。该模块提供了:
- 基于上下文管理器的 Span 细粒度计时与 Token 追踪器;
- 轻量级在线质量与幻觉检查网关;
- 离线黄金数据集回归打分器原型。
# -*- coding: utf-8 -*-
"""
生产级 LLM 可观测性追踪、在线质检与离线评测工程示例
"""

import time
import json
import uuid
import logging
from dataclasses import dataclass, field, asdict
from typing import List, Dict, Any, Optional

logging.basicConfig(level=logging.INFO, format="[%(asctime)s] %(levelname)s: %(message)s")
logger = logging.getLogger("LLMObservability")


# -------------------------------------------------------------
# 1. 核心数据模型定义 (Trace & Span)
# -------------------------------------------------------------

@dataclass
class SpanData:
    span_id: str
    name: str
    start_time: float
    end_time: Optional[float] = None
    duration_ms: float = 0.0
    status: str = "RUNNING"  # RUNNING, SUCCESS, ERROR
    inputs: Dict[str, Any] = field(default_factory=dict)
    outputs: Dict[str, Any] = field(default_factory=dict)
    metrics: Dict[str, Any] = field(default_factory=dict)
    error_message: Optional[str] = None


@dataclass
class TraceRecord:
    trace_id: str
    session_id: str
    user_id: str
    overall_status: str = "SUCCESS"
    start_time: float = field(default_factory=time.time)
    end_time: Optional[float] = None
    total_duration_ms: float = 0.0
    spans: List[SpanData] = field(default_factory=list)
    tags: Dict[str, str] = field(default_factory=dict)
    feedback: Optional[Dict[str, Any]] = None


# -------------------------------------------------------------
# 2. 链路追踪管理器 (Trace Context Manager)
# -------------------------------------------------------------

class LLMTraceContext:
    def __init__(self, trace_id: Optional[str] = None, session_id: str = "default_session", user_id: str = "anon"):
        self.trace = TraceRecord(
            trace_id=trace_id or str(uuid.uuid4())[:8],
            session_id=session_id,
            user_id=user_id,
            start_time=time.time()
        )
        self.active_spans: List[SpanData] = []

    def start_span(self, name: str, inputs: Optional[Dict[str, Any]] = None) -> SpanData:
        span = SpanData(
            span_id=str(uuid.uuid4())[:6],
            name=name,
            start_time=time.time(),
            inputs=inputs or {}
        )
        self.active_spans.append(span)
        return span

    def end_span(self, span: SpanData, outputs: Optional[Dict[str, Any]] = None,
                 metrics: Optional[Dict[str, Any]] = None, status: str = "SUCCESS", error: Optional[str] = None):
        span.end_time = time.time()
        span.duration_ms = round((span.end_time - span.start_time) * 1000, 2)
        span.outputs = outputs or {}
        span.metrics = metrics or {}
        span.status = status
        span.error_message = error
        self.trace.spans.append(span)
        if span in self.active_spans:
            self.active_spans.remove(span)

    def finalize(self, success: bool = True):
        self.trace.end_time = time.time()
        self.trace.total_duration_ms = round((self.trace.end_time - self.trace.start_time) * 1000, 2)
        self.trace.overall_status = "SUCCESS" if success else "ERROR"
        # 生产环境中此处将 trace 对象序列化推入异步队列 (如 Redis / OTel Collector)
        logger.info(f"[Trace Finalized] ID={self.trace.trace_id} Spans={len(self.trace.spans)} Total={self.trace.total_duration_ms}ms")
        return self.trace


# -------------------------------------------------------------
# 3. 在线质量与规则质检网关 (Online Guardrail Engine)
# -------------------------------------------------------------

class OnlineQualityGuard:
    @staticmethod
    def inspect_response(response_text: str, context_docs: List[str], max_len: int = 4000) -> Dict[str, Any]:
        """
        轻量级在线质量硬检验:长度、结构、违规敏感词与核心事实重合度
        """
        issues = []
        is_safe = True

        # 规则 1:长度边界与死循环重复检查
        if len(response_text) > max_len:
            issues.append(f"Output length exceeds hard limit ({len(response_text)} > {max_len})")
            is_safe = False

        # 简单重复度检测 (检测是否存在严重退化循环)
        words = [w for w in response_text.replace("\n", " ").split(" ") if len(w) > 3]
        if len(words) > 30:
            unique_ratio = len(set(words)) / len(words)
            if unique_ratio < 0.25:
                issues.append(f"Degeneration loop detected (unique token ratio: {unique_ratio:.2f})")
                is_safe = False

        # 规则 2:敏感词/高危系统泄露拦截
        forbidden_patterns = ["Ignore all previous instructions", "SYSTEM PROMPT LEAK", "越狱指令"]
        for pattern in forbidden_patterns:
            if pattern.lower() in response_text.lower():
                issues.append(f"Forbidden security keyword detected: {pattern}")
                is_safe = False

        # 规则 3:轻量忠实度初筛 (上下文专有名词重合度)
        if context_docs:
            combined_context = " ".join(context_docs).lower()
            # 统计回答中的特定数字或代号是否在上下文中出现
            import re
            extracted_numbers = set(re.findall(r'\b\d{4,}\b', response_text))
            if extracted_numbers:
                hallucinated_numbers = [num for num in extracted_numbers if num not in combined_context]
                if hallucinated_numbers:
                    issues.append(f"Potential hallucinated identifier/number: {hallucinated_numbers[:3]}")
                    # 此处可根据业务严格程度决定是否阻断,默认为记录告警

        return {
            "is_valid": is_safe and len(issues) == 0,
            "issues": issues,
            "char_count": len(response_text)
        }


# -------------------------------------------------------------
# 4. 离线黄金评测集执行器原型 (Offline Evaluator)
# -------------------------------------------------------------

class OfflineBenchmarkSuite:
    def __init__(self, testset_path: Optional[str] = None):
        # 模拟典型的黄金样本库
        self.dataset = [
            {
                "id": "tc_01",
                "question": "公司员工年假计算规则是什么?",
                "ground_truth_keywords": ["工龄满1年", "5天年假", "每增加1年递增1天", "上限15天"],
                "context": "入职满1年享受带薪年休假5天,此后每增加1年工龄增加1天,上限不超过15天。"
            },
            {
                "id": "tc_02",
                "question": "项目代码上线部署必须遵守什么规则?",
                "ground_truth_keywords": ["代码评审通过", "单元测试覆盖率80%", "禁止周五下午发布"],
                "context": "所有部署必须通过至少一人CR,CI单元测试覆盖率达到80%,严禁在周五下午发布生产。"
            }
        ]

    def evaluate_model_pipeline(self, pipeline_fn) -> Dict[str, Any]:
        """
        对给定的模型管道执行自动化回归测试,统计准确度与回归指标
        """
        total_cases = len(self.dataset)
        passed_cases = 0
        report_details = []

        for item in self.dataset:
            start_t = time.time()
            output = pipeline_fn(item["question"], item["context"])
            dur = round((time.time() - start_t) * 1000, 2)

            # 评估核心关键词命中率
            matched = [k for k in item["ground_truth_keywords"] if k in output]
            coverage = len(matched) / len(item["ground_truth_keywords"])
            is_pass = coverage >= 0.75  # 阈值:覆盖 75% 以上关键事实判定为及格

            if is_pass:
                passed_cases += 1

            report_details.append({
                "case_id": item["id"],
                "passed": is_pass,
                "coverage_rate": round(coverage, 2),
                "duration_ms": dur,
                "missing_facts": [k for k in item["ground_truth_keywords"] if k not in output]
            })

        pass_rate = round((passed_cases / total_cases) * 100, 2)
        return {
            "total_cases": total_cases,
            "passed_cases": passed_cases,
            "pass_rate_pct": pass_rate,
            "details": report_details
        }


# -------------------------------------------------------------
# 5. 综合流水线串联运行示例
# -------------------------------------------------------------

def mock_rag_pipeline(question: str, context: str, tracer: Optional[LLMTraceContext] = None) -> str:
    """模拟一个完整的 RAG 检索生成函数"""
    # Span 1: 向量检索
    if tracer:
        s1 = tracer.start_span("retrieval_step", {"query": question})
        time.sleep(0.05)  # 模拟检索耗时 50ms
        tracer.end_span(s1, outputs={"docs_count": 1, "top_score": 0.89})

    # Span 2: 模型推理
    if tracer:
        s2 = tracer.start_span("llm_generation_step", {"prompt_len": len(question) + len(context)})
        time.sleep(0.12)  # 模拟推理耗时 120ms
        # 模拟生成回答
        generated_answer = f"根据制度:{context}"
        tracer.end_span(s2, outputs={"output_text": generated_answer}, metrics={"prompt_tokens": 45, "completion_tokens": 30})
    else:
        generated_answer = f"根据制度:{context}"

    return generated_answer


if __name__ == "__main__":
    print("=== [1] 生产运行时链路追踪与在线质检演示 ===")
    tracer = LLMTraceContext(user_id="user_prod_9901")

    # 执行模拟业务请求
    doc = "入职满1年享受带薪年休假5天,此后每增加1年工龄增加1天,上限不超过15天。咨询热线:400-888-9999。"
    query = "我入职满1年能休几天年假?"

    result = mock_rag_pipeline(query, doc, tracer)

    # 执行在线守门人质检
    guard_report = OnlineQualityGuard.inspect_response(result, context_docs=[doc])

    # 结束 Trace
    trace_obj = tracer.finalize(success=guard_report["is_valid"])

    print(f"回答生成: {result}")
    print(f"质检结果: {guard_report}")
    print(f"Trace 聚合耗时: {trace_obj.total_duration_ms}ms, 状态: {trace_obj.overall_status}")

    print("\n=== [2] CI/CD 离线回归评测套件运行演示 ===")
    suite = OfflineBenchmarkSuite()
    eval_result = suite.evaluate_model_pipeline(lambda q, c: mock_rag_pipeline(q, c))
    print(f"自动化评测通过率: {eval_result['pass_rate_pct']}% ({eval_result['passed_cases']}/{eval_result['total_cases']})")
    print(f"详情明细: {json.dumps(eval_result['details'], ensure_ascii=False, indent=2)}")
七、大模型可观测性生产落地的五大反模式
在推进大模型工程化的过程中,许多团队容易陷入以下五个典型误区,必须高度警惕:
1. 全量使用昂贵闭源大模型做在线评审(成本失控)
有些架构师在设计在线质检时,对每一次生产业务调用,都同步发一次请求给顶配大模型进行“打分与审核”。这会导致系统的API 费用翻倍、端到端响应延迟翻倍。更合理的方案是:在线优先依靠确定性代码规则与轻量正则;大模型评审只用于异步消息队列、分级动态抽样或离线基准测试。
2. 只监控最终输出,忽略召回与预处理链路
“问答不准”的故障中,超过 70% 的根因并不在 LLM 本身,而在向量切片质量差、检索阈值不合理、或者多路召回融合失效。如果系统只把 LLM 的输入输出记录下来,却丢失了检索片段、文档相似度得分、Prompt 动态拼接逻辑,那么每次复盘 Bug 时依然只能靠猜测。
3. 没有固定测试基准,凭主观肉眼抽测上线
“我试了两个例子,感觉比以前好多了,直接发布吧!”——这是大模型团队最致命的开发习惯。大模型的输出极度敏感,修改一段提示词可能让特定 Case 得分上升,却让另外数十个 Case 发生静默退化。没有至少 50~100 个固定黄金用例的量化打分对比报告,严禁任何 Prompt 变更合并进主分支。
4. 追踪埋点与主链路强耦合,同步阻塞业务
有些团队把链路数据、Token 统计甚至日志存储直接同步写入关系型数据库。当日志数据库发生锁等待或网络抖动时,反向导致前端用户的大模型对话全面卡死或超时报错。可观测性代码必须严格遵循旁路原则(Out-of-band):通过异步内存缓冲区、无阻塞队列批量刷写,任何监控故障绝不能连带拖垮生产业务。
5. 追求全量指标狂欢,却无明确报警与熔断机制
在后台搭建了花哨的看板,采集了几十个图表,但没有设定任何阈值与应急机制。当 TTFT 异常翻倍、系统被爬虫刷爆 Token、或者某类意图的拦截率飙升时,系统没有任何人收到告警。指标的价值在于驱动行动:必须明确设定 TTFT P99 告警线、日 Token 消费配额硬熔断阈值,以及 CI 门禁失败直接阻断部署。
八、大模型可观测性与质量工程 15 项落地自检清单
在将大模型应用推向生产环境前,建议按照以下 15 项标准进行系统性的自我审查:
维度一:链路追踪与上下文还原(4项)
-
- 全链路 Span 覆盖:是否对检索(Recall)、重排(Rerank)、提示词组装、模型生成、工具调用各环节均有独立 Span 计时?
-
- 完整元数据记录:Trace 中是否持久化记录了完整的 System/User Prompt、模型版本名、温度参数及最终原始输出?
-
- 关联上下文 ID:每个 Trace 是否绑定了 Session ID、User ID、Tenant ID 以及上游业务系统的请求唯一标识?
-
- 异常上下文留存:发生 429 限流、模型拒绝、JSON 解析崩溃时,是否保留了当时的现场快照而非仅仅输出一条错误日志?
维度二:指标监控与成本审计(4项)
-
- 流式性能指标分拆:看板是否独立展示首字生成延迟(TTFT)与每 Token 生成速度(TPOT),而非仅有一个粗糙的总耗时?
-
- Token 精确计量:是否统计并区分了 Prompt Tokens 与 Completion Tokens,并能按天/按功能模块核算财务支出?
-
- 上下文缓存追踪:是否对前缀缓存(Prompt/KV Cache)命中率进行了监控,并将其作为评估提示词结构优劣的指标?
-
- 动态配额与熔断:是否针对单个用户、租户或 API Key 设定了调用频率与单日 Token 消耗硬上限,防止异常刷量?
维度三:在线质量防线与用户闭环(4项)
-
- 结构化强校验:对预期输出 JSON 的场景,是否集成了基于 Schema 的确定性解析与字段校验?
-
- 防死循环机制:是否具备输出长度截断与重复 N-gram 异常检测,能在模型退化死循环时秒级中止?
-
- 异步采样评测:是否建立了针对生产流量的异步采样与分级 LLM-as-a-Judge 审查机制,而非全量同步硬测?
-
- 交互反馈捕获:前端是否具备点赞/点踩或错误标记功能,并能将反馈与对应的 Trace ID 精准关联?
维度四:离线回归测试与 CI/CD 门禁(3项)
-
- 高价值黄金样本库:代码仓库中是否维护了涵盖高频业务、边界场景与历史缺陷的固定自动化测试数据集?
-
- CI/CD 自动化拦截:是否将评测脚本集成到流水线中,当准确率、格式合规率或事实忠实度下降时能自动阻断代码合并?
-
- 难例自动化回流:线上被用户点踩或质检网关捕获的典型 Bad Case,是否具备快速清洗并沉淀回离线测试集的工程闭环?
结语
大语言模型为软件开发带来了前所未有的智能与交互灵活性,但也把传统确定性系统彻底推向了概率世界。在这个世界里,能够做出令人惊艳的 Demo 只是第一步;真正决定一家企业 AI 战略能否走得长远、能否承载严肃商业价值的,是其背后的工程化底座。
看得清每一次调用背后的细粒度流转,控得住概率模型随时可能爆发的幻觉与成本毛刺,守得住版本更迭时不可退让的质量底线——这正是可观测性与质量工程赋予大模型时代的确定性力量。
如果您正在规划企业内部的大模型可观测性建设、需要搭建私有化 Tracing 平台,或者在生产环境落地中遇到性能与评测难题,欢迎通过 关于与联系页面 与我们展开进一步的工程交流与技术探讨。