在过去一到两年里,“多智能体系统(Multi-Agent Systems, MAS)”几乎成为了大模型应用领域最具诱惑力、也最被热烈讨论的技术概念。
从最初引爆开发者社区的 AutoGPT、ChatDev、MetaGPT,到诸如 CrewAI、AutoGen 等开源多智能体编排框架的风靡,各路演示 Demo 展现出的图景令人心驰神往:在由多个智能体组成的“虚拟软件公司”里,一个“产品经理 Agent”撰写需求文档(PRD),一个“系统架构师 Agent”完成技术选型,一个“工程师 Agent”敲出前端与后端代码,最后还有一个“测试 Agent”挑出代码 Bug 并自动化修复。整个过程无需人类介入,智能体之间你来我往、互相质询、对齐思路,仿佛一个真正具备自主协作能力的数字团队。
这种基于拟人化隐喻(Anthropomorphic Metaphor)的演示,不仅在社交媒体和投资人路演中极具传播力,也让大量技术团队产生了强烈的架构冲动——既然一个 Agent 的能力受限,那把一个复杂业务系统拆分成三五个、甚至十几个专职 Agent 共同协作,不就能解决所有长链路难题了吗?
然而,当这些团队真正把多智能体系统从演示沙箱搬进企业真实的生产环境(接入真实的 CRM、ERP、代码库或运维流水线)时,绝大多数架构师与工程团队迅速遭遇了迎头痛击:
- Token 消耗与调用延迟呈超线性甚至指数级膨胀:一次原本只需要调用一次模型或跑一段确定性脚本的业务,被多智能体拆解为几十轮跨代理交互,端到端耗时从 2 秒拉长至 3 分钟,API 账单成倍激增;
- 误差级联与“幻觉共振”:上游 Agent 产生了一个细微的推测偏差,下游 Agent 没有怀疑反而将其视为事实继续推导,多轮交锋后演变成一场集体迷失;
- 状态不一致与死锁震荡:各个 Agent 各执一词,陷入无意义的客套或循环纠错,整个工作流在黑盒中原地打转,最终触发超时崩溃;
- 系统端到端成功率断崖式下跌:原本单 Agent 或确定性流水线能稳定达到 85% 以上的任务成功率,上了一套“豪华”的多智能体架构后,成功率反而骤降至 40% 以下。
多智能体协作究竟是通往通用任务自动化的必由之路,还是一场耗费工程资源的过度设计?
本文将剥离宣传噱头与拟人化幻象,从生产级软件工程与分布式系统架构的本质出发,深入拆解多智能体系统的“四大隐性税负”,系统横向评测四种主流智能体架构范式,并提供一套可落地的“四问定路线”决策树与上线自检清单,帮助你在架构选型时做出最务实、最抗膨胀的技术决断。
拟人化陷阱:为什么现实不是“角色扮演”
在探讨技术架构之前,我们必须首先反思导致多智能体过度设计的思想根源:拟人化思维与计算机系统工程的根本错位。
人类社会之所以需要“分工协作”,是因为单个生物个体的认知带宽、知识存储和时间精力是严格受限的:
- 一位资深法律专家不可能同时精通深层 Linux 内核汇编;
- 一位外科医生在手术台上无法同时去审核财务凭证。
人类通过组织、会议、文档和即时通讯来分工协作,本质上是在用沟通开销换取领域专精能力的叠加。
但大语言模型(LLM)的底层逻辑完全不同:
- 统一的参数化世界知识:同一个前沿基座大模型,其神经网络权重中已经同时压缩了 Python 编程、商业战略分析、法律文本审查和多语言翻译的知识。它并不存在像人类那样“因学了医学而彻底忘记代码语法”的生理物理排斥。
- 极高的上下文传递成本:人类面对面交流可以通过眼神、肢体语言和几句简短的话语同步大量隐含背景;而在计算机系统中,两个独立实例化的 Agent 之间要实现“对齐上下文”,必须将庞大的自然语言历史、角色设定(System Persona)、工具元数据反复序列化为 Token,通过网络传输和注意力机制重新计算。
很多团队误把“组织学上的分工”机械地搬到了“大模型系统的模块划分”上,为系统强行设立了“分析师”、“策划师”、“审核员”、“总监”等虚构角色,并让他们用未结构化的自然语言互相“开会”。
这种设计在工程上极其反直觉:在软件工程中,两个模块之间通信的首选永远是定义明确的强类型接口(如 RPC、RESTful API、Protobuf、JSON Schema),而绝不是两个黑盒模型之间充满歧义与冗余的自然语言长文本闲聊。
将拟人化的组织协作生搬硬套到软件架构中,必然会引发严重的工程反噬。
多智能体系统的“四大隐性税负”
当一个系统引入多个具有自主规划能力的 Agent 并让它们自由通信时,系统复杂度并不是以线性增长,而是以组合爆炸的方式激增。任何准备上多智能体系统的团队,都必须首先核算以下四笔沉重的“隐性税负”:
1. 认知上下文膨胀税(Context Overhead & Token Inflation)
在单 Agent 架构中,上下文通常只有两部分:用户输入的主目标,以及 Agent 调用工具时产生的逐步观察结果(Observation)。
而在典型的去中心化多智能体系统中,为了让 Agent A 理解 Agent B 的产出,编排器必须将 Agent B 的思考逻辑、角色身份与历史对话全部注入到 Agent A 的提示词中。随着交互轮数的增加,每个 Agent 的 Prompt 呈现出滚雪球式的膨胀。
更糟糕的是,自然语言具有天然的高冗余度与低信息密度。一个原本可以通过一个布尔值状态位 is_approved: true 完成的确认,在多 Agent 聊天中往往演变为一段长达数百 Token 的礼貌回复(“我已经仔细审阅了架构师的方案,整体思路非常清晰,不过我有以下三点微小的建议……”)。这种认知冗余直接导致系统的 Token 消耗呈爆炸式增长,API 费用失控,且不可避免地逼近大模型的有效注意力衰减窗口(Lost in the Middle)。
2. 误差级联与“幻觉共振”税(Error Cascading & Resonance)
大语言模型本质上是基于概率的语义生成器,这意味着每一次推理都存在非零的幻觉或逻辑谬误概率。
假设一个任务包含 5 个串行阶段,如果每个阶段由一个独立的 Agent 负责,且单个 Agent 产出完全正确的概率为极其乐观的 $90%$($0.9$),那么端到端全链路完全正确的理论上限概率仅为:
$$0.9^5 \approx 0.5905 \quad (59%)$$
而在真实的跨 Agent 自由通信中,实际情况往往更加恶劣。上游 Agent 产生的一个未经事实核验的轻微假设(例如:“考虑到客户使用的是私有云部署方案……”),到了下游 Agent 的视野里就会被直接当成不可动摇的既定前提。下游 Agent 不仅不会纠错,反而会顺着这个虚假前提出谋划策,最终在多轮推波助澜中演变成一场荒谬的“幻觉共振”。系统输出的内容看似结构严谨、辞藻华丽,实则核心假设全盘皆错。
3. 状态分散与一致性税(State Drift & Split-Brain Dilemma)
任何健壮的企业级软件系统,都必须具备清晰的“单一真实数据源(Single Source of Truth, SSOT)”。
在传统的集中式状态机中,业务状态(如订单状态、编译结果、执行进度)保存在受控的数据库或内存对象中。而在自由交谈的多智能体系统中,状态往往隐式散落分布在各个 Agent 各自的历史对话记录中:
- Agent A 以为某些依赖已经安装完毕;
- Agent B 在第三轮对话中否定了该决策,但其否定指令被淹没在长文本里;
- Agent C 依然按照过期的假设执行危险写入。
这种状态不同步极易导致分布式系统经典的“裂脑(Split-Brain)”问题。当系统发生执行中断或局部报错时,外部观测器几乎无法精准定位当前整个业务系统究竟停留在哪一个确切的状态节点,更谈不上可靠的状态持久化、断点重试与故障回滚。
4. 调度死锁与通信震荡税(Orchestration Deadlock & Oscillation)
在没有强约束状态机的情况下,赋予多个 Agent 自主对话权往往会触发非预期的逻辑震荡。最典型的现象包括:
- 互吹彩虹屁(Infinite Politeness Loop):“你的建议很好,你觉得呢?”“我也觉得很好,请问接下来如何推进?”
- 乒乓死锁(Ping-Pong Deadlock):Agent A 指令 Agent B 完善细节,Agent B 反过来要求 Agent A 提供前置参数,二者在缺乏外部监督的情况下无限消耗 Token,直到触碰最大步数截断;
- 发散性任务(Goal Drift):在经过五轮以上的自主交互后,智能体们讨论的焦点逐渐偏离了用户最初提出的核心诉求,转向了某个旁支技术细节的无休止争论。
为了抑制这些不可控的震荡,工程师往往不得不追加更多的“裁判 Agent(Critic/Judge Agent)”或编写极其复杂的自然语言规则。这无异于用一套概率系统去修补另一套概率系统,使整体系统的脆性(Fragility)成倍增加。
架构全景:四种智能体范式的深度横向评测
为了在实际工程选型中避免“非黑即白”的极端认知,我们需要建立一套清晰的技术坐标系。当前业界的大模型落地架构,本质上可以划分为四种不同控制力度的核心范式:
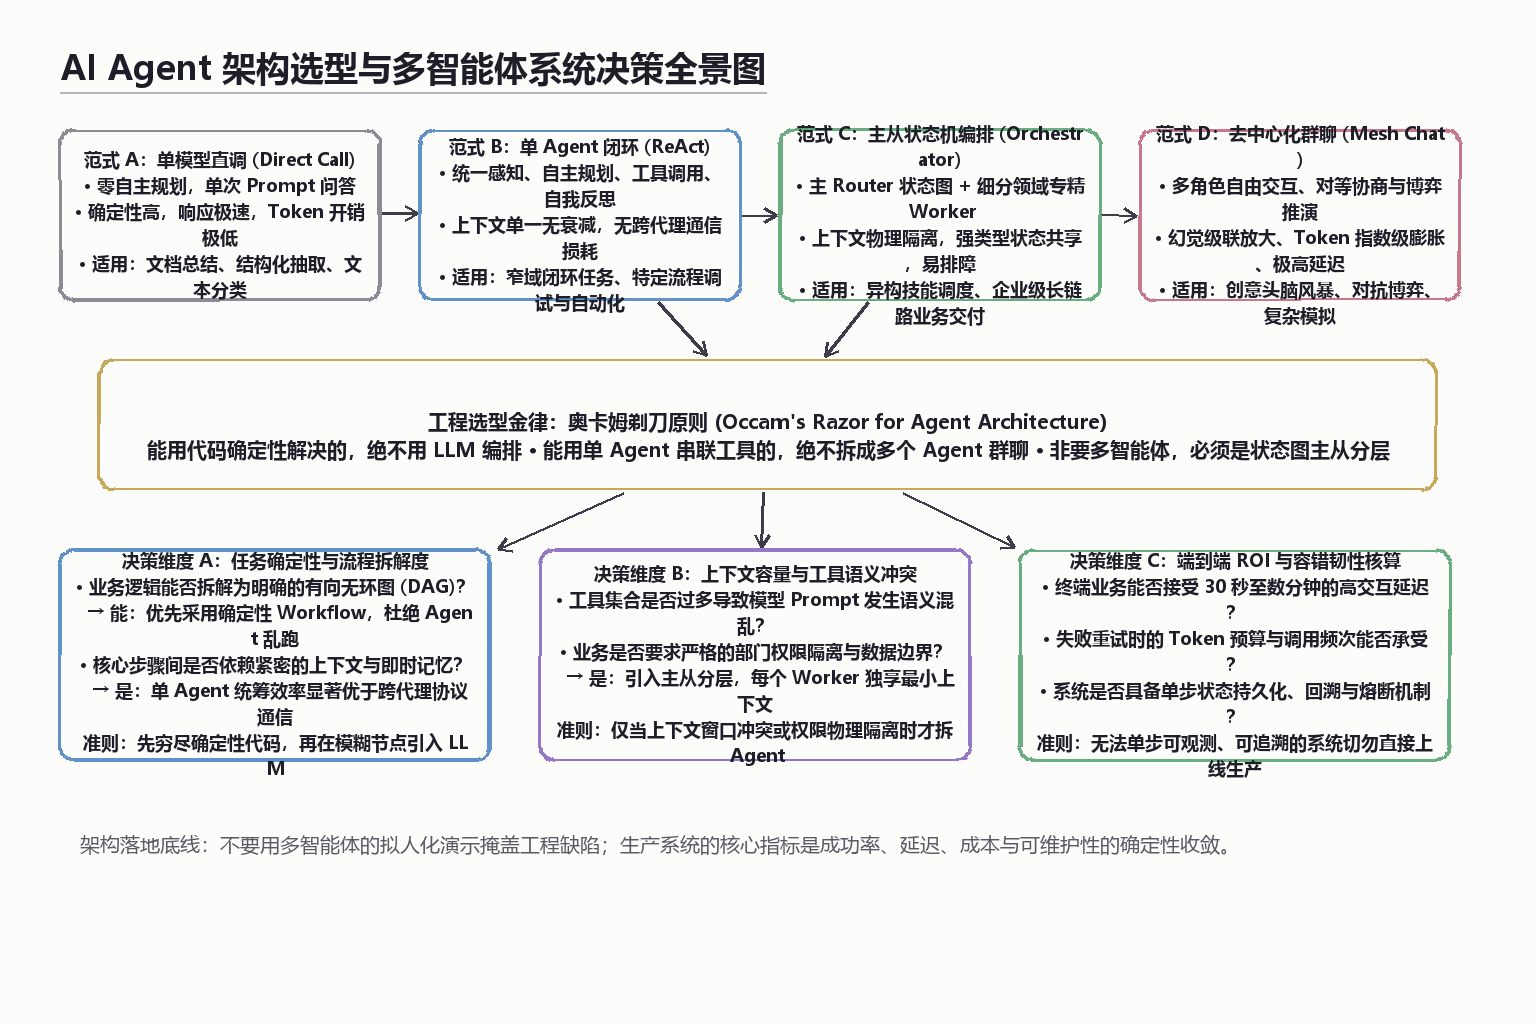
我们从系统控制力、确定性、成本、排障难度等关键工程维度对这四种范式进行深度横向对比:
| 评估维度 | 范式 A:单模型直调 (Direct Call) | 范式 B:单 Agent 闭环 (ReAct/Tool Use) | 范式 C:主从状态机编排 (Orchestrator-Workers) | 范式 D:去中心化群聊 (Decentralized Mesh) |
|---|---|---|---|---|
| 核心机制 | 单次 Prompt 问答,无自主规划,输入直出 | 统一的思考-行动-观察循环(ReAct),直接驱动工具库 | 确定性状态图(StateGraph)驱动,主 Router 分发,Worker 隔离 | 多角色对等协商,通过自然语言自由交换消息与博弈 |
| 控制确定性 | 极高(完全由前置业务代码控制流向) | 中高(在受限工具集合与提示词下自闭环) | 高(业务主干由代码状态机强管控,局部自主) | 极低(涌现行为不可预测,容易陷入发散与死锁) |
| Token 消耗 | 基准线(1x,仅单次请求消耗) | 可控(2x - 5x,取决于工具调用步数) | 线性可控(3x - 8x,各 Worker 独享最小上下文) | 超线性爆炸(10x - 50x+,随对话轮数平方级膨胀) |
| 端到端延迟 | 极低(毫秒级至数秒内) | 中等(数秒至十余秒) | 中高(取决于子任务并行度与状态流转) | 极高(通常在 30 秒至数分钟以上) |
| 系统可观测性 | 极佳(传统 APM 与日志即可完全覆盖) | 良好(清晰的 Tool Call 轨迹与单链路跟踪) | 优秀(每个状态节点与状态转移均可被单步持久化审计) | 极差(对话黑盒,极难复现偶发性逻辑偏离) |
| 排障与回滚 | 极易定位 | 较易(针对单步工具返回设计防护兜底即可) | 易于精准回滚(可直接针对特定 Worker 节点重试) | 极其困难(一人说错全盘皆乱,无法单点修剪) |
| 典型适用场景 | 文本分类、语义抽取、代码补全、格式转换 | 窄域运维排障、单据审查、数据库查询、单兵编程助手 | 企业长链路业务、异构专业技能聚合、多系统集成交付 | 开放式头脑风暴、剧本演练、红蓝攻防对抗模拟 |
从上表中可以清晰地看到:
在商业与生产落地场景中,范式 D(去中心化自由群聊)几乎无法满足企业系统对“高可靠、低延迟、确定性交付、成本可预测”的基本诉求。 绝大多数声称“必须上多智能体”的业务场景,在工程实质上需要的要么是经过精心设计的范式 B(单 Agent 深度工具链),要么是收敛严格的范式 C(主从状态机编排)。
核心裁决框架:“四问定路线”决策树
在技术评审会上,当有团队成员提出“这个系统场景太复杂,我们必须搭建一个由 5 个 Agent 组成的多智能体系统”时,架构师应当用以下四个具有否决权的问题逐层进行技术拷问:
[原始业务需求]
       │
       ▼
【第 1 问】:任务主流程能否被拆解为明确的有向无环图 (DAG) 或确定性状态机?
       ├─► [能] ───────►【选型结论】:坚决采用传统代码工作流 (Workflow/Pipeline)
       │                 (LLM 仅作为特定节点上的信息提取或语义转换函数,严禁 Agent 自由规划)
       ▼ [否]
【第 2 问】:当前单 Agent 的执行瓶颈,是否真正源于上下文冲突或工具数量超标?
       ├─► [否] ───────►【选型结论】:坚决采用「单 Agent + 结构化工具链 + 外部记忆」
       │                 (优化 Prompt 结构,引入动态少样本,补充确定性检查脚本)
       ▼ [是]
【第 3 问】:系统是否存在多租户权限隔离、物理安全边界或真正异构的领域分工?
       ├─► [是] ───────►【选型结论】:采用「主从状态机架构 (Orchestrator-Workers)」
       │                 (主 Router 负责状态调度,专用 Worker 负责窄域闭环,杜绝横向私聊)
       ▼ [否]
【第 4 问】:业务场景是否对端到端延迟、单次成功率与调用成本有严格的 SLA 约束?
       ├─► [有严格约束] ─►【选型结论】:强行降级回「确定性工作流 + 单 Agent 兜底」
       └─► [完全无约束] ─►【选型结论】:仅在开放式沙盘推演/创意对抗等科研探索场景使用多 Agent 群聊
第一问:任务主流程能否被拆解为明确的有向无环图(DAG)?
在很多团队的盲目实践中,他们把原本用传统规则引擎或简单状态机写 50 行代码就能搞定的事情,全权交给了多智能体去“自主开会讨论”。
例如,一个典型的入职审批或发票报销流程:“先校验发票真伪,再根据金额判断是否需要总监审批,最后调用 ERP 接口入账”。这个流程的流转逻辑是 $100%$ 确定性的。任何具有确定性前后依赖关系的业务逻辑,都应该由确定性的代码流程控制(如 Python 脚本、Temporal、Airflow 或基于代码的状态图)来驱动。
在这样的流程中,大模型唯一的价值是充当特定节点上的“认知执行器”——比如负责从非结构化发票 PDF 中抽取结构化字段。用概率性的 Agent 自主对话来替代确定性的代码控制流,是架构设计中最高成本的倒退。
第二问:单 Agent 的瓶颈是否真正源自上下文冲突或工具数量超标?
很多时候,单 Agent 表现不佳并不是因为“单 Agent 架构本身不行”,而是因为糟糕的上下文工程与工具定义:
- 把 40 个未加筛选的内部 API 一股脑扔给模型,导致模型在选择工具时产生语义混淆;
- Prompt 冗长混乱,没有给模型提供结构化的思考脚手架(Scaffolding);
- 缺乏确定性的环境反馈,模型执行报错后无法感知具体原因。
在主流长上下文模型(支持 128K 至 1M Context)普及的今天,单 Agent 承载复杂上下文的能力已大幅跃升。只有当满足以下两个硬性条件之一时,拆分 Agent 才具备合理的工程正当性:
- 工具语义发生互斥干扰:例如系统同时包含两组极其相似但业务域完全冲突的 API(如国内电商与海外电商的下单结算逻辑),合并在一个 Prompt 中会导致模型误选率极高;
- 专属 Few-Shot 样本量极大:某个专业环节(如复杂的特定格式法律文书生成)需要附带几万 Token 的特定规则与模版,若常驻在主上下文内会严重挤占工作记忆并拖慢其他所有步骤。
如果仅仅是因为“想让流程看起来更专业”,那么单 Agent 加精细化的工具过滤(Dynamic Tool Retrieval)永远是性价比最高的首选方案。
第三问:是否存在多租户权限隔离或组织物理安全边界?
在涉及高敏感数据的企业场景中,Agent 之间的物理隔离往往是出于安全考量,而非算法需求:
- HR 薪酬分析 Agent:拥有访问公司核心薪酬数据库的凭据,但绝不能暴露公网访问与邮件外发工具;
- 客服对外响应 Agent:拥有面向终端用户的公网交互能力,但绝对禁止直接挂载底层内部私有数据库。
如果一个复杂业务需要同时跨越低信任区与高信任区,此时绝不能使用一个拥有全量权限的庞大单 Agent。唯一的正解是通过分层主从架构(Orchestrator-Workers),让网关层的主 Router 对请求做脱敏与意图拆解,派发给内网无公网权限的只读 Worker 处理,再将经过清洗的结构化结果返回给前端。此时的“多智能体”,其本质是微服务架构在 AI 时代的权限隔离映射。
第四问:业务是否对端到端延迟与成功率有严格的 SLA 约束?
很多多智能体框架在技术分享时演示的成功案例,往往背后跑了几十次甚至上百次重试,才挑选出一支完美的视频剪辑。
但生产级系统的核心生命线是 SLA(服务等级协议)。如果你的业务系统是面向终端用户的交互式服务(如官网在线客服、实时辅助编写、在线下单):
- 用户等待的心理防线通常在 3 秒到 10 秒 之间;
- 业务对执行成功率的要求通常在 $99%$ 以上。
任何包含 3 个以上 Agent 互相质询讨论的系统,其平均响应时间几乎不可避免地突破 45 秒,端到端单次成功率很难在不加确定性干预的情况下稳定突破 $80%$。如果你的业务场景无法容忍分钟级延迟与高频重试,请毫不犹豫地放弃网状多智能体方案。
工业级最佳实践:从“自由群聊”走向“状态机分层编排”
如果你的业务经过审慎论证,确实属于工具集异构、涉及多权限边界的长链路复杂业务,必须引入多智能体能力,那么你应该如何设计系统架构?
核心答案是:杀死一切自由形式的自然语言群聊,全面转向“强类型全局状态驱动的分层状态机(State Graph with Single-Duty Workers)”。
这一理念也正是 LangGraph、LlamaIndex Workflows 等现代工业级框架之所以迅速取代早期 AutoGen 自由聊天模式的核心原因。
         ┌─────────────────────────────────────────┐
         │           全局共享强类型状态            │
         │         Typed Global State (SSOT)       │
         └────────────────────┬────────────────────┘
                              │
              读写受控状态     │ 状态变更触发
                              ▼
                 ┌─────────────────────────┐
                 │    主控路由器 / 编排器  │
                 │  Orchestrator / Router  │
                 └───────┬─────────┬───────┘
                         │         │
              分发子任务 │         │ 分发子任务
                         ▼         ▼
┌───────────────────────────┐   ┌───────────────────────────┐
│   专精执行者 Worker A     │   │   专精执行者 Worker B     │
│  (独立最小上下文 / 工具集)│   │  (独立最小上下文 / 工具集)│
└─────────────┬─────────────┘   └─────────────┬─────────────┘
              │                               │
              └───────────────┬───────────────┘
                              ▼
                 ┌─────────────────────────┐
                 │    确定性熔断与校验器   │
                 │  Circuit Breaker / Guard│
                 └─────────────────────────┘
一个具备工业级韧性的多智能体编排系统,必须严格遵循以下三条设计准则:
准则一:建立强类型全局状态(Typed Global State as SSOT)
严禁 Agent 之间通过未格式化的自然语言互相“私信”传话。系统必须定义一个严格的全局数据结构(如 Pydantic BaseModel 或 TypeScript Interface)。
所有的执行者(Worker)本质上只是该状态机上的纯函数或状态转换器:输入是当前全局状态的一个受控切片,输出必须是符合严格 JSON Schema 的增量更新字段(State Delta)。
准则二:主从分层与单一职责(Single Responsibility)
主控路由(Orchestrator)只负责两件事:
- 分析全局状态,依据预定义的业务逻辑或轻量语义判断,决定下一个应该激活的 Worker 是谁;
- 判定任务是否已经达到最终终止条件(Termination Condition)。
每个具体的 Worker 只专注于自己狭窄的领域,拥有独立的、极致精简的 System Prompt 和最小化工具集合,彼此之间完全不知道对方的存在,更不需要互相感知彼此的内部思考细节。
准则三:工程级确定性熔断(Deterministic Guardrails & Circuit Breaker)
不要把系统的稳定性寄托在“Agent 能够在合适的时候自己说出【任务已完成】”这种虚无缥缈的概率假设上。
外部工程层必须强行植入确定性看门狗机制:
- 严格限制状态流转的最大跳数(如超过 10 步强制中断并报警);
- 每次工具调用设置确定性的超时阈值(Timeout);
- 关键状态变更(如生产数据库写入、资金变动、对外发信)强制挂起状态机,进入人机协同(Human-in-the-Loop, HITL)审批流,未获人工确认前绝不流转到下一个节点。
架构实战:抗膨胀的分层调度模式代码实现
为了更直观地展示工业级生产代码与玩具 Demo 的本质差异,我们以一个典型的“跨系统复杂问题诊断流水线”为例,展示如何用清晰的 Python 结构实现一套抗膨胀、强类型、带安全熔断的分层状态机架构:
"""
工业级分层状态机编排模式(基于强类型状态与确定性路由)
杜绝 Agent 自由群聊,实现状态单向流转、上下文物理隔离与最大步数熔断。
"""

from typing import Dict, Any, List, Optional
from pydantic import BaseModel, Field
import json

# ==============================================================================
# 1. 单一真实数据源:强类型全局状态定义 (Single Source of Truth)
# ==============================================================================
class DiagnosticState(BaseModel):
    incident_id: str
    user_query: str
    target_cluster: str
    # 结构化业务数据字段
    log_traces: List[str] = Field(default_factory=list)
    metric_anomalies: List[str] = Field(default_factory=list)
    root_cause_analysis: Optional[str] = None
    remediation_proposal: Optional[str] = None
    # 编排与控制字段(防止死锁)
    current_step: str = "router"
    step_count: int = 0
    max_steps: int = 8
    is_completed: bool = False
    error_message: Optional[str] = None


# ==============================================================================
# 2. 单一职责 Worker:独立上下文,严禁横向通信
# ==============================================================================
class LogAnalysisWorker:
    """专精于日志分析的 Worker,仅挂载 Elasticsearch/Loki 查询工具"""
    def run(self, state_slice: Dict[str, Any]) -> Dict[str, Any]:
        cluster = state_slice["target_cluster"]
        # 在实际工程中,此处为调用 LLM + 专有 Tool 检索日志
        # Worker 接收极简上下文,产出高度结构化的数据,绝不夹带冗余客套
        extracted_logs = [
            f"[{cluster}] NullPointerException in PaymentService.java:142",
            f"[{cluster}] ConnectionResetByPeer from DB-Pool-Primary"
        ]
        return {
            "log_traces": extracted_logs,
            "step_count": state_slice["step_count"] + 1
        }


class MetricAnalysisWorker:
    """专精于监控指标分析的 Worker,仅挂载 Prometheus 查询工具"""
    def run(self, state_slice: Dict[str, Any]) -> Dict[str, Any]:
        cluster = state_slice["target_cluster"]
        extracted_metrics = [
            f"[{cluster}] Pod CPU Throttling > 92% sustained for 15m",
            f"[{cluster}] ThreadPool exhaustion detected (active=200, max=200)"
        ]
        return {
            "metric_anomalies": extracted_metrics,
            "step_count": state_slice["step_count"] + 1
        }


class SynthesisWorker:
    """专精于根因归纳与方案生成的 Worker,仅在数据采集完毕后被调用"""
    def run(self, state_slice: Dict[str, Any]) -> Dict[str, Any]:
        logs = state_slice.get("log_traces", [])
        metrics = state_slice.get("metric_anomalies", [])

        # 基于结构化采集事实进行逻辑归因,上下文极为干净,无任何历史撕扯冗余
        root_cause = (
            "高并发下数据库连接池被打满,引发线程排队与 CPU Throttling,"
            "最终导致 PaymentService 触发未捕获的空指针异常。"
        )
        proposal = "1. 临时扩容连接池最大上限;2. 增加针对异常流量的自适应熔断限流策略。"

        return {
            "root_cause_analysis": root_cause,
            "remediation_proposal": proposal,
            "is_completed": True,
            "step_count": state_slice["step_count"] + 1
        }


# ==============================================================================
# 3. 主控路由器与熔断编排器 (Orchestrator & Guardrail)
# ==============================================================================
class SafeIncidentOrchestrator:
    def __init__(self):
        self.log_worker = LogAnalysisWorker()
        self.metric_worker = MetricAnalysisWorker()
        self.synthesis_worker = SynthesisWorker()

    def route_next(self, state: DiagnosticState) -> str:
        """确定性路由逻辑:优先依赖代码条件分支,避免盲目交给大模型做无约束决策"""
        if state.step_count >= state.max_steps:
            return "circuit_break"
        if state.is_completed:
            return "end"

        # 业务确定性前置规则:先查日志,再查指标,最后做综合归因
        if not state.log_traces:
            return "fetch_logs"
        if not state.metric_anomalies:
            return "fetch_metrics"
        if not state.root_cause_analysis:
            return "synthesize"

        return "end"

    def execute(self, initial_state: DiagnosticState) -> DiagnosticState:
        state = initial_state

        while not state.is_completed:
            # 外部确定性守门人检测
            if state.step_count >= state.max_steps:
                state.error_message = f"执行熔断:达到最大安全步数限制 ({state.max_steps})"
                break

            next_action = self.route_next(state)

            if next_action == "fetch_logs":
                delta = self.log_worker.run(state.model_dump())
                state = state.model_copy(update=delta)
            elif next_action == "fetch_metrics":
                delta = self.metric_worker.run(state.model_dump())
                state = state.model_copy(update=delta)
            elif next_action == "synthesize":
                delta = self.synthesis_worker.run(state.model_dump())
                state = state.model_copy(update=delta)
            elif next_action in ("end", "circuit_break"):
                break
            else:
                state.error_message = f"未知的路由状态: {next_action}"
                break

        return state


# ==============================================================================
# 4. 生产调用验证
# ==============================================================================
if __name__ == "__main__":
    task = DiagnosticState(
        incident_id="INC-20261026-091",
        user_query="核心支付链路突然出现 504 网关超时,请协助定位根因并给出处置预案",
        target_cluster="prod-ap-east-cluster"
    )

    orchestrator = SafeIncidentOrchestrator()
    final_result = orchestrator.execute(task)

    print("=== 系统最终执行状态 ===")
    print(f"任务完成状态: {final_result.is_completed}")
    print(f"总调度流转步数: {final_result.step_count}")
    print(f"最终归因结论: {final_result.root_cause_analysis}")
    print(f"处置建议: {final_result.remediation_proposal}")
    if final_result.error_message:
        print(f"告警信息: {final_result.error_message}")
从上述工程代码中可以清晰地看出工业级架构的几大核心特征:
- 状态强类型化:每个字段的类型和含义在代码级清晰固定,无任何自然语言模糊传递空间;
- 上下文彻底隔离:
LogAnalysisWorker永远不会看到MetricAnalysisWorker的前置思考过程,只负责向全局状态提交事实数据切片; - 主控确定性兜底:状态流转由严格的确定性逻辑与
max_steps强行保护,彻底绝缘了群聊死循环或客套闲聊的可能性。
落地核验:团队上多智能体前的 12 项选型自检清单
在决定为某个业务模块引入多智能体系统之前,建议技术团队与架构评审委员会对照以下 12 个具体指标逐项核验并打分:
维度一:业务必要性与流程解耦度
- 1. 非确定性验证:该业务是否无法通过编写确定性的 Python/Go 代码、脚本或传统工作流(DAG)实现?
- 2. 明确的子域隔离:各子任务之间是否存在清晰的领域边界与知识库边界,而非高度交织的模糊语义?
- 3. 工具冲突验证:单 Agent 挂载全部必要工具时,是否确实出现了高频的误选工具或注意力稀释现象?
维度二:上下文管理与状态可信度
- 4. 强类型状态存在:系统是否具备单一真实数据源(SSOT)的强类型全局状态定义,严禁自由无格式纯文本传话?
- 5. 上下文独立隔离:各个 Worker 是否仅接收最小必要切片,是否消除了上游长历史记录对下游的直接文本注入?
- 6. 事实校验兜底:上游 Agent 产出的核心结论,是否必须通过确定性脚本或数据库查询进行事实性核验后才允许写入全局状态?
维度三:成本、延迟与容错边界
- 7. 延迟 SLA 签署:业务方与产品经理是否已正式签署同意接受 15 秒至 60 秒以上的端到端调用耗时?
- 8. 单任务 Token 预算上限:系统是否为单次端到端请求设置了绝对的 Token 消耗上限与调用超时限制?
- 9. 最大步数硬熔断:主控调度器是否内置了确定性的最大步数看门狗,杜绝任何形式的乒乓死锁?
维度四:可观测性与生产运维
- 10. 单步状态持久化:系统能否对每一步的状态转移(State Transition)进行无损快照持久化,支持单点断点复现?
- 11. 单点失败降级分支:当某一个专精 Worker 调用失败或返回异常格式时,系统是否设计了明确的重试策略或确定性兜底分支?
- 12. 人工审批节点(HITL):所有涉及写数据库、发信息、调资金等不可逆操作的节点,是否均具备强制的人工审核挂起机制?
结语:从拟人化的狂欢走向工程学的收敛
任何新兴技术在诞生初期,都会经历一段“概念先行、比喻泛滥、过度设计”的探索阶段。多智能体系统凭借其极具科幻感和拟人化魅力的视觉表现,迅速俘获了大量的眼球,也让许多团队在技术虚火中迷失了软件工程的基本常识。
然而,软件工程发展几十年的历史反复证明了一条质朴的规律:
最优秀的系统架构,从来不是那些看起来最热闹、最像人类社会的复杂设计,而是那些能够以最小的复杂度、最低的成本和最确定的可观测性,稳定解决业务问题的收敛方案。
不要为了炫技而强行拼凑“虚拟办公室”,不要让概率性的自然语言侵蚀原本确定性的代码控制流。在绝大多数日常商业场景中,一个经过精细化工程治理的单 Agent 配合强大的结构化工具箱,其稳定性与性价比远超五个吵吵闹闹的虚拟专家。只有当业务真正面临不可调和的权限边界与上下文冲突时,才采用基于状态机的主从分层编排。
少一点角色扮演的拟人狂欢,多一点确定性工程的敬畏与克制——这才是决定一个 AI 项目能否真正走出 Demo、稳固立足生产环境的胜负手。
如果你正在为团队的 Agent 系统架构选型发愁,或者在由单 Agent 向多智能体演进的过程中遇到了延迟爆炸、状态漂移、死循环或难以调试排障的具体工程困境,欢迎前往 联系与交流 页面,与我们一同深入探讨更多关于企业级 AI Agent 与状态图编排架构的落地实战经验。