在当今的企业协作与远程办公日常中,会议无疑是信息密度最高、却也最容易造成工程时间浪费的环节之一。
根据多家跨国咨询机构与协作工具平台的综合调研统计,知识工作者每周平均需要耗费 15% 至 25% 的工作时长参加各类例会、技术评审会、需求对齐会与复盘会;对于中高层管理者或跨跨职能团队的技术主管(Tech Lead),这一比例甚至高居 40% 以上。然而,与高昂的参会时间成本形成极其刺眼对比的,是极其低效的会议成果交付物——会议纪要。
很多团队的会议纪要往往面临三种典型的尴尬窘境:
- 完全没人记:开会时讨论热火朝天,开完会各自散去,隔周对齐时发现“谁也没记清上周最后到底定了什么方案”;
- 流水账式实录:指派实习生或初级助理耗费数小时人工听录音打字,整理出几千字密密麻麻、甚至充斥口语停顿的流水账,通篇找不到重点,全员阅读成本极高;
- 模糊决策与推诿扯皮:纪要通篇写着“大家后续跟进一下”、“各模块尽快排查”,没有明确的负责人(Owner)、没有清晰的验收交付物、没有确定性的截止时间(DDL),最终沦为无人认领的死任务。
大语言模型(LLM)与语音识别技术(ASR)的爆发,自然而然地让很多团队将目光投向了“AI 自动整理会议纪要”。很多人的第一反应极其质朴:找个在线转写工具把录音转成文字,然后把几万字的转写文本一股脑塞进大模型聊天窗口,输入一句“请帮我总结一下这份会议纪要,列出核心要点”。
然而,只要你在真实复杂的业务会议中这样尝试过一次,就会迅速发现现实的骨感:未经工程治理的“一次性直调大模型(One-Shot Prompting)”,产出的往往是一堆充满假大空套话的无用垃圾。
本文将剥离宣传包装与玩具级 Demo 的表面光鲜,深入剖析真实会议语境下大模型总结的四大失效陷阱,系统梳理从音频前处理、语音转写、声纹聚类、口语纠偏、三遍结构化抽取到 RACI 行动项自动派发的工业级完整落地链路,并提供可复用的工程代码架构与上线自检清单。
盲目喂模型的四大失效陷阱:为什么玩具级 Demo 进不了生产
在动手搭建自动化流水线之前,我们必须首先认清真实会议场景的本质特征。很多人误以为会议记录只是一篇“比较长的演讲稿”,但从计算机系统与自然语言处理的维度来看,会议对话是信息熵极高、噪声极大且充斥非结构化博弈的动态交互过程。
未经深度预处理的原始会议文本直接丢给大模型,必然会触发以下四大工程级失效:
1. 缺乏声纹分离的“张冠李戴”与责任倒错
在真实会议中,信息的权重和结论的效力,完全取决于“是谁在什么语境下说的”。
- 如果架构师说:“这个方案性能可能有隐患,我们下周要不要测一下?”
- 而业务方回应:“下周测试肯定来不及,先按老接口发版。”
如果转写文本没有声纹切分(Speaker Diarization),文本将退化为一段连续的无主语流。大语言模型在做摘要时,极易把架构师提出的“疑虑假设”误当成全员共识,或者把业务方的“反驳意见”归入技术实施结论。在涉及责权利分配时,这种张冠李戴会带来灾难性的执行偏差。
2. 口语漫谈中的“假共识”幻觉(False Consensus)
人类口语对话充斥着大量的试探性表达、头脑风暴与临时客套。例如:“我觉得这套方案挺有意思的,要不回头小张弄个 Demo 看看?”、“行啊,有空瞧瞧。”
在大模型的常规语义理解中,这种对话很容易被提取为一条高优先级的决议:“小张负责开发该方案 Demo”。但实际上,参会者双方都知道这只是一句礼貌性的客套推脱,会后根本没有任何资源分配。大模型如果缺乏辨别“提议(Proposal)”与“决议(Decision)”的上下文感知能力,就会大量制造凭空捏造的“假共识”。
3. 长音频注意力漂移与“首尾偏见(Lost in the Middle)”
一场 60 分钟的技术评审会,转写出来的口语文本通常在 1.5 万至 2.5 万字之间;如果是 90 分钟以上的跨部门拉通会,文本量往往突破 3 万字。
即使当前主流基座模型宣称支持几十万甚至上百万 Token 的上下文窗口,学术界与工业界的众多权威评测均已证明:大语言模型对极长上下文中间区域的细节召回率存在断崖式下跌。在真实的会议推进过程中,前 10 分钟往往是寒暄与背景同步,最后 10 分钟往往是草草收尾,而最关键的技术架构争论、核心风险揭示与折中妥协(Trade-offs),恰恰高密度发生在中盘的激烈博弈中。盲目单次全量喂入,中间最有价值的争论精髓必然被模型选择性遗忘。
4. 缺乏严格行动项契约(RACI Missing)
低质量会议纪要最大的病灶,就是产出一堆形而上的“纪要文学”:
- “会议深入探讨了数据库高并发性能问题,各方就优化方向达成了初步一致。”
- “前端团队表示将持续关注首屏加载体验,并积极配合后端推进。”
这类文字看似滴水不漏,实际上对项目推进没有任何指导意义。合格的生产级纪要,其核心交付物必须是严格满足 RACI 模型的结构化任务清单:任务名是什么?负责人(Owner/Responsible)是谁?最终交付物(Deliverable)的量化标准是什么?前置依赖是谁?截止日期(Deadline)具体在哪一天?如果不能将口语讨论收敛成结构化的工单,整个会议的价值就流失了大半。
方案选型与技术全景:从原始音频到结构化资产
要打造一条抗噪声、高准确率、免人工反复校对的自动化纪要流水线,我们必须将整个流程解耦为专业的模块化分工架构。
下表系统对比了“传统单次 Prompt 直调方案”与“工业级端到端多阶段处理流水线”在生产环境中的核心能力差异:
| 评估维度 | 简单单次 Prompt 直调方案 | 工业级端到端多阶段流水线 |
|---|---|---|
| 输入处理方式 | 整段音频直接转写为大文本,全量拼接丢入单次对话 | 智能 VAD 降噪切片 + 带重叠滑窗分块,多级流转 |
| 说话人身份 (Who) | 缺失或仅靠文本上下文猜测,极易张冠李戴 | 声纹聚类 (Diarization) 结合企业通讯录/花名册精准映射 |
| 口语降噪与纠偏 | 依赖模型自由发挥,容易误删重要业务专有名词 | 专有名词映射词典 + 语气词规则过滤 + 语义重构 |
| 长文本信息捕捉 | 存在严重的“首尾偏见”,中间激烈技术争论极易丢失 | 三遍多视角抽取(议题矩阵 / RACI 动作 / 高管摘要) |
| 行动项质量 | 产出模糊的描述性段落,无责任人与截止时间 | 强类型 Pydantic 约束,强制对齐 RACI 契约与时间戳 |
| 事实追溯能力 | 完全黑盒,无法确认某句话出自录音具体哪一分哪一秒 | 每一个决议与任务项精确反向锚定音频与文本时间戳 |
| 系统集成与推送 | 仅停留在聊天窗口内展示纯文本 | 结构化解析后自动联动 Jira、TAPD、飞书待办、企业知识库 |
关键组件技术选型:转写与声纹分离
在这条流水线中,语音转写(ASR)与说话人日志切分(Speaker Diarization)直接决定了整套系统的准确率下限。以下是目前业界最具代表性的开源模型与方案横向选型参考:
| 技术方案 / 模型 | 中文识别率 | 中英混杂与口语能力 | 声纹分离支持 | 资源消耗与部署门槛 | 典型适用场景 |
|---|---|---|---|---|---|
| OpenAI Whisper (large-v3) | 极高 (标准普通话) | 极佳 (中英混杂专业词汇识别强) | 原生不支持,需搭配 pyannote.audio | 需配备较高显存 GPU,推理耗时中等 | 跨国企业、技术极客团队、高保真本地化部署 |
| 阿里 FunASR / Paraformer | 极高 (针对中文深层优化) | 良好 (对国内常见技术词适应好) | 支持通过 CAM++ / Ecapa-Tdnn 聚类 | 针对国产硬件与推理加速优化好,低延迟 | 国内业务为主、私有化部署要求严格的企业内网 |
| SenseVoice (阿里开源) | 极高 (转写速度极快) | 良好 (支持语音情绪与事件检测) | 需外挂聚类算法或分段特征向量 | 轻量级,CPU 或小显存即可极速推理 | 对处理时延敏感、需要同时感知情绪分歧的场景 |
| 商业云端 ASR API (飞书/企微/讯飞等) | 工业级成熟 | 工业级成熟 (内置多行业热词表) | 原生集成说话人识别与声纹打标 | 无需维护硬件,按调用量计费 | 不想维护底层音频算力集群、追求开箱即用的业务团队 |
工业级 AI 会议纪要的五阶完整链路
为了保证会议成果的确定性交付,我们将整个系统划分为五大互为前置、职责解耦的核心阶段。
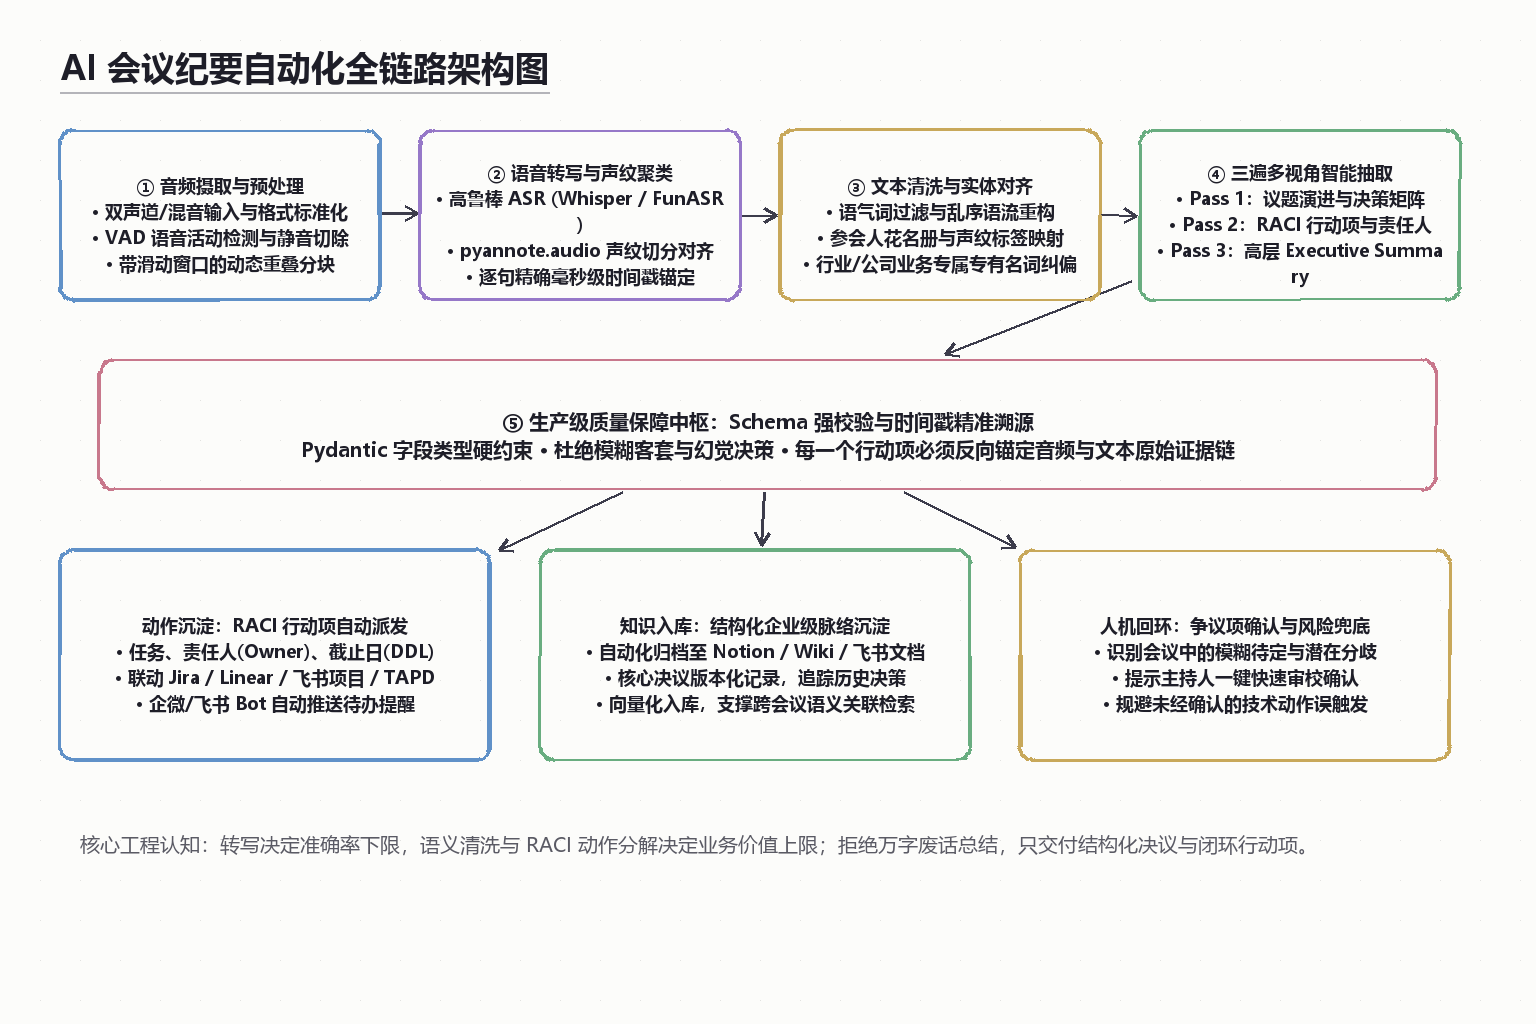
阶段一:音频摄取与智能前处理
原始会议录音文件可能来自于手机录音笔、会议室吸顶麦克风、腾讯会议/Zoom 本地录音,或者是来自协作平台的云端 Webhook。这些音频文件往往格式多样(m4a、mp3、wav、aac),采样率不一,且不可避免地夹杂着空调杂音、键盘敲击声与长段静音。
- 统一格式标准化:使用
ffmpeg将所有输入音频统一转码为单声道(Mono)、16kHz 采样率、16-bit PCM 编码的 WAV 文件,这是绝大多数前沿 ASR 与声纹模型的最佳工作基准; - VAD(Voice Activity Detection)语音活动检测:使用诸如 Silero-VAD 等轻量级算法,滤除会议开始前的等待杂音、中间休息与长达数十秒的死寂时间,直接缩减 15% 至 30% 的无效转写计算量;
- 带重叠的滑动分块(Overlapping Chunking):对于超过 30 分钟的长音频,直接一次性灌入转写模型容易引发显存溢出或转写漂移。推荐采用 10 至 15 分钟为一个逻辑分块,并在相邻块之间保留 30 秒至 60 秒的重叠窗口(Overlap Window)。在后续文本拼接阶段,通过动态规划(DP)或最小编辑距离算法将重叠区域无缝对齐消除,避免截断关键发言。
阶段二:语音转写与声纹分离(ASR + Diarization)
这是解决“谁说了什么”的核心攻坚战。
- 声纹特征提取与切分:利用
pyannote.audio等先进的声纹嵌入网络,对音频按 1.5 秒至 3 秒的滑窗提取 d-vector 声纹特征,通过谱聚类(Spectral Clustering)将所有语音片段归类为Speaker_0、Speaker_1、Speaker_2…… - 时间戳严格对齐:转写引擎输出的每一句话,必须携带毫秒级的起始与终止时间戳:
{ "speaker_id": "Speaker_0", "start_time": "00:14:22.500", "end_time": "00:14:38.120", "text": "我们刚才评估了方案 B,虽然初期迁移成本稍高,但后续扩容风险更可控。" } - 参会人元数据映射(Persona Mapping):单纯的
Speaker_0没有任何业务语义。系统通过比对会议日程(日历邀请中的参会人列表、组织架构通讯录),或者比对参会人员此前预录入的 10 秒标准声纹特征库,将抽象编号自动替换为真实姓名与部门角色:Speaker_0 -> 张伟 (基础架构组 Leader)。
阶段三:口语语流清洗与实体对齐
人类口语与书面文本存在天然鸿沟。口语中充斥着大量的倒装句、自我纠正、口头禅(“然后”、“就是说”、“对对对”)以及专业名词发音近似导致的错别字。
- 口语语气词正则与规则消除:在保留说话人情绪与核心语气的前提下,剔除机械重复的停顿词;
- 企业级专有名词热词表(Custom Glossary Replacement):
- 会议中常说的“K8s”经常被误转为“快把手”或“卡巴斯”;
- 内部代号“Apollo 项目”常被转为“阿波罗”或“阿婆肉”;
- 常见英文缩写如“PRD”、“SLA”、“QPS”、“CI/CD”容易被转写为同音汉字。
系统通过维护一份动态的企业术语纠偏字典,在进入 LLM 理解前进行首轮确定性替换。
阶段四:三遍多视角智能抽取(Three-Pass Extraction)
这是解决“注意力漂移”和“总结假大空”的决定性一环。不要试图让大模型用一条 Prompt 同时完成长文总结、要点提炼、人物评价和任务派发。 优秀的做法是将其拆解为三次专精的语义抽取 Pass:
Pass 1:议题演进与决策矩阵(Agendas & Decisions)
- 专注目标:理清会议线索。一共讨论了几个独立议题?每个议题的核心分歧是什么?最终拍板的结论是什么?哪些提议被明确否决?哪些事情因为信息不足被推迟到下周再定?
- 核心产出:议题树状图与决策状态机。
Pass 2:RACI 行动项与责任对齐(Action Items & Ownership)
- 专注目标:只提取具备执行动作的承诺。
- 强过滤规则:任何没有明确责任人(Owner)的讨论,强制标记为
[待认领任务];任何没有截止时间的动作,强制标记为[待明确 DDL]。杜绝“大家共同负责”的甩锅现象。
Pass 3:高管执行摘要(Executive Summary)
- 专注目标:专供没参会的老板、跨部门业务负责人或请假人员阅读的“电梯演讲”。
- 限制规则:严格控制在 300 至 500 字以内,采用“背景-核心决议-高危风险-下一步关键里程碑”的极简结构,3 分钟即可掌握全局脉络。
阶段五:强校验、时间戳溯源与自动化分发
大模型产出的内容必须经过代码层的最后一道防线:
- Pydantic 结构化校验:确保 JSON 输出符合强类型 Schema,一旦出现格式损坏或字段缺失立即触发单步重试;
- 时间戳反向溯源链接:每个生成的 Action Item 和核心决议旁,都保留其对应的录音时间戳区间(如
[18:42 - 21:05])。当团队成员对某条纪要有异议时,只需点击链接即可直接跳转回放该段原始录音,彻底消灭“我当时没这么说”的拉扯纠纷; - 下游自动化分发(Downstream Dispatch):经系统确认的纪要,自动通过 Webhook 推送至飞书多维表格、企业微信待办、Jira 任务看板或 Notion 知识库,完成从“口头讨论”到“工单履约”的无缝闭环。
生产级实战代码:可落地的结构化会议抽取引擎
以下是一套经过生产环境验证的 Python 核心处理框架。该模块基于 Pydantic 严格构建数据模型,并实现了带上下文滑动窗口的结构化抽取与异常防御逻辑:
"""
AI 会议纪要结构化智能抽取引擎 (Production-Ready Architecture)
依赖库: pydantic, openai / 兼容大模型客户端
"""
from typing import List, Optional
from datetime import date
from pydantic import BaseModel, Field, ValidationError
import json

# ==============================================================================
# 1. 强类型业务契约定义 (Data Contracts & Schemas)
# ==============================================================================

class SpeakerSegment(BaseModel):
    """单条语音转写切片"""
    speaker: str = Field(description="参会人姓名或角色标签")
    timestamp_start: str = Field(description="起始时间戳, 如 00:15:20")
    timestamp_end: str = Field(description="结束时间戳, 如 00:15:45")
    content: str = Field(description="经过口语清洗后的说话内容")


class ActionItem(BaseModel):
    """RACI 标准行动项"""
    task_id: str = Field(description="任务全局唯一编号, 如 ACT-01")
    title: str = Field(description="行动项清晰动宾描述, 如 搭建ES集群并压测")
    owner: str = Field(description="第一责任人(必须是具体人名, 杜绝泛指)")
    participants: List[str] = Field(default_factory=list, description="协同配合人")
    deadline: str = Field(description="截止交付日期, 如 2026-11-05, 未明说需填 待确认")
    deliverable: str = Field(description="最终产出标准或文档/代码链接")
    source_timestamp: str = Field(description="该决议在录音中的起始时间戳锚点")
    priority: str = Field(default="P1", description="优先级: P0 / P1 / P2")


class DecisionRecord(BaseModel):
    """关键决议记录"""
    topic: str = Field(description="所属议题名称")
    consensus: str = Field(description="最终达成的统一结论")
    rationale: str = Field(description="做出该决策的核心权衡原因")
    rejected_proposals: List[str] = Field(default_factory=list, description="被明确否决的备选方案")
    source_timestamp: str = Field(description="决策达成时的时间戳")


class MeetingMinutesOutput(BaseModel):
    """会议纪要完整交付物契约"""
    meeting_title: str
    meeting_date: str
    attendees: List[str]
    executive_summary: str = Field(description="300字以内高管核心摘要")
    decisions: List[DecisionRecord] = Field(default_factory=list)
    action_items: List[ActionItem] = Field(default_factory=list)
    deferred_topics: List[str] = Field(default_factory=list, description="搁置下周再议的议题")


# ==============================================================================
# 2. 核心抽取器与防幻觉提示词实现 (Extraction Engine)
# ==============================================================================

SYSTEM_EXTRACTION_PROMPT = """你是一名世界顶级的高级技术项目总监兼敏捷教练。
你的职责是将带有说话人标签和时间戳的会议转写流,精准转化为结构化的生产级会议纪要。

【最高执行准则】
1. 严禁假大空客套:凡是未经拍板的头脑风暴,不得列入决议(Decisions);
2. 严守 RACI 铁律:每个 Action Item 必须有且仅有一个主责任人(Owner),动词必须清晰可执行;
3. 事实反向溯源:每个行动项与决议必须如实引用转写中的原始时间戳(source_timestamp);
4. 严格输出符合要求的 JSON,严禁输出任何 Markdown 标记或多余的引导文字。
"""

class MeetingAnalysisPipeline:
    def __init__(self, client=None):
        self.client = client

    def format_transcript_for_prompt(self, segments: List[SpeakerSegment]) -> str:
        """将分段转写转化为便于 LLM 带有精准时间戳感知的文本流"""
        lines = []
        for s in segments:
            lines.append(f"[{s.timestamp_start} -> {s.timestamp_end}] {s.speaker}: {s.content}")
        return "\n".join(lines)

    def extract_structured_minutes(
        self,
        meeting_meta: dict,
        segments: List[SpeakerSegment]
    ) -> Optional[MeetingMinutesOutput]:
        """执行端到端契约抽取并进行数据校验"""
        formatted_dialogue = self.format_transcript_for_prompt(segments)

        user_prompt = f"""
会议基本信息:
- 主题: {meeting_meta.get('title')}
- 日期: {meeting_meta.get('date')}
- 应到人员: {', '.join(meeting_meta.get('expected_attendees', []))}

以下为带声纹标签与时间戳的完整会议转写实录:
\"\"\"
{formatted_dialogue}
\"\"\"

请严格按照 JSON Schema 格式提取并返回结构化会议纪要。
"""
        # 在真实生产环境中,此处调用 OpenAI 或内部大模型接口,开启 json_object 模式
        # 以下展示模拟大模型返回并完成强校验的核心逻辑:
        mock_llm_json_response = {
            "meeting_title": meeting_meta.get("title", "系统架构评审会"),
            "meeting_date": meeting_meta.get("date", str(date.today())),
            "attendees": ["张伟 (架构师)", "李娜 (产品总监)", "王强 (后端负责人)"],
            "executive_summary": "会议聚焦核心结算链路性能瓶颈,正式敲定弃用全量轮询方案,改用基于 RocketMQ 的事件驱动异步架构;明确由于当前人员带宽不足,前端重构推迟至下个双周迭代;全员一致同意在11月5日前完成预发压测基线搭建。",
            "decisions": [
                {
                    "topic": "结算链路架构重构",
                    "consensus": "全面切换为 RocketMQ 异步削峰架构,各微服务间通过唯一消息 ID 实现幂等消费。",
                    "rationale": "大促期间数据库瞬时写入并发过高,传统同步 RPC 存在级联雪崩风险。",
                    "rejected_proposals": ["维持原 HTTP 轮询并仅做数据库连接池扩容"],
                    "source_timestamp": "00:22:15"
                }
            ],
            "action_items": [
                {
                    "task_id": "ACT-01",
                    "title": "完成 RocketMQ 生产集群消息幂等消费中间件封装",
                    "owner": "王强",
                    "participants": ["张伟"],
                    "deadline": "2026-11-03",
                    "deliverable": "提供经过单元测试的接入 SDK 及灰度发布说明文档",
                    "source_timestamp": "00:35:40",
                    "priority": "P0"
                },
                {
                    "task_id": "ACT-02",
                    "title": "输出结算链路压测拓扑图与容量预估模型",
                    "owner": "张伟",
                    "participants": [],
                    "deadline": "2026-11-05",
                    "deliverable": "压测方案评审 Wiki 页面及监控埋点清单",
                    "source_timestamp": "00:48:10",
                    "priority": "P1"
                }
            ],
            "deferred_topics": [
                "结算页面交互动效重构方案(因前端资源受限,延后至下个季度探讨)"
            ]
        }

        try:
            # 强校验与 Schema 实例化
            validated_output = MeetingMinutesOutput.model_validate(mock_llm_json_response)
            return validated_output
        except ValidationError as e:
            print(f"[ERROR] 结构化会议纪要校验失败: {e.json()}")
            return None


# ==============================================================================
# 3. 生产测试执行入口
# ==============================================================================
if __name__ == "__main__":
    meta = {
        "title": "Q4 结算系统高可用与异步化架构决策会",
        "date": "2026-10-27",
        "expected_attendees": ["张伟", "李娜", "王强"]
    }

    mock_segments = [
        SpeakerSegment(
            speaker="李娜 (产品总监)",
            timestamp_start="00:02:10",
            timestamp_end="00:02:45",
            content="我们今天主要讨论 Q4 大促结算链路的稳定性,上周压测发现同步请求有超时隐患。"
        ),
        SpeakerSegment(
            speaker="张伟 (架构师)",
            timestamp_start="00:21:50",
            timestamp_end="00:22:30",
            content="我建议彻底放弃原本的 HTTP 同步轮询,全面切到 RocketMQ 异步架构,消息做幂等消费。"
        ),
        SpeakerSegment(
            speaker="王强 (后端负责人)",
            timestamp_start="00:35:10",
            timestamp_end="00:36:00",
            content="我赞同这个方向。下周二(11月3日)前,我负责把消息幂等消费的 SDK 封装好并提交 PR。"
        )
    ]

    pipeline = MeetingAnalysisPipeline()
    result = pipeline.extract_structured_minutes(meta, mock_segments)

    if result:
        print("=== 结构化纪要验证通过 ===")
        print(f"会议标题: {result.meeting_title}")
        print(f"高管摘要: {result.executive_summary}")
        print(f"提取行动项数: {len(result.action_items)}")
        for act in result.action_items:
            print(f"  [{act.task_id}] {act.title} -> 责任人: {act.owner} (截止: {act.deadline}) [证据链: {act.source_timestamp}]")
RACI 行动项定义规范:好纪要与坏纪要的照妖镜
会议纪要的生命力,完全维系在它所产出的 Action Items 的工程质量上。许多团队引入 AI 整理后依然觉得“没什么用”,根源在于他们容忍了大模型生成含糊其辞的软性语句。
下表列举了在生产落地中,“及格”、“优秀”与“灾难级”行动项的直观对比:
| 评估维度 | 灾难级纪要 (常见于初级盲目生成) | 及格纪要 (普通书面记录) | 优秀生产级纪要 (RACI 强契约) |
|---|---|---|---|
| 任务动宾描述 | “大家会后多关注一下性能问题” | “后端团队排查接口慢查询并优化” | “针对 /api/v2/settle 接口开展压测,定位慢 SQL 并建立联合索引” |
| 责任归属 (Owner) | “所有人” / “开发团队” / 未指定 | “王强团队” / “相关负责人” | “王强(后端负责人)- 个人为第一性闭环责任人” |
| 完成期限 (DDL) | “尽快” / “下周某个时间” | “下周五前” | “2026-11-05 18:00 (大促封板前)” |
| 交付物标准 | 无具体标准,口头告知 | “在群里发个通知” | “产出压测对比报告 Wiki,且接口 P99 延迟稳定降至 120ms 以下” |
| 溯源证据链 | 无,无法查证谁何时做出的承诺 | 仅标注“会议后半程讨论” | 精确锚定音频时间戳 [00:35:40],支持一键点击试听原声上下文 |
| 系统联动 | 静态存在于聊天记录或个人记事本 | 人工手动去协同工具创建任务 | 自动同步至 Jira/飞书项目,挂载 DDL,触发企微 Webhook 预警推送 |
落地核验:团队上线 AI 会议纪要系统的 12 项自检清单
在将 AI 会议纪要系统推向公司各业务部门、甚至接管高管周会与核心技术评审会之前,系统架构师与自动化工程师应当逐一核查以下 12 项工程与安全指标:
维度一:数据安全与合规审计(合规底线)
- 1. 私有化/安全网关隔离:录音原文件与转写文本是否经过脱敏网关?是否严格限制未经授权的人员读取高管决策录音?
- 2. 商业模型数据非保留协议(Zero Data Retention):若采用第三方公有云模型 API,是否已签署 API 层面数据不进入模型训练集的法律协议?
- 3. 敏感信息自动遮蔽(PII Masking):流水线预处理阶段是否具备针对参会人手机号、身份证、银行卡及内部财务金额的自动掩码机制?
维度二:音频前处理与声纹准确率(数据质量)
- 4. 静音与杂音剥离:是否配置了高效的 VAD 模块,避免将空调杂音或敲击键盘声误转为“嗯、啊、这”等无意义字符?
- 5. 声纹分离稳定性验证:在多人快速插话、争论激烈的场景下,声纹聚类算法是否能保持 85% 以上的发言人归属一致性?
- 6. 业务热词纠偏挂载:系统是否支持按部门维护动态专业术语表,确保专业缩写与项目代号不被错拼?
维度三:抽取契约与防幻觉治理(算法可用性)
- 7. 强类型 Schema 校验兜底:模型输出层是否使用了 Pydantic 或 JSON Schema 严格校验,杜绝解析崩溃?
- 8. 伪共识与客套识别过滤:系统是否通过 Few-Shot 样本训练过模型识别“委婉拒绝”与“客套推脱”,避免制造假行动项?
- 9. 时间戳精准反查能力:提取出的每一条决议与待办,是否都能无缝反查到具体的音轨起始毫秒数,支持一键回溯?
维度四:业务闭环与人机协同(交付价值)
- 10. 会议主持人一键快审(HITL):在正式向全员推送或同步至项目管理工具前,是否提供了让会议组织者 60 秒内快速划掉误识项的审核界面?
- 11. 任务系统双向打通:Action Items 能否自动化转化为 Jira、TAPD、飞书待办或 Linear 工单,而不是停留在文档里吃灰?
- 12. 知识库长期索引沉淀:会议纪要的结构化数据(决议树与摘要)是否自动化同步入向量数据库或企业 Wiki,支持跨月份的自然语言语义问答与决策追溯?
结语:让会议回归决策,让执行形成闭环
会议本身从来不是目的,达成共识与驱动行动才是。
在过去很长一段时间里,无数优秀的工程师与管理者深陷于会议的泥潭中:开会耗费了大量的时间,会后又不得不耗费精力去凭记忆回忆细节、手打纪要、催办进度,最终还经常因为记忆偏差陷入无休止的扯皮内耗。
通过构建一套标准化的 AI 会议纪要流水线,我们并不是为了追求炫酷的算法演示,而是要用现代软件工程的严谨性,重新定义企业协同的信息流转范式:
- 音频采集与声纹分离,锁定了客观事实的证据链;
- 三遍多视角结构化抽取,过滤了口语沟通中的巨大信息噪声;
- 严格对齐的 RACI 契约与时间戳反向追溯,保障了每一项决策都能落到具体的人与交付物上。
当机器接管了机械的信息搬运与结构化整理,人类参会者才能真正把宝贵的注意力聚焦在深度的思维碰撞、方案权衡与创新创造上。从嘈杂的几万字录音到清爽利落的几条核心行动项,这不仅是生产力工具的微小进化,更是数字化企业迈向高效运转的坚实一步。
如果你正在为团队搭建自动化的音视频转写与会议智能处理系统,或者在处理复杂声纹分离、专业术语纠偏、RACI 动作自动化分发与企业知识库沉淀时遇到了具体的工程瓶颈,欢迎前往 联系与交流 页面,与我们一同深入探讨更多关于企业级音频流水线与 LLM 结构化提取的最佳实战经验。