在构建基于检索增强生成(RAG)、智能客服、知识库检索或个性化推荐系统时,技术团队面临的第一个重大基础设施决策往往是:选择哪一款向量数据库?
过去两年间,AI 基建领域涌现出了数十种向量存储与检索解决方案:从专为向量检索设计的独立系统(如 Milvus、Qdrant、Chroma、Pinecone、Weaviate),到传统关系型数据库的插件扩展(如 PostgreSQL 的 pgvector、MySQL 的 HeatWave),再到老牌全文搜索引擎的原生支持(如 Elasticsearch、OpenSearch),以及列式与分析型数据库的内嵌集成(如 LanceDB、DuckDB)。
面对纷繁复杂的选项,许多团队容易陷入两种极端:要么盲目迷信基准测试榜单(Benchmark),在业务刚起步、文档量仅几万条时就重度引入依赖极多的分布式向量集群;要么低估了向量索引对内存的消耗与元数据过滤的严苛要求,在生产流量上涨后遭遇延迟雪崩与内存溢出(OOM)。
本文将跳脱出脱离实际的极限 QPS 跑分,从真实业务场景、数据生命周期、技术栈兼容性与综合持有成本出发,全面拆解各主流向量数据库的技术流派、底层索引权衡、决策漏斗与生产避坑准则。
一、被神话的向量数据库与真实的工程挑战
在深入具体组件前,我们首先需要澄清一个在工程实践中被严重低估的事实:向量检索(ANN,近似最近邻搜索)从来都不是独立于业务系统之外的“银弹”,它必须深度依附于业务数据生命周期。
1. 异构双写与一致性地狱
如果选择独立的外部向量数据库,你的架构中必然存在至少两套存储系统:一套是存放真实业务实体(用户、订单、权限、原始文档正文、更新时间)的关系型数据库(如 PostgreSQL / MySQL),另一套是存放向量特征与文档 ID 的独立向量库。
当原始业务数据发生更新或物理删除时,系统必须同时更新向量库。然而,外部向量库通常不提供分布式跨库 XA 事务,网络抖动或服务重启必然导致数据不一致:
- 业务端已删除敏感文件,但向量库仍存在对应向量,大模型依旧将其检索出来并回答给用户;
- 业务端已修改权限范围,向量库中的元数据未能同步刷新,导致数据越权泄露;
- 异步消息队列(MQ)重试乱序,旧版本向量覆盖新版本向量。
2. 内存膨胀与“买不起”的硬件账单
与传统数据库利用 B+ 树或 LSM 树大量依赖磁盘不同,为了实现毫秒级的余弦相似度或欧式距离计算,主流的高召回向量索引(如 HNSW)默认需要将全部向量数据以及稠密的导航图网络完整常驻在内存中。
以常见的 1536 维向量为例,单个浮点数占 4 字节,单条向量纯数据即占用 6.14 KB。若存储 1000 万条向量,仅原始向量数据就需要约 60 GB 物理内存。再叠加 HNSW 构图所需要的双向邻居指针开销(通常需要 1.5 倍到 2 倍的内存膨胀),整机内存开销将迅速突破 150 GB 以上。若没有对冷热分离和量化(Quantization)进行深入调优,高昂的物理机或云实例内存费用将直接吞噬业务利润。
3. 元数据过滤(Metadata Filtering)的性能陷阱
在真实的 RAG 或知识检索场景中,纯粹的“语义相似度前 10 名(Top-K)”几乎无法直接交付。用户提问往往伴随着严苛的业务条件约束,例如:WHERE department_id = 'finance' AND created_year >= 2025 AND is_deleted = false
很多在学术基准中表现惊艳的向量索引,一旦叠加高选择比(例如只筛选出全库 0.1% 的数据)的元数据过滤,其查询性能会断崖式下跌 10 倍以上,甚至直接退化为全表暴力扫描。
因此,选型的核心不是“谁的纯向量搜索算法跑得更快”,而是谁能以最低的工程代价、最稳健的一致性以及合理的资源消耗,解决你特定业务场景下的混合查询与数据治理问题。
二、四大技术流派横向拆解与架构特征
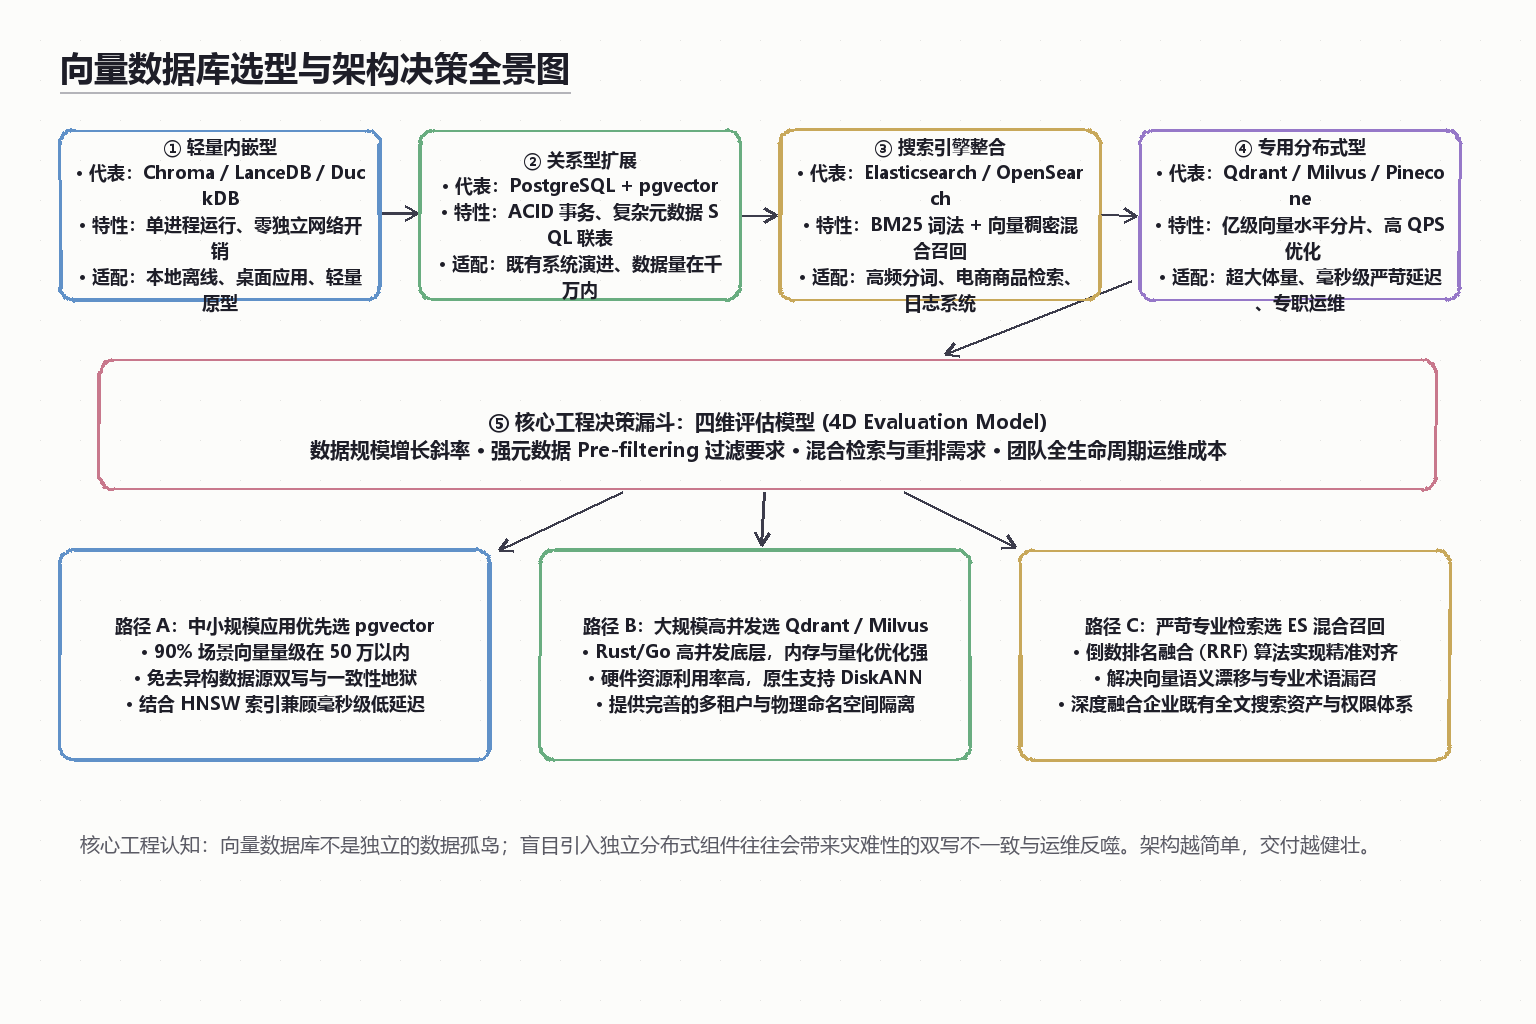
当前市场上的向量存储方案,本质上可以划分为四大技术流派。了解各自的底层基因,是做出合理选型的前提。
流派 1:轻量嵌入式向量库(In-Process / Embedded)
- 代表项目:LanceDB、Chroma(内存/单机文件模式)、DuckDB (duckdb-vss)、SQLite-vss。
- 架构特点:
- 像 SQLite 一样直接作为库(Library)打包进应用程序进程内运行,无需部署独立守护进程或中间件集群。
- 数据持久化为本地单文件或基于列式存储格式(如 Lance / Parquet)。
- 没有客户端与服务端之间的网络 RPC 序列化开销,单机单进程读写延迟极低。
- 局限性:单节点垂直扩展,缺乏开箱即用的多节点分布式高可用、自动故障转移与细粒度分布式权限控制。
流派 2:关系型数据库原生扩展(Relational Vector Extension)
- 代表项目:PostgreSQL + pgvector(以及针对高吞吐量优化的 pgvectorscale 扩展)。
- 架构特点:
- 将向量作为关系表中的一种原生列类型(
VECTOR(dim))。 - 原生支持完整的 ACID 事务,完美消除双写不一致难题。
- 支持将向量计算直接嵌入复杂的 SQL 联表查询、窗口函数与行级安全策略(Row-Level Security, RLS)。
- 复用成熟的数据库备份工具(pg_dump、WAL 归档、物理流复制)、监控和高可用主从架构。
- 将向量作为关系表中的一种原生列类型(
- 局限性:在亿级数据量且超高并发写入的极端场景下,PostgreSQL 的连接池开销与 VACUUM 维护代价会成为瓶颈。
流派 3:搜索引擎混合检索体系(Search Engine Hybrid)
- 代表项目:Elasticsearch、OpenSearch。
- 架构特点:
- 天然具备工业界最成熟的中文分词(IK、Jieba)、词法倒排索引与 BM25 算法支持。
- 在同一套索引体系中原生支持 BM25 文本打分与 Dense Vector(稠密向量)得分的倒数排名融合(RRF)。
- 拥有极度强大的元数据布尔过滤、地理位置过滤、聚合统计与多租户索引切片能力。
- 局限性:Java 虚拟机(JVM)堆内存占用大,建索引 CPU 开销高;纯向量索引的硬件计算加速不如 Rust/C++ 专有向量引擎极致。
流派 4:专职分布式向量数据库(Dedicated Distributed Vector DB)
- 代表项目:Qdrant、Milvus、Pinecone(全托管 SaaS)、Weaviate。
- 架构特点:
- 核心计算引擎采用 Rust、Go 或 C++ 编写,充分榨干 SIMD(AVX-512、NEON)等 CPU 向量化指令集。
- 专为百亿级高并发分片(Sharding)、水平扩展(Scale-Out)与节点故障自愈设计。
- 深度支持先进的图索引与量化算法(HNSW、IVF-PQ、SCaNN、DiskANN),原生的多租户 Collection 隔离机制。
- 局限性:引入了全新的异构存储组件;部署拓扑复杂(如 Milvus 分布式依赖 MinIO、etcd、Kafka/Pulsar);团队运维曲线陡峭。
四大流派全方位对比矩阵
| 评估维度 | 轻量嵌入式 (如 LanceDB) | 关系型扩展 (pgvector) | 搜索引擎 (Elasticsearch) | 专用分布式 (如 Qdrant/Milvus) |
|---|---|---|---|---|
| 推荐数据体量 | 10 万 ~ 100 万 | 10 万 ~ 500 万 | 100 万 ~ 5000 万 | 500 万 ~ 数亿级 |
| 部署与运维复杂度 | 极低(零运维,单包引入) | 低(复用既有 PG 运维设施) | 中等(需管理 JVM 与集群分片) | 较高(需管理专用集群拓扑) |
| 事务与一致性 | 取决于底层(LanceDB 支持 ACID) | 强 ACID 保证,天然抗双写风险 | 近实时(NRT),最终一致性 | 最终一致性,需业务补偿机制 |
| 元数据过滤性能 | 良好(列式扫描推下) | 极强(原生 SQL 索引联合优化) | 极强(成熟的倒排位图布尔过滤) | 良好 ~ 极强(取决于单阶段过滤实现) |
| 混合检索支持 | 依赖外部构建或特定实现 | 需配合 pg_trgm / tsvector 联合计算 | 原生开箱即用(BM25 + 向量 RRF) | 部分原生支持(如 Qdrant 稀疏向量) |
| 内存依赖度 | 较低(基于磁盘与 NVMe 优化) | 较高(受限于 shared_buffers 与内存图) | 较高(堆内堆外兼顾) | 极高(但支持精细化量化与磁盘索引) |
| 最佳适用场景 | 客户端软件、开发原型、无状态容器 | 绝大多数通用企业 RAG 与内部中台 | 电商搜索、专业文档检索、混合搜索 | 超大规模多租户 SaaS、亿级图搜/音搜 |
三、底层算法与索引权衡:HNSW、IVF 与量化技术
选用向量数据库时,决定系统性能与成本底线的并非品牌名,而是其底层支持的索引结构(Index Structure)与量化方案(Quantization)。
[高维原始浮点向量 (FP32)]
        │
        ├─► 追求极限召回率与低延迟 ──► HNSW (分层可导航小世界图) ──► 内存占用极高
        │
        ├─► 追求建索速度与内存节省 ──► IVF-FLAT (倒排聚类文件)    ──► 召回率略低,易倾斜
        │
        ├─► 追求海量规模与成本控制 ──► 标量量化 (SQ) / 乘积量化 (PQ) ──► 内存节省 70%~90%,精度微损
        │
        └─► 内存受限但有高速 NVMe ──► DiskANN / SPANN 磁盘图索引   ──► 仅缓存航标,以 I/O 换内存
1. HNSW(分层可导航小世界图):速度与精度的王者,内存的黑洞
HNSW 是目前各大向量数据库支持最广、查询召回率最高(通常 > 98%)的索引算法。它的核心思想类似于跳表(Skip List):在低维多层图上进行快速跨步跳跃定位目标区域,在底层精细图上进行收敛寻优。
- 优势:查询响应时间极快(通常在数毫秒至十毫秒内),且对数据动态写入具有较好的追加兼容性。
- 代价:构建索引时 CPU 计算开销高,最致命的是其对内存的额外放大。构图过程中,每个向量不仅需要存储本身的浮点数组,还需要存储各个图层中双向邻居节点的指针列表。若内存不足以全量容纳该图结构,频繁的磁盘 Swap 换页会导致检索耗时暴涨上百倍。
2. IVF-FLAT(倒排文件):轻量实用的折中方案
IVF 的原理是先利用 K-Means 等聚类算法将空间划分为若干个聚类中心(Voronoi 单元格)。查询时,先找出距离最近的几个中心点,随后仅在对应分桶的候选列表中进行精细余弦计算。
- 优势:内存开销低(只需存储中心点及原向量,无需维护庞大的多层网络拓扑),建索引速度比 HNSW 快数倍。
- 代价:如果目标候选向量分布在聚类边界边缘,若探测分桶数(
nprobe)设置偏小,召回率会出现明显下滑;若加大nprobe,查询耗时又会线性增长。
3. 量化技术(Quantization):以 2%~5% 的精度微损换取 70%+ 的内存削减
面对大规模生产数据集,如果不进行量化,单机内存将极快耗尽。主流数据库提供两种量化方式:
- 标量量化(Scalar Quantization, SQ8):将每个 32 位的浮点数(Float32)线性映射缩放到 8 位有符号整数(INT8)。原始向量体积瞬间缩小为原来的四分之一(压缩率 75%),现代 CPU 还可以利用整数 SIMD 指令进行超高速距离运算。
- 乘积量化(Product Quantization, PQ):将高维向量切分为多个子向量空间,在每个子空间内聚类生成码本(Codebook),最终单条向量仅保存各子空间的聚类中心索引。压缩比甚至可达 90% 以上,但精度损失较 SQ8 更为明显,通常适用于粗排初筛阶段。
4. DiskANN:以高速 NVMe 硬盘打破“内存买不起”魔咒
当向量规模进入数千万至数亿级别时,将全量图索引放在内存中的成本难以承受。以 DiskANN 为代表的算法采用混合存储架构:将核心导航关键节点(Compress Index)保留在内存中,而将绝大多数稠密向量与图边结构存放在 NVMe SSD 上。
利用现代 NVMe 固态硬盘高吞吐、随机读取延迟极低(微秒级)的硬件特性,DiskANN 可以在单台配备大容量 NVMe 的物理服务器上,以不到纯内存方案 1/5 的硬件成本支撑上亿向量的高精度检索,仅带来个位毫秒级的 I/O 增加。
四、选型决策漏斗:4D 场景评估模型
面对具体业务需求,技术团队可以通过以下四个维度的决策漏斗快速锁定最优方案:
         [业务需求进入]
                │
                ▼
┌──────────────────────────────┐
│ 维度 1:数据规模 (向量总条数)  │
└──────────────┬───────────────┘
               ├─► < 50万: 优先 In-Process (LanceDB) 或 既有关系库 (pgvector)
               ├─► 50万 ~ 500万: 优先 pgvector 或 Elasticsearch
               └─► > 1000万: 考虑 Qdrant / Milvus / DiskANN 架构
               │
               ▼
┌──────────────────────────────┐
│ 维度 2:数据一致性与事务要求  │
└──────────────┬───────────────┘
               ├─► 强事务要求、频繁更新删除、严格防越权 ──► 首选 pgvector
               └─► 静态知识库、离线建索、允许最终一致 ──► 专用向量库或搜索引擎
               │
               ▼
┌──────────────────────────────┐
│ 维度 3:混合检索 (文本+向量)  │
└──────────────┬───────────────┘
               ├─► 强依赖专有名词、行业术语、精准型号匹配 ──► 首选 Elasticsearch / OpenSearch
               └─► 纯语义泛化理解占绝对主导 ────────────► 专用向量库
               │
               ▼
┌──────────────────────────────┐
│ 维度 4:团队运维与治理成本    │
└──────────────┬───────────────┘
               ├─► 无专职 DBA/SRE、追求极简可维护性 ──► pgvector / LanceDB
               └─► 具备成熟 K8s/分布式中间件运维体系 ──► Qdrant / Milvus
关键分水岭详解:单阶段过滤(Single-Stage Filtering)能力
在选型中必须重点考量数据库如何处理带有元数据过滤条件的检索。传统方案往往存在致命缺陷:
- 后过滤(Post-filtering):先用纯向量索引召回 Top-100 个语义相似项,然后再通过业务 WHERE 条件进行过滤。如果符合该过滤条件的数据非常稀疏(例如只占全库 1%),Top-100 里可能只有 1 条甚至 0 条满足要求,导致最终返回给大模型的结果严重缺失。
- 先过滤(Pre-filtering):先在元数据索引中筛选出符合条件的所有文档 ID 集合,随后只在这些 ID 构成的子集上执行向量距离比对。若子集数量仍然很大且无法命中预建的向量图路径,检索性能会急剧恶化。
- 单阶段图遍历(Single-Stage Graph Traversal):现代成熟的向量引擎(如 Qdrant 的 Filtered HNSW、pgvector 的 Iterative Index Scan)在遍历 HNSW 图节点的过程中实时评估元数据约束,既不破坏图的导航连通性,又确保候选点绝对符合业务过滤条件。在选型调研时,务必确认目标组件是否具备此能力。
五、主流方案实战代码模式与工程范式
为帮助团队直观感受不同流派的编码与查询范式,下面展示两个最主流方向的生产落地参考实现。
范式 1:PostgreSQL + pgvector 的高可用与精准过滤查询
对于绝大多数企业级 RAG 知识库,利用 PostgreSQL 作为单一事实源(Single Source of Truth)是工程确定性最高的做法。
-- 1. 启用扩展并创建包含向量与业务元数据的复合表
CREATE EXTENSION IF NOT EXISTS vector;

CREATE TABLE document_chunks (
    id BIGSERIAL PRIMARY KEY,
    document_id VARCHAR(64) NOT NULL,
    tenant_id VARCHAR(32) NOT NULL,
    is_published BOOLEAN DEFAULT true,
    content TEXT NOT NULL,
    embedding VECTOR(1536),           -- 对应 OpenAI 或开源模型维度
    created_at TIMESTAMP WITH TIME ZONE DEFAULT CURRENT_TIMESTAMP
);

-- 2. 针对高频过滤字段建立常规 B-Tree 索引
CREATE INDEX idx_chunks_tenant_status ON document_chunks(tenant_id, is_published);

-- 3. 构建 HNSW 向量索引(设置适当的 m 与 ef_construction 权衡构图质量)
-- m: 每个节点的最大边数(默认 16,大库可设为 24-32 提升召回)
-- ef_construction: 构图时的候选列表大小(调大可提升索引质量,但延长建索耗时)
CREATE INDEX idx_chunks_embedding_hnsw ON document_chunks
USING hnsw (embedding vector_cosine_ops)
WITH (m = 16, ef_construction = 64);

-- 4. 生产环境执行查询:动态调整单次会话的搜索深度 (ef_search) 并附带严苛 Pre-filtering
SET LOCAL hnsw.ef_search = 40;  -- 平衡查询响应耗时与召回率(默认 40)

SELECT
    id,
    content,
    1 - (embedding <=> '[0.012, -0.023, ... , 0.089]') AS cosine_similarity
FROM document_chunks
WHERE
    tenant_id = 'org_enterprise_01'
    AND is_published = true
ORDER BY
    embedding <=> '[0.012, -0.023, ... , 0.089]' ASC
LIMIT 5;工程要点:通过
SET LOCAL hnsw.ef_search,可以在低并发、对召回率极度敏感的场景临时调大该值;而在高峰期降级该值以保证系统吞吐稳定。全部查询在一个连接内完成,零跨系统网络延时,权限与数据完全受控。
范式 2:混合检索通用算法——倒数排名融合(RRF)
在实际检索时,单纯依靠语义稠密向量容易在搜专有名词(如订单编号 SO-20261028-98、芯片型号 STM32F407)时发生语义漂移。将 BM25 词法得分与 Dense Vector 得分进行 RRF 融合是业界通用标准:
from typing import List, Dict, Any

def reciprocal_rank_fusion(
    dense_results: List[Dict[str, Any]],
    lexical_results: List[Dict[str, Any]],
    k: int = 60
) -> List[Dict[str, Any]]:
    """
    倒数排名融合算法 (Reciprocal Rank Fusion, RRF)
    :param dense_results: 向量检索召回列表,按语义距离从近到远排序
    :param lexical_results: BM25/分词检索召回列表,按关键词相关度从高到低排序
    :param k: 平滑常数,默认 60(防止靠前排名的权重差距过大)
    :return: 重新打分排序后的综合推荐列表
    """
    scores: Dict[str, float] = {}
    doc_map: Dict[str, Dict[str, Any]] = {}

    # 1. 累计稠密向量排名的倒数得分
    for rank, doc in enumerate(dense_results):
        doc_id = doc["id"]
        doc_map[doc_id] = doc
        scores[doc_id] = scores.get(doc_id, 0.0) + (1.0 / (k + (rank + 1)))

    # 2. 累计词法倒排排名的倒数得分
    for rank, doc in enumerate(lexical_results):
        doc_id = doc["id"]
        if doc_id not in doc_map:
            doc_map[doc_id] = doc
        scores[doc_id] = scores.get(doc_id, 0.0) + (1.0 / (k + (rank + 1)))

    # 3. 按融合总分降序排序
    sorted_docs = sorted(scores.items(), key=lambda item: item[1], reverse=True)

    fused_results = []
    for doc_id, final_score in sorted_docs:
        item = doc_map[doc_id].copy()
        item["rrf_score"] = round(final_score, 6)
        fused_results.append(item)

    return fused_results
六、向量数据库落地的 5 大经典反模式与避坑指南
结合生产一线故障复盘,技术团队在落地向量数据库时应时刻警惕以下 5 个误区:
误区 1:在数据量不足 10 万时过早引入分布式独立集群
现象:业务刚刚起步,系统总切片数量仅几万条,架构师便引入了依赖众多的分布式 Milvus 或自建复杂向量中间件。
后果:业务功能尚未成熟,团队的大量精力却消耗在维护 etcd 选举失联、MinIO 磁盘写满、消息队列堆积和 K8s Pod 异常退出的运维泥潭中。
治理建议:先用轻量方案(pgvector 或 LanceDB)快速验证业务闭环。对于绝大多数垂直业务,几十万切片在单机 pgvector 下加持 HNSW 即可提供毫秒级响应,完全无需分布式架构。
误区 2:忽视 Embedding 维度对内存与存储的倍数放大
现象:选用了输出 3072 维或 4096 维的高维大模型,却未对存储容量做任何前置推演。
后果:单条向量占用字节数成倍上涨,HNSW 索引体积失控膨胀,直接导致集群节点内存 OOM 崩溃。
治理建议:
- 评估具有降维能力(Matryoshka Representation Learning, MRL)的模型(如可以在保证 99% 表现的同时截断为 512 维或 768 维);
- 及时开启 SQ8 标量量化,以微小精度牺牲换取内存的四倍解脱。
误区 3:把向量数据库当全能关系库使用
现象:为了省事,把全量的用户画像、订单变动、权限列表直接作为向量库的 Payload / 元数据字段随意存储,并在向量库上执行高频的点查与复杂的跨属性更新。
后果:向量数据库的底层存储格式通常针对向量高维计算优化,其事务写放大非常严重,高频更新导致索引碎片化,检索性能急剧衰退。
治理建议:明确存储职责分工。向量数据库仅存放 doc_id、核心过滤字段与向量本身;完整的业务明细、变动频繁的业务状态一律回表到主数据库查询。
误区 4:完全忽略全库重向量化(Re-embedding)的技术负债
现象:业务上线一年后,底层开源大模型或嵌入模型推出了效果大幅提升的新版本。团队准备升级模型,却发现旧向量库无法直接使用新模型向量(不同模型的嵌入空间完全异构,数学上无法混合度量)。
后果:由于历史切片与原始文本割裂,缺乏全量重新嵌入的版本管道设计,导致模型升级变成停机重建的灾难工程。
治理建议:架构设计初期必须建立版本化向量集合机制(例如 collection_v1_bge_base、collection_v2_bge_m3),并保留原始文本切片的数据管道,支持在后台离线双写平滑重构。
误区 5:脱离重排序(Reranker)空谈检索召回
现象:团队不断调优向量数据库的 Top-K 召回参数,试图把 Top-K 从 5 改为 50,直接喂给大模型。
后果:过多非直接相关的切片不仅浪费大模型上下文窗口(Context Window),还会引发大模型的“迷失在中间(Lost in the Middle)”幻觉,不仅没有提升准确率,反而大幅增加推理时延与 Token 开销。
治理建议:采用标准的“粗排(向量检索 Top-20)+ 精排(Cross-Encoder Reranker 重排序选出 Top-3~5)”两阶段漏斗架构,这是提升 RAG 质量最具性价比的方案。
七、生产上线安全与工程准则自检清单
在向量检索模块正式切流至生产环境前,建议对照以下 12 项工程指标逐一核验:
| 序号 | 检查维度 | 具体检查项目与准入标准 |
|---|---|---|
| 01 | 容量预估 | 是否按 向量条数 × 维度 × 4字节 × 2倍构图系数 完成物理内存底线测算? |
| 02 | 硬件机型 | 运行节点是否开启了 CPU 向量指令集支持(AVX-512、AVX2 或 ARM NEON)? |
| 03 | 索引构建 | 向量索引是否已完全构建完毕?(避免冷启动阶段并发查询全表暴力扫描) |
| 04 | 多租户隔离 | 租户级数据隔离是否具备硬约束?(物理 Collection 隔离或强行推下租户 ID 过滤) |
| 05 | 单阶段过滤 | 是否已验证包含稀疏元数据过滤条件下的检索延迟,确认无后过滤截断失效? |
| 06 | 量化评估 | 是否在标准测试集上比对过 SQ8/PQ 量化前后的 Top-K 召回率偏差(确认在容忍阈值内)? |
| 07 | 连接池治理 | 应用程序到向量库的连接池配置是否设置了合理的空闲超时与最大活跃上限? |
| 08 | 混合检索对齐 | 若开启 BM25 + 向量检索,是否采用了标准化的分词器与科学的融合打分权重(如 RRF)? |
| 09 | 重排层降级 | 下游 Reranker 模块发生网络抖动或超时时,是否具备直接降级使用向量粗排结果的兜底机制? |
| 10 | 备份与快照 | 是否建立了每日定期的向量索引快照或元数据 WAL 持续归档机制? |
| 11 | 监控与告警 | 是否对 P99 检索耗时、内存使用水位、慢查询(>200ms)及命中数为 0 的异常设置了告警? |
| 12 | 版本演进路径 | 是否规划了底层 Embedding 模型升级时的并行索引构建与无缝流量切流方案? |
八、总结:构建演进式检索架构
向量数据库的选型,从来不是一场比拼谁参数更前沿的“军备竞赛”,而是在既有技术栈与真实业务规模约束下寻找最佳平衡点的工程艺术。
- 如果是企业内部知识库、工单客服、中后台业务(数据量在 100 万以内):毫无疑问首选 PostgreSQL + pgvector。它能帮你挡掉 90% 异构系统同步与双写灾难,让你把精力集中在真正决定 RAG 质量的切片切分、清洗与提示词工程上。
- 如果是桌面离线端、本地原型、数据分析环境:选择 LanceDB 或 Chroma,零依赖、单文件,开发体验行云流水。
- 如果是已有成型搜索体系、需要兼顾商品/文档分词与向量混合召回:直接沿用或升级 Elasticsearch / OpenSearch,最大化复用既有索引资产与权限隔离设施。
- 如果是面向亿级规模的公有云 SaaS、多租户开放平台或视觉音视频搜索:果断选用 Qdrant 或 Milvus,利用专业分布式架构与硬件加速支撑高吞吐流量。
从最小可用架构起步,保持数据切片管道的清晰与版本化,随着业务量级的跨越自然演进,才是技术基建长治久安的最优解。
本文由 TypeTube 团队原创深度整理。如果你在向量数据库选型、RAG 检索流水线调优或企业级 AI 架构落地中遇到具体性能瓶颈与架构疑问,欢迎前往我们的 联系与交流页面 共同探讨。